Reuseio:为 AI 时代重新定义"软件复用"的注册中心
TL;DR
一个面向开发者与 AI 的软件能力注册中心。它不替你写代码,而是让 AI 在动手之前,先看见已经存在的世界。
一个面向开发者与 AI 的软件能力注册中心。它不替你写代码,而是让 AI 在动手之前,先看见已经存在的世界。
一、我们正重复发明轮子
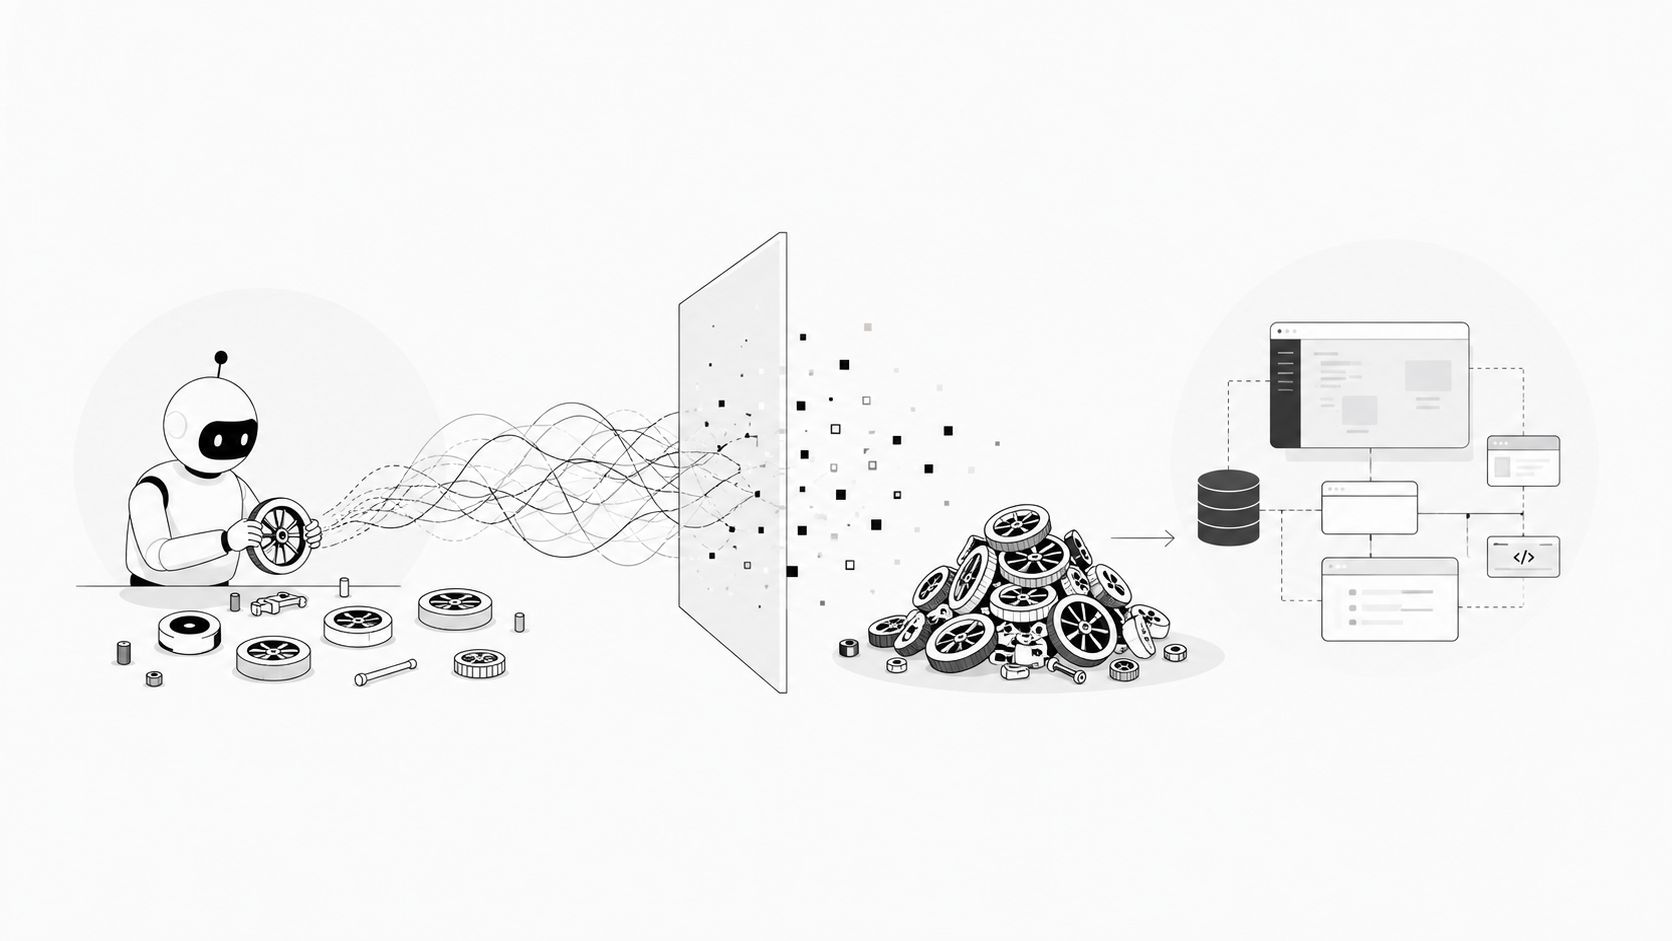
软件开发历史上最大、也最隐蔽的浪费,不是 Bug,而是重复造轮子。
当一个开发者想为产品加上「对象存储」「支付」「邮件发送」「OCR」这类能力时,他面对的真实局面往往是:
- 不知道市面上早有成熟方案;
- 知道几个名字,却搞不清各自的能力边界、价格、限制和兼容环境;
- 即使查到了,也分不清官网文档、社区博客、营销文案哪一句才算数;
- 于是,很多团队选择「自己写一个」,或者在一个并不合适的库上叠床架屋。
这个问题在 AI Coding 时代被放大了。
Claude Code、Codex、Cursor、Gemini CLI 这类 AI 编程助手正在成为主流生产力。它们的倾向是:一旦被要求实现某个功能,就会直接生成代码。但 AI 默认并不知道「现在世界上已经有哪些可用的软件能力」——它只能依靠训练记忆里的常识去猜测。结果是:AI 也会「重复造轮子」,而且它造出来的轮子往往没有来源、无法追溯、也无法验证。
这正是 Reuseio 要解决的问题。
Reuseio 的核心目标不是替代 AI 做技术判断,而是为 AI 和开发者提供真实、结构化、可追溯的软件能力信息,让 AI 在开发产品之前能够优先发现和复用已有方案,减少重复开发。
二、Reuseio 是什么?
Reuseio 是一个面向开发者与 AI 的软件产品、软件能力与接入方式注册中心。
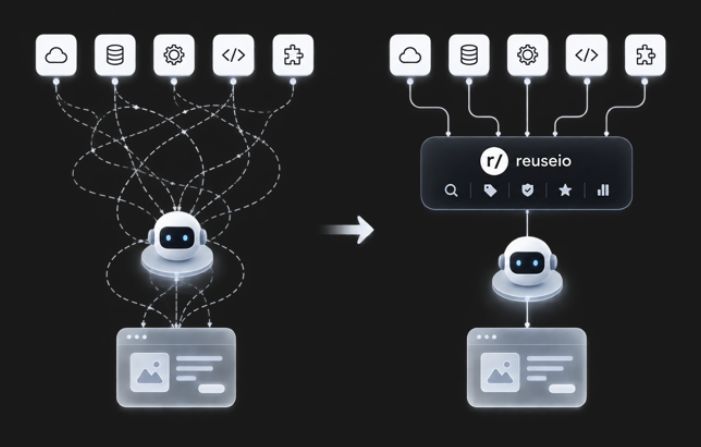
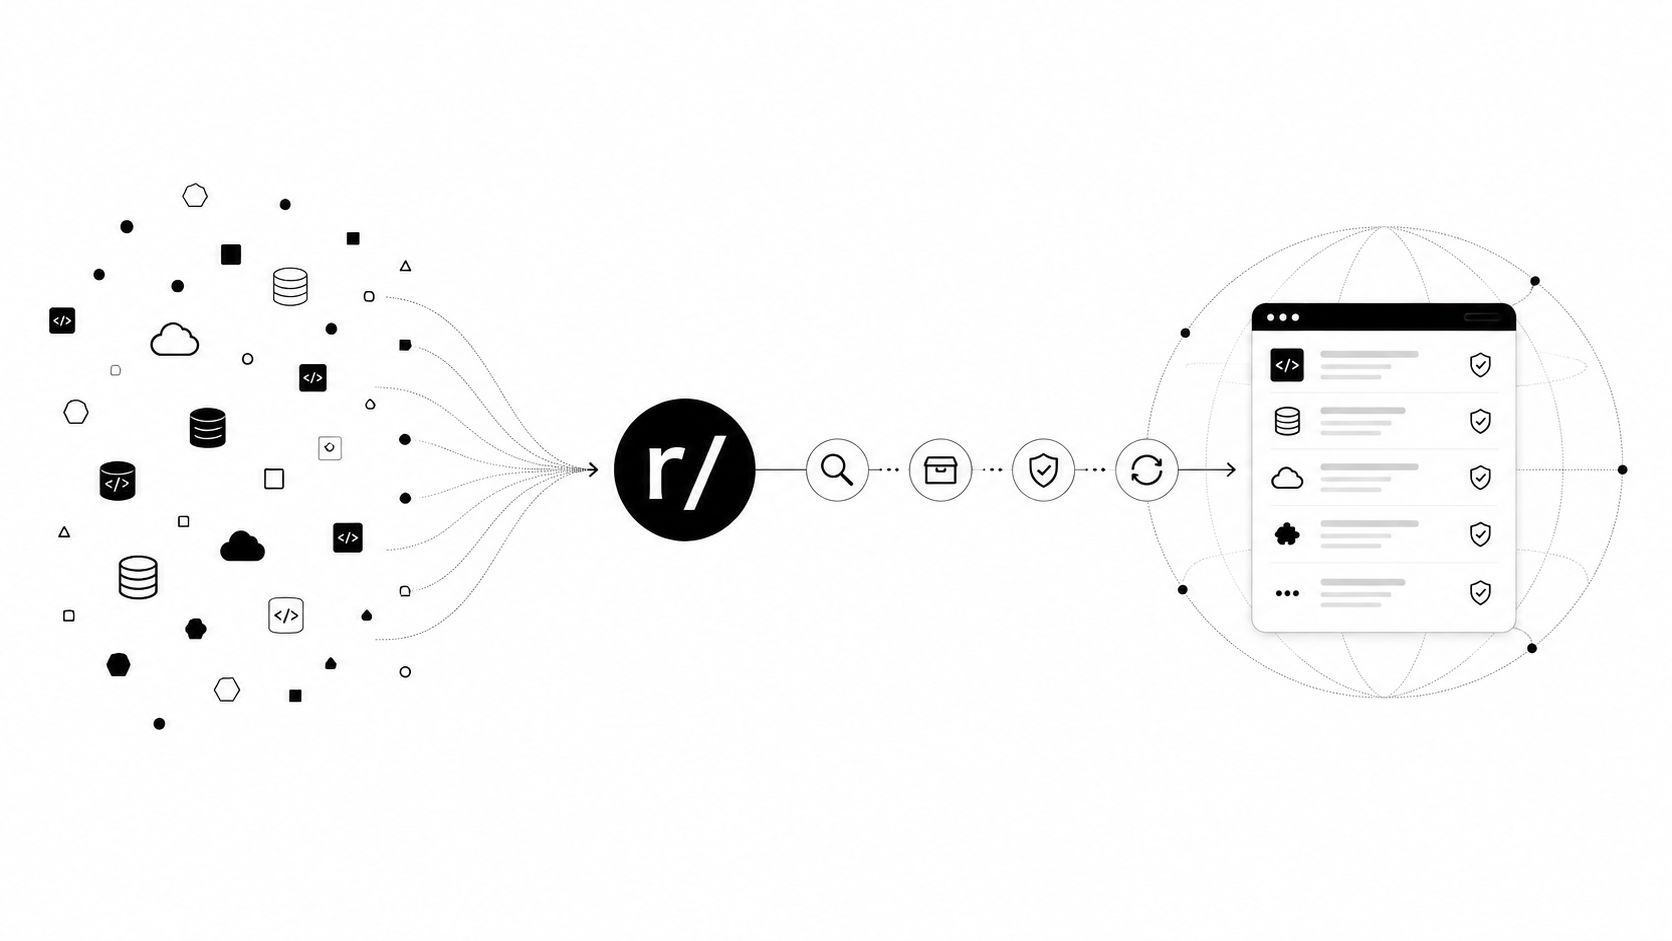
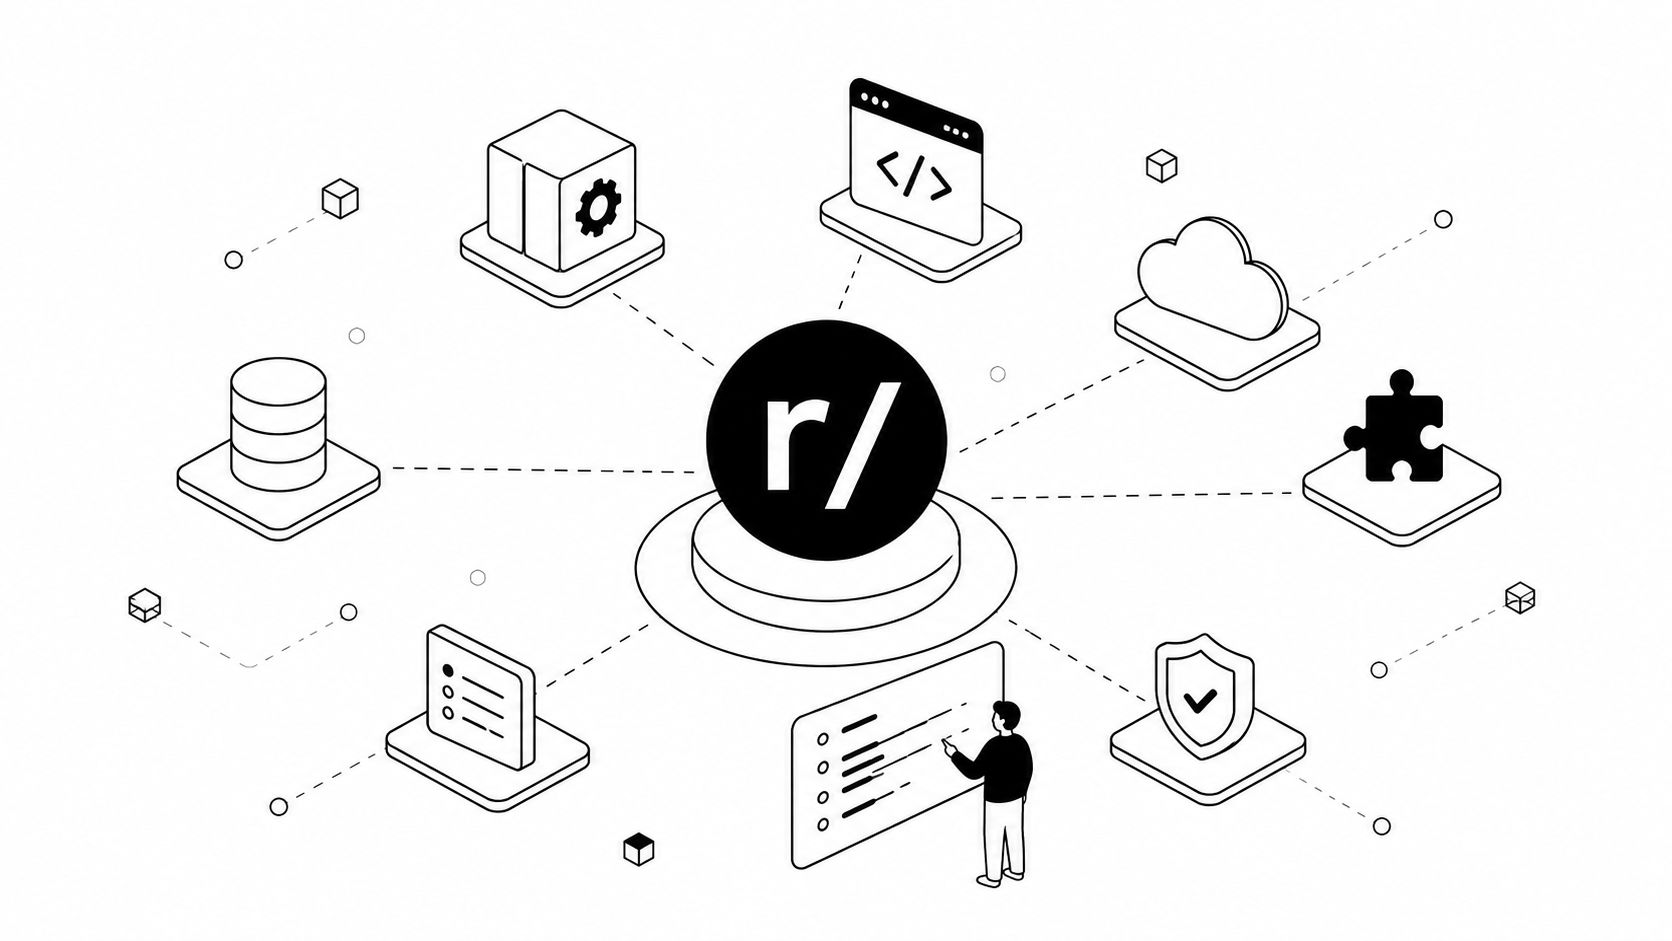
它统一收录 API、SDK、MCP Server、Skill、CLI、SaaS、开源项目、Runtime 等软件能力,并通过四种形态对外提供一致访问:
Reuseio
├ 前台网站       (浏览 / 搜索 / 详情 / 来源 / 机器可读入口)
├ Public REST API(无需 Key,机器与 Agent 可自由检索)
├ Reuseio Manifest(统一描述格式 reuseio.json)
└ npm SDK + Skill (让 AI Agent 与脚本更方便读取 Registry)
它的野心不在于"再做一个开发者导航站",而在于成为软件世界的"事实层"——一个持续更新、可被机器读取、且每个事实都标明了出处的 Registry。
三、软件开发的范式转移
Reuseio 背后有一个清晰而坚定的信念:未来的软件开发流程,会从"理解需求后直接写代码",逐步转向"先发现、再组合"。
旧范式:
理解需求
  ↓
直接编写代码
新范式:
理解需求
  ↓
识别所需能力
  ↓
发现已有软件
  ↓
验证能力与来源
  ↓
组合已有方案
  ↓
仅开发缺失部分
在这个新范式里,Reuseio 只承担其中关键的两步:
发现已有软件
  +
提供可信的软件能力数据
它不负责最终技术决策。最终选择由用户,或由用户正在使用的 AI Agent 完成。
这是一个克制的设计哲学:Reuseio 把自己定位为"地基"而非"大脑"。地基必须坚实、诚实、可被审计;大脑留给真正使用它的人和他的 AI。
四、产品原则
Reuseio 不是又一个数据库。它的独特性来自四条贯穿始终的原则。
4.1 以 Product 为核心
Reuseio 的核心数据单位是 Product,而非 API 类型。
一个 Provider(提供方)可能拥有多个 Product。例如 Cloudflare 旗下有 Workers、R2、D1、KV、Images、Turnstile 等多个相互独立的产品。Reuseio 把它们作为独立、可被单独检索和复用的 Product 来建模,而不是塞进一个笼统的"Cloudflare"条目里。
Product 的类型涵盖:API、SDK、MCP、Skill、CLI、SaaS、Service、Runtime、Library、Open Source、Other。一个 Product 既可以是 Stripe Billing 这样的大块服务,也可以是 Playwright MCP 这样一个具体的接入能力。
4.2 Capability 独立建模
Capability(能力) 是 Product 能够完成的正式软件能力,例如 Authentication、Object Storage、Payment Processing、OCR、Email Sending、Image Generation、Web Search。
Product 与 Capability 是多对多关系:一个 Product 支持多种能力,一种能力也可由多个 Product 实现。这种建模让"按能力找软件"成为可能——用户不必记住"S3 / R2 / OSS"这些名字,只需说"我要对象存储",Reuseio 就能列出所有候选。
关键约束:Capability 不使用自由文本临时创建。AI 在抽取中发现新能力时,只能生成候选,必须写入正式 Capability Registry 后才能使用。这避免了"同义词爆炸"和语义漂移。
4.3 事实必须存在来源
这是 Reuseio 最锋利的一条原则。
Reuseio 不允许 AI 凭经验补充事实。
AI 可以抽取、整理、分类、翻译、摘要、生成介绍、生成供 AI 使用的提示词。但 AI 不可以猜测价格、猜测兼容性、猜测运行环境、猜测 API 能力,也不能根据常识填写缺失字段。
对于未知信息,Reuseio 的态度明确而优雅:
使用 null
或明确显示"暂无可靠信息"
不能把"未知"视为 false。 不知道某产品是否支持 Cloudflare Workers,正确做法是 cloudflare_workers: null;错误地写成 false,会被下游 AI 当成"明确不支持"而错误排除。这一字之差,决定了 AI 选型的可信度。
4.4 数据优先于 AI
Reuseio 本身不承担复杂 AI 推理。它主要提供:
可信数据 + 统一 Schema + 搜索 + 来源 + 接入信息
而需求分析、能力拆分、产品比较、方案推荐、技术选型,全部交给用户自己的 Claude、Codex、Cursor、Gemini CLI 等 AI 完成。
这是一种"分权"思想:基础设施保持简单、稳定、可审计;智能留给离用户最近的那一层。Reuseio 因此不会变成一个黑盒推荐引擎,而是一块永远可被审查的"事实地基"。
五、一张可被机器读取的"软件世界地图"
Reuseio 用一组相互关联的核心实体,把混乱的软件世界编织成一张可追溯的图谱:
| 实体 | 作用 |
|---|---|
| Provider | 软件提供方(Cloudflare、Stripe、OpenAI…) |
| Product | 核心实体,可独立复用的软件能力单元 |
| Capability | 正式建模的能力(对象存储、支付…) |
| Tag | 受控分类(Runtime、Region、License、协议…) |
| Integration | 如何接入(REST / SDK / npm / MCP / CLI…) |
| Relationship | 产品间关系(depends_on / alternative_to / compatible_with…) |
| Source / Evidence | 事实的出处与字段级证据 |
所有这些实体最终汇聚到 Reuseio Manifest——一个统一的 reuseio.json 描述格式。它回答四个问题:这个软件是什么、能做什么、如何接入、事实来源是什么。
Manifest 背后的核心工程原则是:
One Registry   (一个注册中心)
One Schema     (一套统一结构)
Multiple Clients(多种客户端:网站 / API / npm / Skill / 未来 MCP)
同一套 Schema 驱动所有客户端,避免了"网站一套模型、API 另一套模型、SDK 再一套模型"的数据分裂。这保证了无论人类、Agent 还是搜索引擎,看到的都是同一个、一致的 Reuseio。
六、可追溯的事实体系:信任的骨架
让 Reuseio 区别于普通目录的,是它对**来源(Source)与证据(Evidence)**的执念。
每一条事实都必须能追溯到出处。Source 保存 URL、标题、来源类型、文本片段、抓取时间、内容 Hash、是否官方、可信等级。Evidence 则把字段级数据与具体来源绑定——例如 facts.runtime.cloudflare_workers 这个字段,可以直接指向 Cloudflare 官方文档中的对应原文片段。
由于不同产品的数据结构差异极大,Reuseio 用动态的 Product Facts(namespace.key.value)容纳非通用字段,如 pricing.free_tier、runtime.cloudflare_workers、authentication.methods、limits.max_file_size。而所有 Product Fact 都必须绑定 Source——没有来源的事实,不得发布。
这种"字段级可审计"的设计,让下游的 AI 在做出技术判断时,能够带上证据 URL 回到官方文档核实,而不是轻信一个二手摘要。
七、自动化,但不失严谨
Reuseio 的设计目标之一是尽可能减少人工维护。它通过一套自动化的数据流,把互联网上的软件信息持续转化为可信 Registry:
Discover(发现)
  ↓
Crawl(抓取官方资料)
  ↓
Extract(抽取有效信息)
  ↓
AI Normalize(AI 标准化)
  ↓
Validate(验证)
  ↓
Publish(发布)
这条流水线有几个值得强调的工程取舍:
- 自动发布,无需人工审核。 通过 Validator 的正常数据直接发布;管理员只在事后处理异常、错误、重复和下架。
- AI 负责整理,来源负责事实。 在收录判断(valid / spam / abandoned 等)上允许 AI 推理,但 AI 绝不因此生成任何 Product 事实。
- 失败隔离。 任一 Product 抓取失败、任一 Source 失败,都不能拖垮整条流水线。
- 成本控制。 仅当内容 Hash 变化时才重新调用 AI;纯搜索、纯读取 API 绝不触发 LLM。
- 尊重来源。 爬虫遵守 robots.txt、控制并发、带明确 User-Agent(
ReuseioBot/1.0),不对官方文档站制造压力。
理想状态是:管理员提供少量初始 Seed 后,系统能够持续自行发现、抓取、整理、验证、发布、更新,人只处理例外。
底层已经验证可端到端运行:本地验收中,Cloudflare 开发者平台被抓取、经 Kimi 标准化,自动发布为 18 个独立 Product(Workers、R2、D1、Workers AI、Queues、Durable Objects、SDK、Wrangler CLI 等),无泛化的"伞型"条目。
八、清晰的人机边界
Reuseio 最有纪律感的地方,是它清楚地划出了"我做什么、我不做什么"。
Reuseio 负责:
Discover(发现)     Describe(描述)
Structure(结构化)  Reference(给出来源)
Reuseio 不负责:
Decide(决策)        Execute(执行)
Proxy(代理请求)     Bill(计费)
Store Credentials(托管密钥)
这意味着 Reuseio 不代理任何第三方 API、不托管用户密钥、不做统一调用网关。在 Phase 4 的设想中,Reuseio 可以返回标准化的第三方调用描述,由用户自己的 Agent 直接连接 Provider——它始终是"指路人",而不是"代驾"。
边界同样体现在产品功能上:v1 明确不做用户注册、收藏、评论、评分、AI Chat、AI 推荐 API、向量搜索、统一代理等。它刻意保持"薄"——把智能和决策留给使用它的人。
九、为 AI 原生而设计
Reuseio 从第一天起就为 AI Agent 而设计,而非事后补救。
每个 Product 页面都提供"用于 AI"的一键复制提示词。 这份 Prompt 不仅包含产品能力、官方文档、Integration、运行环境、认证信息与重要限制,还明确约束 Agent:
优先依据官方文档实施。
不得将 Reuseio 中缺失的信息自行视为支持。
如果某项事实没有明确来源,应进一步检查官方文档。
POST /api/v1/research 接口 为 Agent 提供任务级检索上下文:你传入一个任务描述和一组能力词,它返回候选产品、匹配的 Manifest、官方来源与实现约束。接口刻意保持 LLM 中立——它不替你做最终技术决策,只把"带证据的事实"交还给你。
npm SDK(reuseio) 极薄,只暴露 search()、getProduct()、getCapability()、getManifest()、researchTask(),让 Agent 在代码里直接读取 Registry,不内置 LLM、不分析用户代码。
Reuseio Skill 不保存 Product 数据,只描述工作流:
读取需求 → 拆分能力 → 查询 Reuseio → 读取 Manifest
→ 检查 Evidence → 比较候选 → 选择方案 → 依据官方文档实施
AI 自己负责需求理解与最终推荐。Reuseio 提供"路"和"路标",方向由行驶者决定。
此外,Reuseio 还重写了文档抓取:把官方文档站作为有界的多页爬取,做语义化正文提取、标题层级、链接评分与官方来源信任加权,让详情页的事实真正来自官方,而非营销话术。
十、实现现状与演进路线
Reuseio 并非纸上谈兵。基于 progress.md,v1 的核心能力已经落地:
- Nuxt 4 + Vue 3 + Tailwind 的 SSR 前台,响应式亮/暗主题,中英文界面持久化;
- Supabase PostgreSQL 的 Registry、Evidence、Discovery、Crawl Jobs 完整迁移;
- Public REST API v1(products / providers / capabilities / tags / search / sources / evidence / manifest / ai-prompt / research);
- 共享的 Manifest v1 映射器与受证据约束的 AI Prompt 生成器;
- Srces Auth 鉴权后台(
/admin),fail-closed 的受保护接口; - Cloudflare Cron + Queue 驱动的爬虫、Kimi 标准化队列、确定性证据校验与事务化发布;
- 端到端本地验收通过,并补回 GitHub 仓库/README 的采集与 Star、语言过滤的发现流程;
- 轻量无依赖的
sdk/与 workflow-only 的skill/reuseio-registry/。
四阶段演进路线:
Phase 1  Registry / Website / Crawler / Public API / Manifest / npm / Skill
Phase 2  扩大数据源 / 完善 Capability Graph / MCP Server / 第三方 Registry 接入
Phase 3  统一软件能力描述标准 / Execution Metadata / Agent Integration
Phase 4  返回标准化第三方调用描述,由用户 Agent 直连 Provider(不托管密钥、不代理请求)
十一、Reuseio 的长期资产
构建一个持续更新、可追溯、机器可读取的软件世界 Registry。
它不追求替你思考,也不承诺替你决策。它要做的,是在 AI 与开发者动手之前,先把"世界上已经存在什么、各自能做什么、依据从哪来"这件最基础也最被忽视的事,做得诚实、结构化、可审计。
在一个 AI 可以瞬间生成海量代码的年代,真正的稀缺资源不再是"写下代码的能力",而是判断该不该写、该复用哪一行的能力。Reuseio 正是为这种判断提供地基——让"复用"成为默认,让"重复造轮子"成为需要理由的例外。
这,就是 Reuseio 想为软件世界留下的长期资产。