Agentic Debt:重复造轮子已成系统性现象
TL;DR
AI Agent在软件开发中“重复造轮子”的现象,是其底层技术架构与真实软件工程环境之间一系列结构性冲突的必然结果。
AI Agent在软件开发中“重复造轮子”的现象,是其底层技术架构与真实软件工程环境之间一系列结构性冲突的必然结果。
重复造轮子已成系统性现象
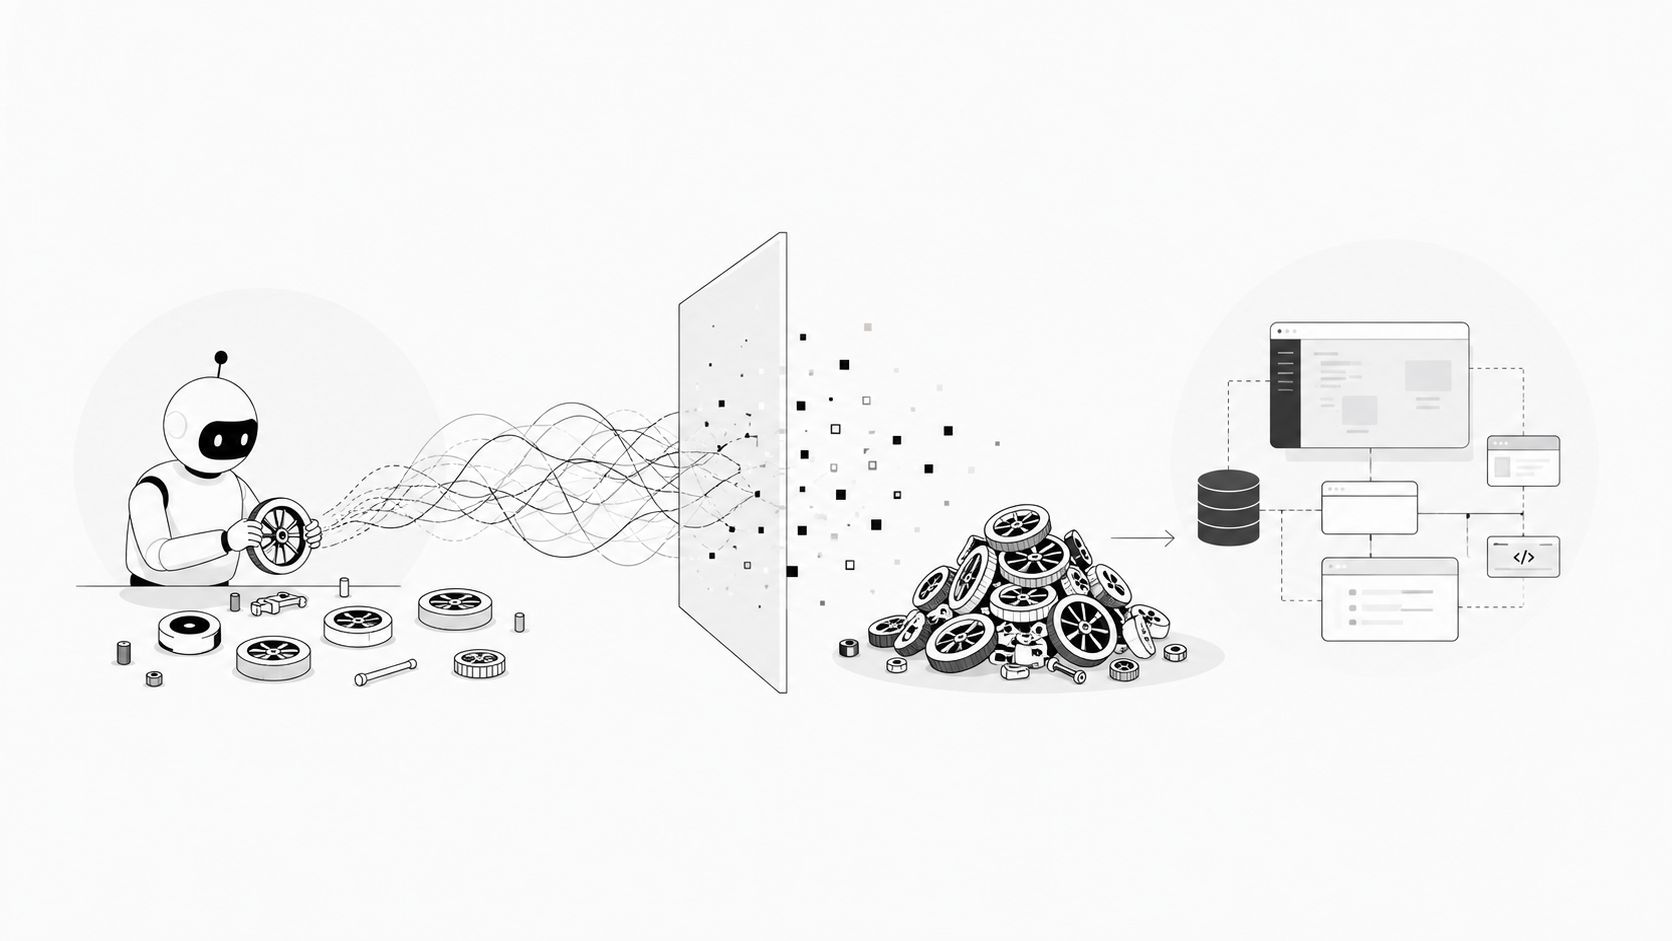
2026年1月发表的一项纵向研究,综合分析了2020至2025年间AI驱动开发的代码演化数据,揭示了令人警惕的趋势:与2021年基线相比,AI生成的代码中代码重复率增加了4倍(违反DRY原则),代码变动率(code churn)翻了一番。
该研究同时指出,尽管AI将最小可行产品(MVP)的开发速度提升了40%至60%,但超过51%的AI撰写代码存在安全漏洞,开发者调试AI生成逻辑的时间反而增加了19%。研究者将这种现象定义为 “Agentic Debt” ——自主Agent在缺乏人类上下文监督的情况下进行仓库级修改所积累的隐藏成本。
另一项被MSR 2026接收的学术研究,通过实证分析证实:“LLM Agent经常忽视代码复用机会,与人类开发者相比导致了更高水平的冗余”。
该研究的情感分析发现,评审者对AI生成的代码贡献倾向于表达更中性或积极的情绪,而非像对待人类代码那样持批判态度——这意味着AI代码在表面上的“合理性”掩盖了其冗余,导致技术债务在真实开发环境中悄然累积。研究量化了这一差距:
Agent提交的拉取请求携带的语义冗余约为人类开发者的1.87倍。
无状态架构导致“每次会话从零开始”
AI Agent“健忘”的根源在于其底层架构约束。大语言模型的权重在训练后即被冻结,无法在对话期间将项目特定知识写入参数。每次API调用都是一次全新的推理请求,完整对话历史被重新提交。会话结束时,所有上下文蒸发,因为默认没有任何工具将数据写入外部存储。
这一架构缺陷的直接后果是:每次新会话,Agent都像第一天入职的新员工。AI编码Agent能够阅读代码库、推理架构、编写生产级代码,但它们有一个根本性局限——不记得昨天学到了什么。每个会话都从零开始。来之不易的洞察蒸发殆尽。
多Agent系统面临更为严峻的“重复”困境。一篇发表于ICML的研究识别出重复token是LLM多Agent系统低效的主要贡献者,将其描述为一种阻碍可扩展性的 “通信税”(communication tax) 。每个子Agent每次调用都需要重新检索和构建上下文——一个子Agent进行多少次工具调用,就产生了多少次冗余的Agent检索调用。
上下文窗口容量限制
即便在同一个会话中,Agent对项目的全局感知也极其有限。当前大语言模型的上下文窗口虽已扩展至百万token级别,但企业级代码库的规模远超这一容量。在大型项目中,Agent往往会花费大量时间在读文件、搜索代码库、理解上下文,等到终于要开始改代码时,上下文窗口已经快满了——要么被迫提前结束,要么产出品质低下的代码。
随着上下文被各种报错日志、调试信息等“噪音”填满,关键信息被淹没,Agent更容易迷失,最终依赖训练时见过的通用模式而非项目内部已有的特定解决方案。
更棘手的是,即便使用目前最先进的模型,长会话仍可能陷入token重复循环。在Claude Opus 4.8上,长运行的Agent会话反复坍缩为token重复循环——模型开始不断重复“court”这个token,单条消息中最多重复达31,876次。相关Issue追踪到,在超过400k上下文的情况下,这种爆发事件的概率约为0.1%至0.4%。
规划与执行的系统性失效
Agent在长链条任务中的执行偏差,可通过具体案例得到清晰说明。Claude Code的一个公开Issue记录了一个典型失败场景:开发者在monorepo中为4个服务构建一个新功能,为每个任务分派了子Agent。所有子Agent均报告“完成”且构建通过,但实际结果产生了8个以上的集成bug:Admin路由挂载位置错误、API模式不匹配、代理路由缺失、字段名不一致等。
该Issue的根因分析指出:子Agent的提示模板说“遵循现有模式”,但这一指令过于模糊——Agent不知道应该读哪些文件,于是基于通用知识自行“发明”。编排Agent也未在标记任务完成前验证子Agent的输出是否与现有实现一致。开发者原本预计2小时完成的功能,最终耗费了5个多小时调试集成问题。
在多Agent并行协作场景中,问题被进一步放大。当多个AI Agent同时在同一代码库上工作时,它们彼此隔离运行——无法协调、共享上下文或预防冲突,导致合并冲突、重复劳动和不一致的实现。有开发者报告,同时运行四个Claude Code会话处理同一个monorepo的不同项目时,频繁出现文件锁定冲突和未提交变更的相互干扰。一项研究提出的CoAgent并发控制方案表明,即使经过专门优化,多Agent并行系统也只能将冲突率控制在5%以内——而在缺乏协调机制的情况下,这一比例可能更高。
结构性解决方案的探索
针对上述问题,业界已在多个方向展开探索。在记忆层面,各类持久化记忆方案正在涌现——从Oracle的AI Agent Memory到开源的mneme三层记忆架构,目标都是让Agent能够跨会话保留事实、任务状态和决策记录。在复用层面,组件索引机制被引入以推动Agent“先查索引→判断是否复用→命不中再新建”的流程。清华大学团队提出的AgentSquare框架通过模块化设计,据称在实验中将基础组件复用率从35%提升至82%,开发周期缩短40%。
在这些通用方案之外,一个更贴近“复用基础设施”的探索方向正在浮现——一个名为Reuseio的开源项目,试图从软件工程信息组织的底层逻辑出发,为AI Agent构建一张可被机器读取的“软件世界地图”。
Reuseio的核心判断与本文前述分析高度一致:AI Agent重复造轮子的根源之一,是它在动手之前“看不见”已有方案——大语言模型的训练记忆里只有过时的、碎片化的软件常识,而缺乏对当前软件生态的结构化、可追溯认知。
这些探索仍处于早期阶段。Gartner预计,到2027年底,超过40%的Agentic AI项目将被取消,原因正是不断攀升的成本和模糊不清的商业价值。AI Agent“重复造轮子”的问题,本质上不是一个可以通过简单优化提示词来解决的表面缺陷,而是需要在架构层面系统性补足记忆、认知与治理三大短板的深层工程挑战。
像Reuseio这样从信息基础设施层面着手的尝试,或许为这一挑战提供了一条可行的演进路径——让AI在动手之前先“看见”世界,让“复用”成为默认,让“重复造轮子”成为需要理由的例外。
如果你对Reuseio感兴趣,欢迎了解。