AI 编程为什么需要“证据链”?
TL;DR
从 diff、终端日志、测试和真实操作出发,解释 AI 编程 Agent 的完成声明为什么需要可复现证据。
AI 说“功能已完成”只是声明,真正可靠的结果还需要 diff、终端日志、测试结果和真实操作共同证明。本文解释不同证据能说明什么,以及如何设计任务收尾模板。
AI 编程 Agent 完成任务后,常常会给出一段很有把握的总结:“功能已实现,测试已通过。”但这句话本身只是声明,不是证据。真正值得信任的结果,应该能沿着一条证据链回看:它改了什么文件,执行了哪些命令,测试覆盖了什么,哪些步骤没有完成,最终行为是否符合需求。
证据链解决的是“它真的做了吗”
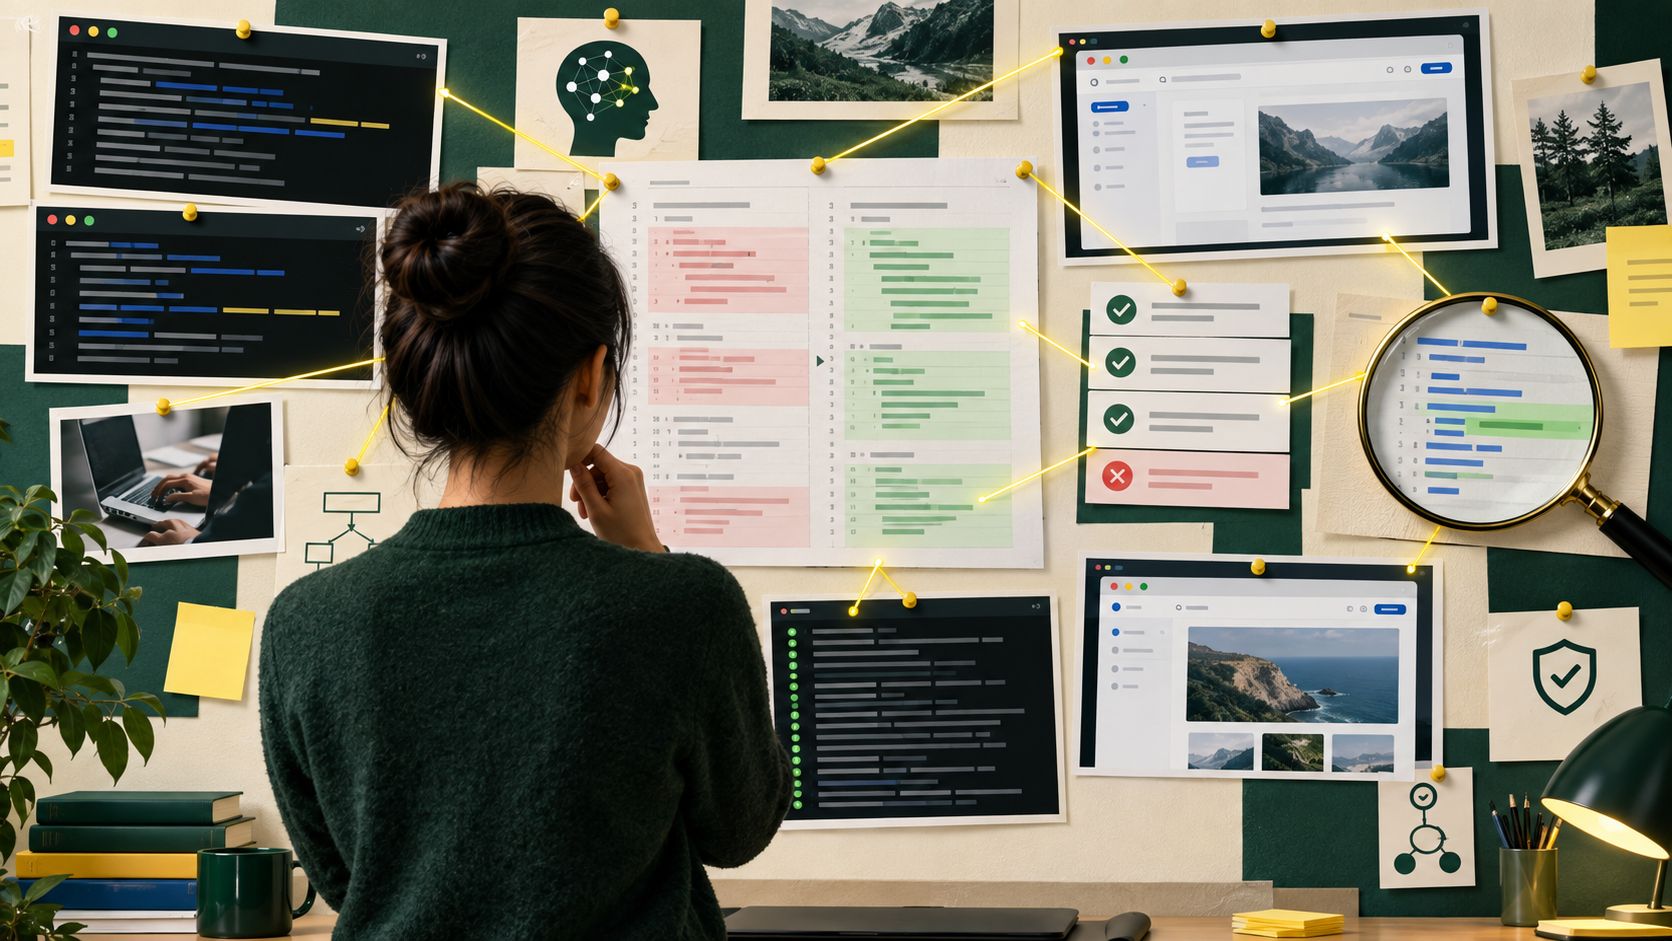
代码 diff 能证明文件发生了什么变化,却不能证明功能在真实环境中可用;终端日志能证明命令执行过,却不一定证明命令检查了正确路径;测试结果能证明断言通过,却不一定覆盖用户真正关心的行为。不同证据解决不同问题,不能用一类证据替代全部。
可以把结果拆成四层:
| 证据 | 能说明什么 | 不能单独说明什么 |
|---|---|---|
| 文件与 diff | 修改了哪些内容 | 修改是否符合需求 |
| 命令与日志 | 做过哪些执行 | 目标环境是否完全一致 |
| 测试与检查 | 某些条件下结果通过 | 未覆盖场景是否安全 |
| 真实操作与截图 | 用户路径是否可用 | 代码长期可维护 |
只有把这些信息放在一起,人才能判断“完成”是不是有充分依据。
为什么模型总结容易过度自信
模型倾向于把当前轨迹整理成一个连贯故事。如果某个命令超时、测试没有被发现,或者只运行了局部检查,它可能仍然把结果描述成“已验证”。这不一定是有意欺骗,而是语言生成天然倾向于给出完整结论。
因此,工作流要让工具返回结构化状态:命令退出码、测试数量、失败用例、修改文件、网络调用和等待中的任务。让 AI 引用这些结果,而不是让它凭记忆写总结。
一份适合 Vibe Coding 的任务收尾模板
任务结束时要求 Agent 回答:
- 需求中哪些部分已经完成?对应哪些文件和行为?
- 运行了哪些构建、类型检查、单元测试或浏览器测试?结果是什么?
- 哪些验证没有运行,原因是什么?
- 还存在什么假设、风险和待人工确认事项?
- 如果需要回滚,应该回退哪个提交或删除哪一组变更?
这份模板不等于质量保证,但能让不确定性显形。一个明确写出“没有运行生产数据迁移测试”的结果,通常比一句笼统的“全部完成”更有价值。
证据也可能被伪造或污染
测试日志可能来自错误的分支,截图可能展示了假数据,模型还可能修改测试让结果变绿。高风险任务需要把检查放在 Agent 难以随意改动的环境中,并由独立流水线重新运行。证据最好由工具直接产生,关键结论要能被人复现。
OpenAI 对 coding agent 的设计强调终端日志、文件引用和测试结果,就是为了让用户可以验证过程,而不是只接受最终文本。对任何工具都适用的原则是:声明要有证据,证据要能复现,无法验证的部分要明确标记为未知。