如何为海量软件项目做「可追溯的分类整理」
TL;DR
Reuseio 用机器自动维护数据流程,让来源决定事实,平台内置 AI 负责整理,用户 Agent 结合实际项目判断。
Reuseio 用机器自动维护数据流程,让来源决定事实,平台内置 AI 负责整理,用户 Agent 结合实际项目判断。
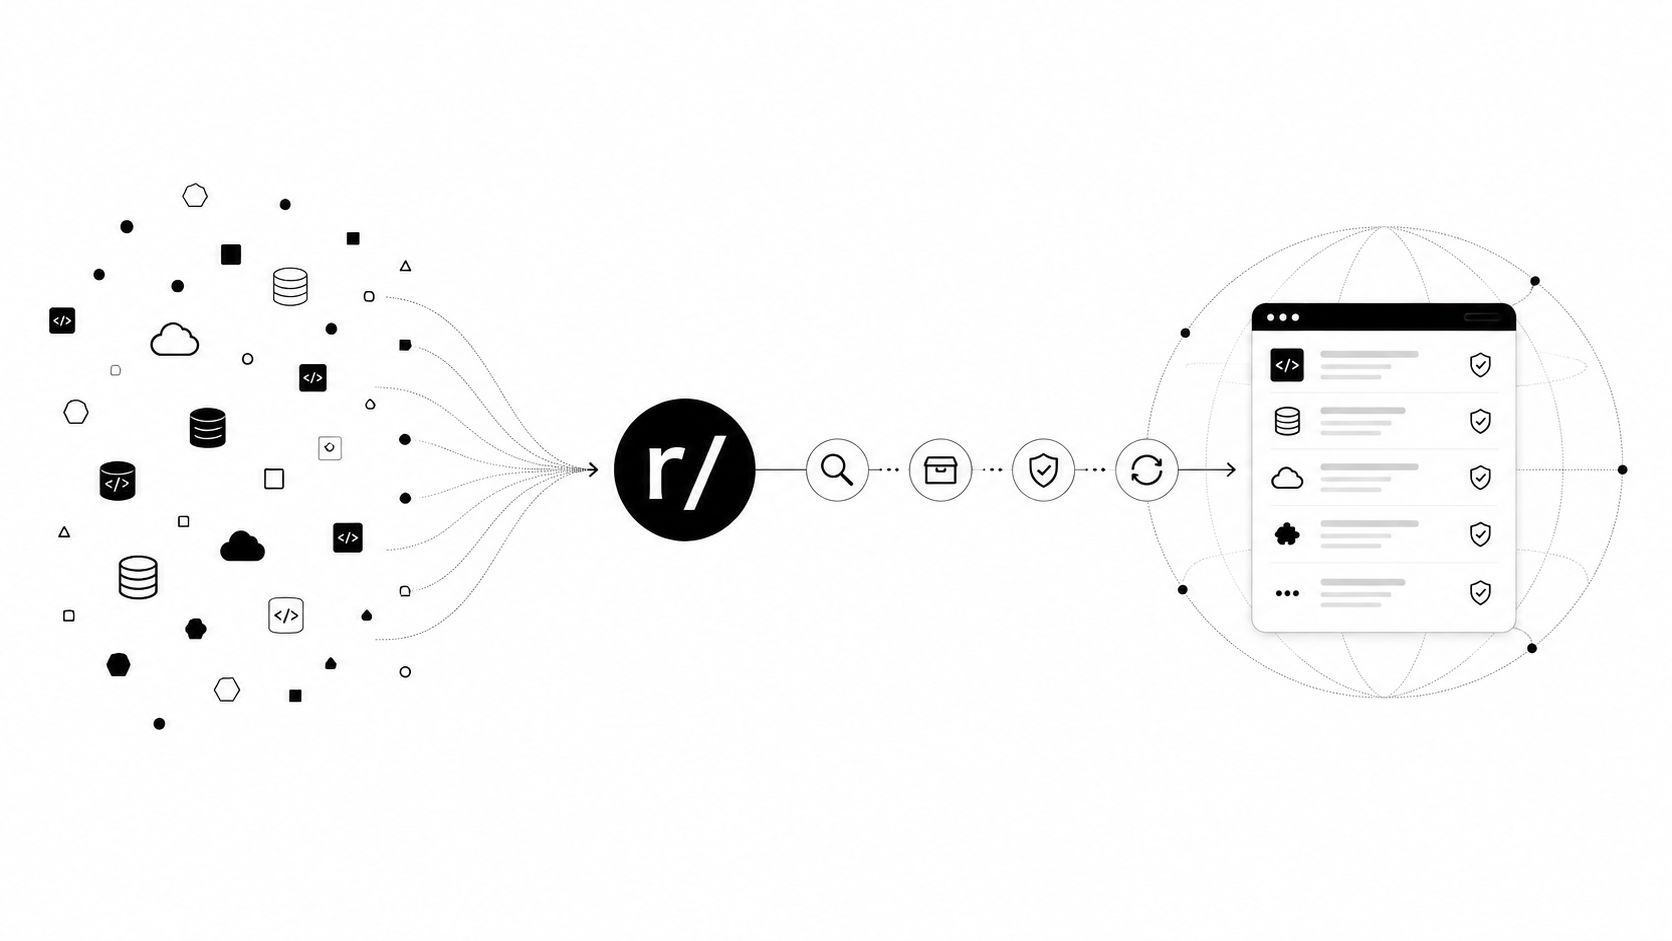
软件世界正在指数级膨胀。一个需求背后,可能有几十个 API、SDK、MCP Server、Skill、CLI 都能满足。Reuseio 不替你做技术决策,而是用 AI 把散落在互联网上的软件能力,自动发现、抽取、分类、验证、整理成一份「机器可读、来源可查、持续更新」的世界级 Registry。
AI 负责整理,来源负责事实
传统做法里,开发者要么靠记忆堆砌经验,要么让 AI 凭训练数据「脑补」一个库是否支持某项能力。Reuseio 把这两件事彻底分开:
- Reuseio 负责:发现(Discover)、描述(Describe)、结构化(Structure)、引用(Reference)。
- Reuseio 不负责:决策(Decide)、执行(Execute)、代理(Proxy)、计费(Bill)、托管密钥(Store Credentials)。
一句话概括它的边界哲学:
机器自动维护数据流程,让来源决定事实,平台内置 AI 负责整理,让用户的 Agent 结合实际项目判断。
也就是说,Reuseio 不声称「哪个最好」,它只保证「我说的事实都有出处」。这是它能管理海量项目且不崩坏的根基。
统一数据模型胜过无限分类
面对成千上万的软件,第一道难题不是「怎么抓」,而是「怎么存」。Reuseio 用一套以 Product(产品)为核心 的模型来解决分类收敛问题:
| 实体 | 作用 | 关键约束 |
|---|---|---|
| Provider | 软件提供方(如 Cloudflare、Stripe) | 与 Product 分离,一个 Provider 下挂多个 Product |
| Product | 核心实体:API / SDK / MCP / Skill / CLI / SaaS / Runtime / Library / Open Source | 必须有名称、slug、合法类型、至少一个 Source |
| Capability | 正式能力(如 Object Storage、Authentication) | 独立建模,与 Product 多对多 |
| Tag | 受控标签(Runtime、Region、License、Protocol…) | 必须归属某个 Tag Group |
| Facts | 动态事实(pricing.free_tier、runtime.cloudflare_workers) |
每项必须绑定 Source |
| Source / Evidence | 事实来源与字段级证据 | 所有事实可追溯 |
这种建模的巧妙之处在于:能力的分类是可收敛的。无论市面上出现多少新库,「对象存储」「身份认证」这类 Capability 是稳定的。AI 的工作不是无限发明新分类,而是把新产品精确挂到已有的能力树上。
AI 分类整理流水线
Reuseio 把「管理海量项目」拆成一条全自动、可伸缩的 Pipeline:
每一步 AI 的角色都明确清晰:
- Discovery(发现):从 GitHub、npm、MCP Registry、官方目录、人工 Seed URL 扫描新项目,进入
discovered_items,先做基础去重(Canonical URL、官方域名、仓库地址、包名、Provider+名称、别名)。 - AI 收录判断:判断项目属于
valid / irrelevant / demo / abandoned / duplicate / spam。这是「收录决策」,允许 AI 推理,但此时 AI 不能生成任何事实。 - Crawler(抓取):按
max_depth=3、max_pages=30等边界递归抓取官方文档、API Reference、Pricing、SDK、Changelog,只访问官方域名,绝不越界。 - Extract(抽取):删除导航/页脚/广告等噪声,保留标题、段落、表格、代码;长文档切片,绝不全文塞给 AI。
- AI Normalizer(标准化,核心环节):把「产品元数据 + 来源片段 + 现有 Registry + Schema」输入模型,输出严格结构化 JSON——Provider、类型、中英摘要、Capability 候选、Tag、Integration、Facts、关系、来源映射、AI Prompt。
- Validator(校验):确定性校验器逐项检查 Schema 合法性、枚举值、URL、Capability/Tag 是否真实存在、Fact 是否绑定 Source。失败只记录错误,不污染数据库。
- Publish(发布):通过校验即自动上线,无需人工审核,并清理缓存、重建搜索索引。管理员事后只需处理异常。
能推算,但不能编造
这是 Reuseio 最有纪律感的设计。AI 在流水线里被明确允许和禁止了两套行为:
AI 可以做(整理性工作):
- 抽取、整理、分类、翻译、摘要、生成介绍、生成供 AI 使用的提示词。
AI 禁止做(事实性编造):
- 猜测价格、猜测兼容性、猜测运行环境、猜测 API 能力、根据常识填字段、用 Provider 其他产品推导当前产品能力。
对于所有未知信息,规则是:
// 正确:未知就是 null
{ "cloudflare_workers": null }

// 错误:把"未知"当成"不支持"
{ "cloudflare_workers": false }
「未知 ≠ false」 是整条流水线的铁律。摘要类内容(中英 Summary、Description、AI Prompt)允许 AI 综合多篇来源生成,但只能基于已抓取内容,不得引入材料之外的新事实。
受控词表:让分类自动收敛
海量项目最怕分类失控——今天 AI 叫它「对象存储」,明天叫「云存储」,后天叫「OSS」。Reuseio 用两个受控词表锁死这个问题:
- Capability Registry:AI 抽取能力后,先查已存在的 Registry 做匹配,命中就用
capability_id;确实不存在才生成候选,且必须完成 slug 规范化、去重、alias 匹配。 - Tag Registry:Tag 必须属于某个 Tag Group(如
runtime、region、commercial-model),AI 候选 → 词表精确/别名匹配 → 复用或新建。
同时,AI 还会抽取产品间关系(depends_on、integrates_with、compatible_with),并谨慎建立 alternative_to(仅凭常识不自动建立)。这让 Registry 不只是目录,而是一张不断生长的软件能力图谱。
自动化、去重、成本控制
要让「海量」可持续,靠的不是更强的模型,而是更稳的工程:
- 队列化解耦:Cloudflare Cron → Scheduler Worker → Queue → Crawler Worker,避免单次任务过大或单点失败拖垮全局。
- 幂等与去重:队列重投不会创建重复 run 或重复 crawl;发布失败仅隔离该产品,不影响其他。
- 更新检测(content_hash):重新抓取先比 Hash,没变就不调 AI、不重新标准化,只更新
fetched_at,大幅降低 AI 成本。按类型制定刷新周期(Pricing 24h、Docs 7 天、第三方 14 天、已停更 30 天)。 - 失败隔离与限速:Job 级 / Source 级隔离 + Queue 重试;尊重
robots.txt,单域名并发 ≤2、间隔 ≥1s,ReuseioBot/1.0。 - 停更处理:检测到
Deprecated / Sunset / Archived自动标discontinued但保留 Source 与页面;旧文档里消失的事实先标记 stale,连续两次抓取无法确认才删除,避免网页改版误删有效信息。
一处建模,多端消费
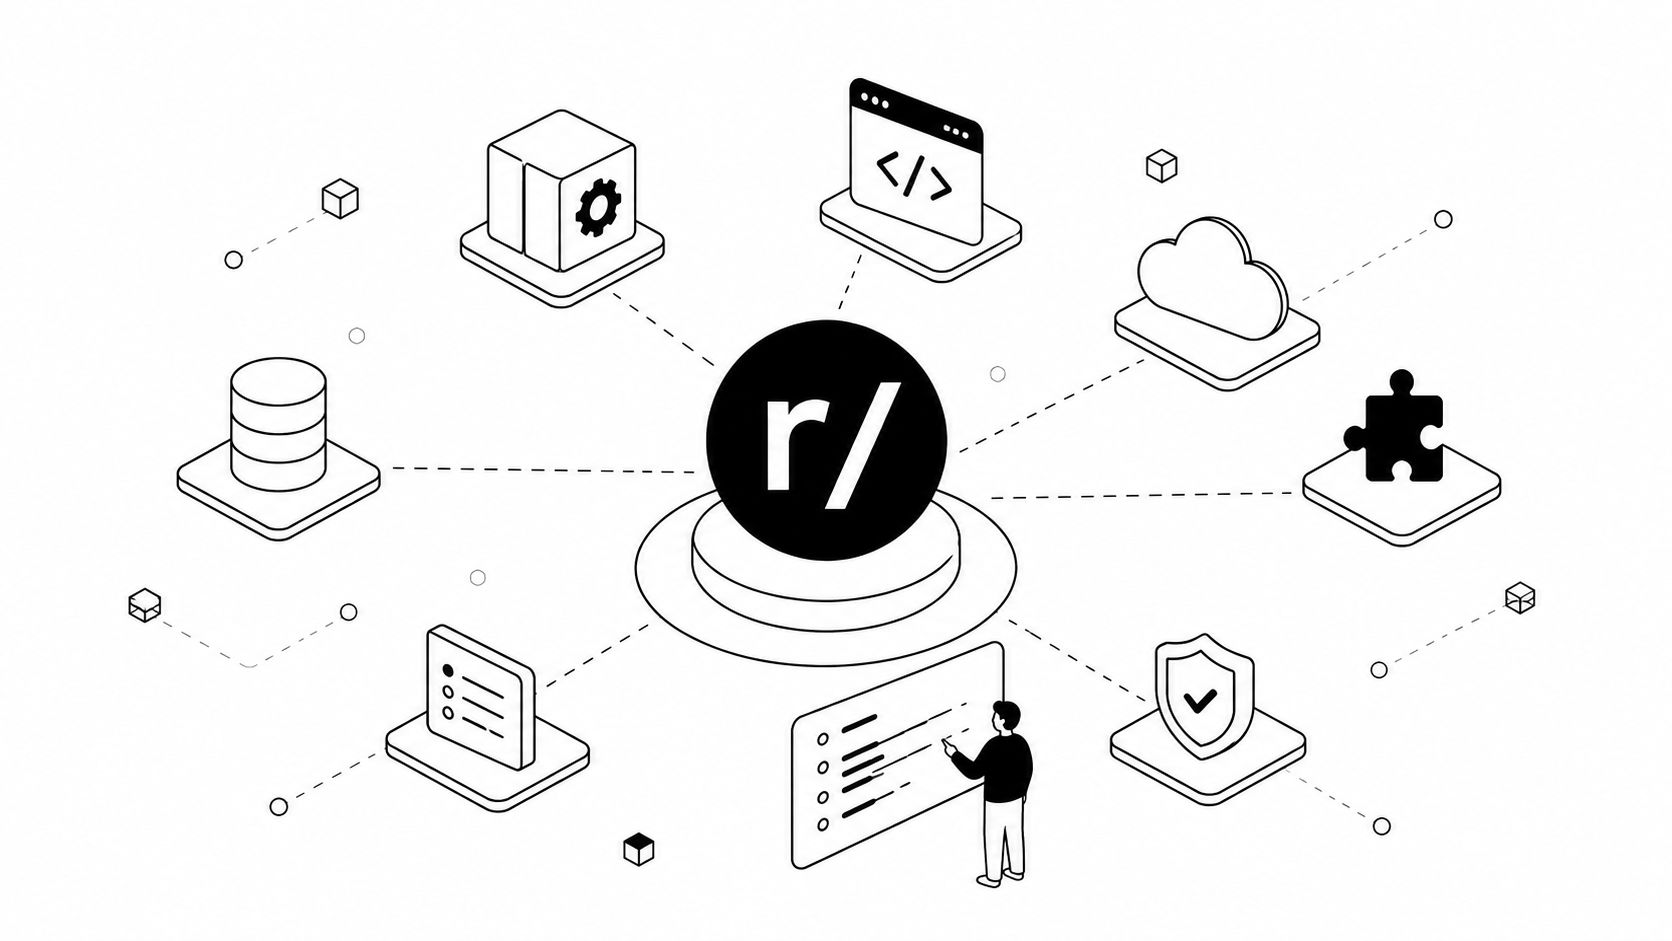
整理好的 Registry 不被锁死在某个界面里,而是围绕同一套 Schema 服务所有客户端:
One Registry · One Schema · Multiple Clients
- Reuseio Manifest(
reuseio.json):人类、AI Agent、工具统一可读的描述格式。 - 前台网站:SSR 浏览、搜索、详情、来源展示、AI Prompt 一键复制。
- Public REST API:无需 Key,给 AI Agent 直接检索。
- npm SDK:极薄封装,
search()、getProduct()、getManifest()直接返回 Manifest。 - Skill(工作流):不存数据,只定义「读需求 → 拆能力 → 查 Reuseio → 读 Manifest → 查 Evidence → 比较 → 让 AI 判断 → 依据官方文档实施」的协议。
同一个产品,在网页、API、SDK、Skill、未来 MCP 里看到的都是同一份结构化事实。
Reuseio 的核心资产
Reuseio 的价值,不在于它多会「推荐」,而在于它把混乱的软件世界,沉淀成一份:
持续更新、可追溯、机器可读取的软件能力 Registry。
当项目数量从几百涨到几十万,靠人肉维护会崩溃,靠 AI 自由发挥会失真。Reuseio 给出的答案是:用 AI 做规模化整理,用来源做事实锚点,用统一 Schema 做长期收敛——让开发者在动手写代码前,先看见已有的、被验证过的、可复用的方案。
这是「从重复造轮子,到优先复用」的第一步。