Coverage-guided Fuzzing:让测试输入朝“新路径”前进
TL;DR
了解覆盖率引导模糊测试如何变异输入、探索新路径并发现 AI 生成代码中的崩溃。
覆盖率引导模糊测试根据程序走过的新路径保留输入,帮助 AI 生成代码主动暴露异常数据和隐藏崩溃。
Coverage-guided Fuzzing:让测试输入朝“新路径”前进
模糊测试通常会向程序输入大量自动生成或随机变异的数据,观察是否出现崩溃、超时或异常结果。Coverage-guided Fuzzing,覆盖率引导模糊测试,则进一步记录每个输入走过的代码区域,优先保留那些能触达新路径的输入。
为什么不是单纯随机
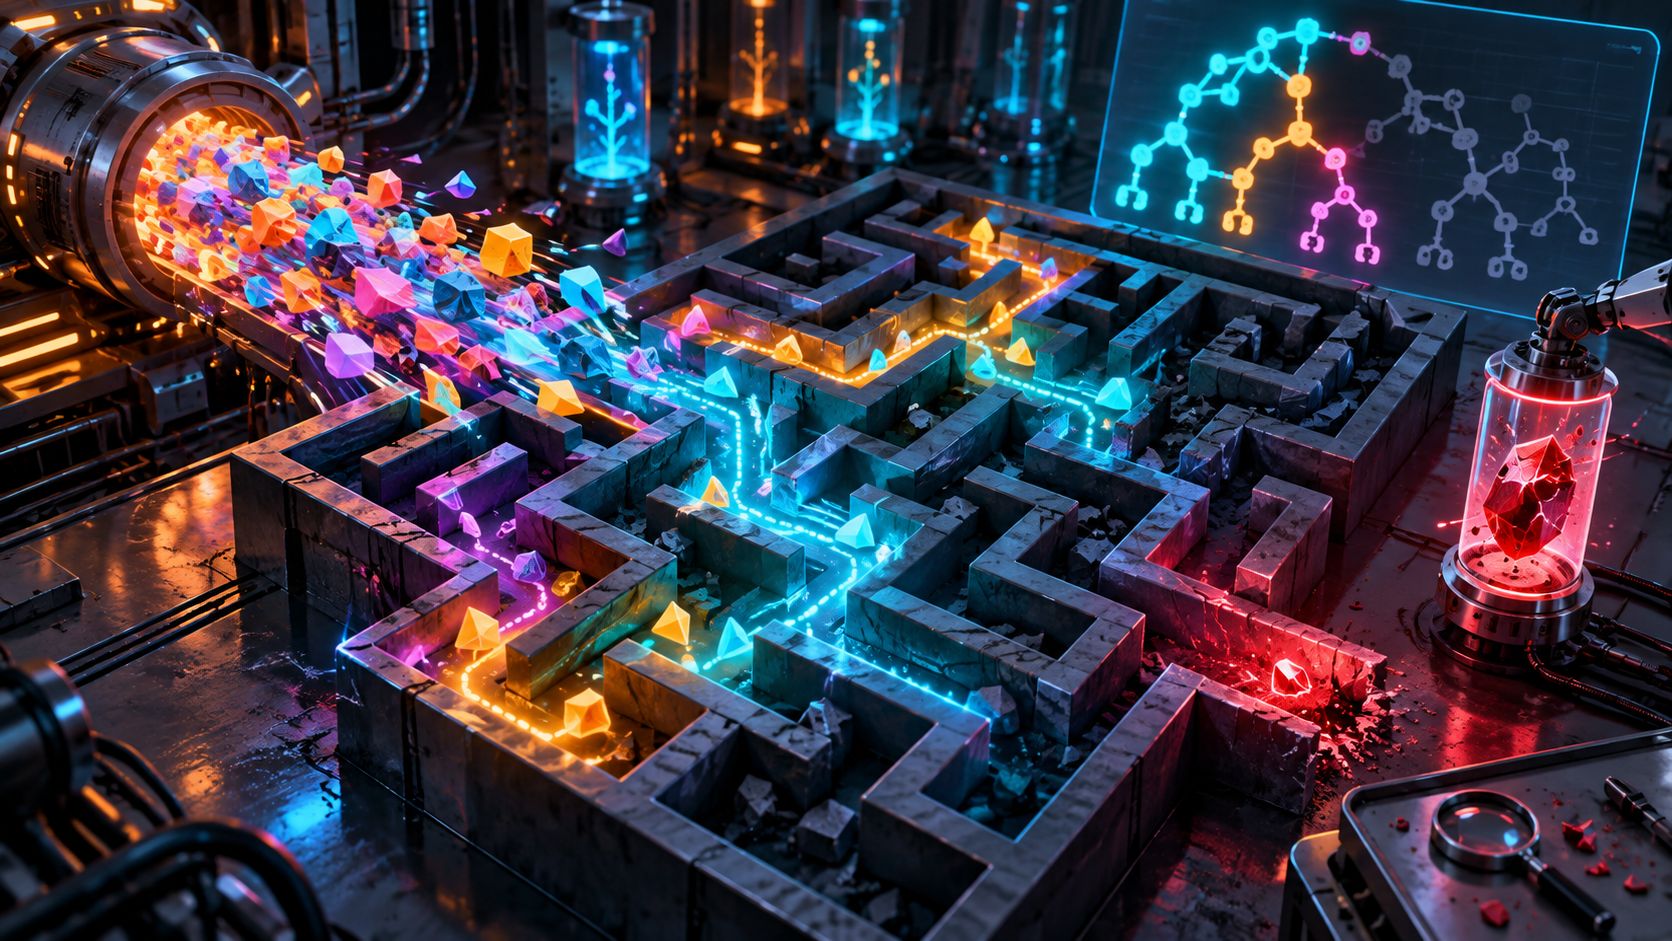
随机输入可能一直停留在程序入口附近,因为它们无法满足格式、长度或校验条件。覆盖率引导的工具会观察输入是否让程序进入了新的基本块或分支。如果一个变异让程序走得更深,它就可能被加入语料库,成为后续变异的种子。
这是一种反馈循环:生成输入,运行程序,记录覆盖范围,保留有价值的输入,再继续变异。随着语料库增长,测试可能逐渐探索到更少被触达的路径。
AI 生成代码为什么需要它
AI 往往会优先实现正常输入和常见场景,而解析器、文件上传、协议处理、压缩解码等代码真正容易出问题的地方,常在异常长度、奇怪编码、嵌套结构和截断数据上。模糊测试不需要模型提前列出所有边界样例,可以主动尝试输入空间。
它特别适合与 AI 协作:AI 可以先写一个清晰的 fuzz target,说明如何把字节输入交给目标函数;工具负责大量变异;人和 AI 再根据崩溃样本缩小原因并修复。发现一个失败输入后,还应把它保存为回归测试,避免未来再次出现。
覆盖率高不等于没有 Bug
覆盖率只表示执行到了哪些代码,不表示每条路径的结果都正确。某些错误需要特定状态、时序或外部服务才能触发,单纯扩大覆盖范围也未必发现。模糊测试还可能生成大量重复样本,需要控制运行时间和语料库规模。
适合从哪里开始
优先选择输入边界清晰、可重复运行、不会产生不可控副作用的函数,比如解析器、编码解码器、配置读取器和数据转换器。先让 AI 写出输入约束与失败处理,再把工具加入 CI 或定期任务。
LLVM 对覆盖率引导模糊测试的实现方式有详细说明,见 libFuzzer 官方文档。