Property-based Testing:不要只测试几个例子
TL;DR
从排序和数据转换例子出发,理解性质测试如何超越少量手写样例。
性质测试通过描述输入输出应保持的规律,自动生成大量边界样本,帮助发现 AI 生成代码中隐藏的错误。
Property-based Testing:不要只测试几个例子
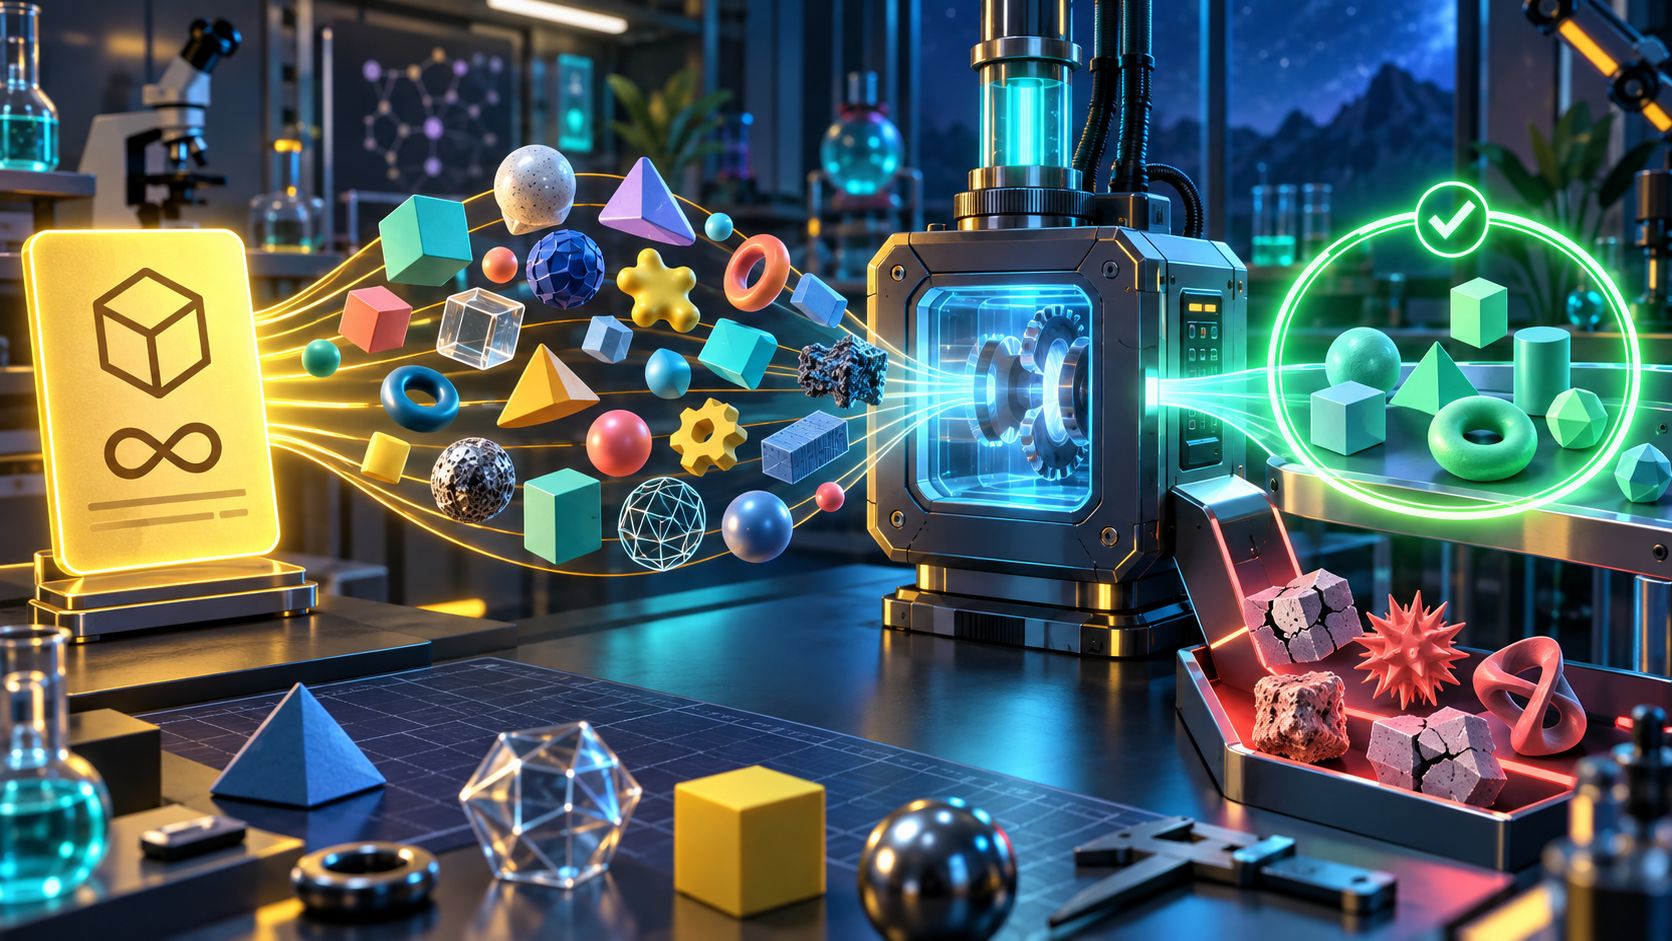
传统测试通常这样写:输入 3 和 5,期待结果是 8;输入空列表,期待结果是空列表。Property-based Testing,性质测试或基于性质的测试,则先描述一条应该对大量输入成立的规则,再让工具自动生成输入,包括人类容易忽略的边界情况。
从“答案”换成“性质”
以排序函数为例,单个例子只能说明 [3, 1, 2] 被排成了 [1, 2, 3]。性质测试可以描述:排序结果长度不变;结果仍包含原来的元素;从前到后不下降。工具会生成很多不同长度、重复值、负数和极端值的列表,尝试寻找违反性质的输入。
这并不意味着测试可以不写预期结果。它只是把预期从一个具体答案改成一组更稳定的关系。对于数据转换、编码解码、权限判断和数学函数,这种表达方式往往比手工堆叠样例更有覆盖面。
AI 生成代码为什么适合这种测试
模型很容易生成“看起来完整”的样例,但样例数量有限,且可能和实现共享同一个错误假设。性质测试迫使我们先问:这个函数无论输入怎样,都应该保持什么不变量?AI 可以帮助提出候选性质,再由人确认性质本身是否正确。
它也适合测试 AI 生成的边界处理。比如分页函数应满足页码变化不丢数据,序列化再反序列化应保留关键字段,权限过滤不应因为输入顺序改变而放宽。测试框架负责大量试探,开发者负责定义真正重要的关系。
性质写错了怎么办
性质测试不是自动证明。如果性质过于宽松,错误实现仍可能通过;如果性质描述了错误的业务规则,测试反而会阻止正确功能。还要注意随机输入需要保存失败样本,以便把偶发失败变成稳定回归测试。
适合从哪里开始
优先选择有清晰不变量的纯函数、解析器、转换器和排序过滤逻辑。让 AI 先列出输入空间、核心性质和可能的反例,再由你确认后生成测试。这样,AI 的价值不只是写更多测试,而是帮助发现“我们到底希望代码永远保持什么”。
Python 生态中的 Hypothesis 对这一思路有完整介绍,可阅读官方文档。