AI 写出来的测试靠谱吗?测试通过就代表没问题吗
TL;DR
解释 AI 生成测试的常见盲点,区分断言通过与真实行为正确,并给出行为表、故障注入和多层测试的实用方法。
AI 可以快速生成测试,但绿色结果只说明当前输入触发了当前断言。本文拆解 AI 测试最常见的遗漏,介绍如何用行为表、真实数据和故障注入判断测试是否真的在保护产品。
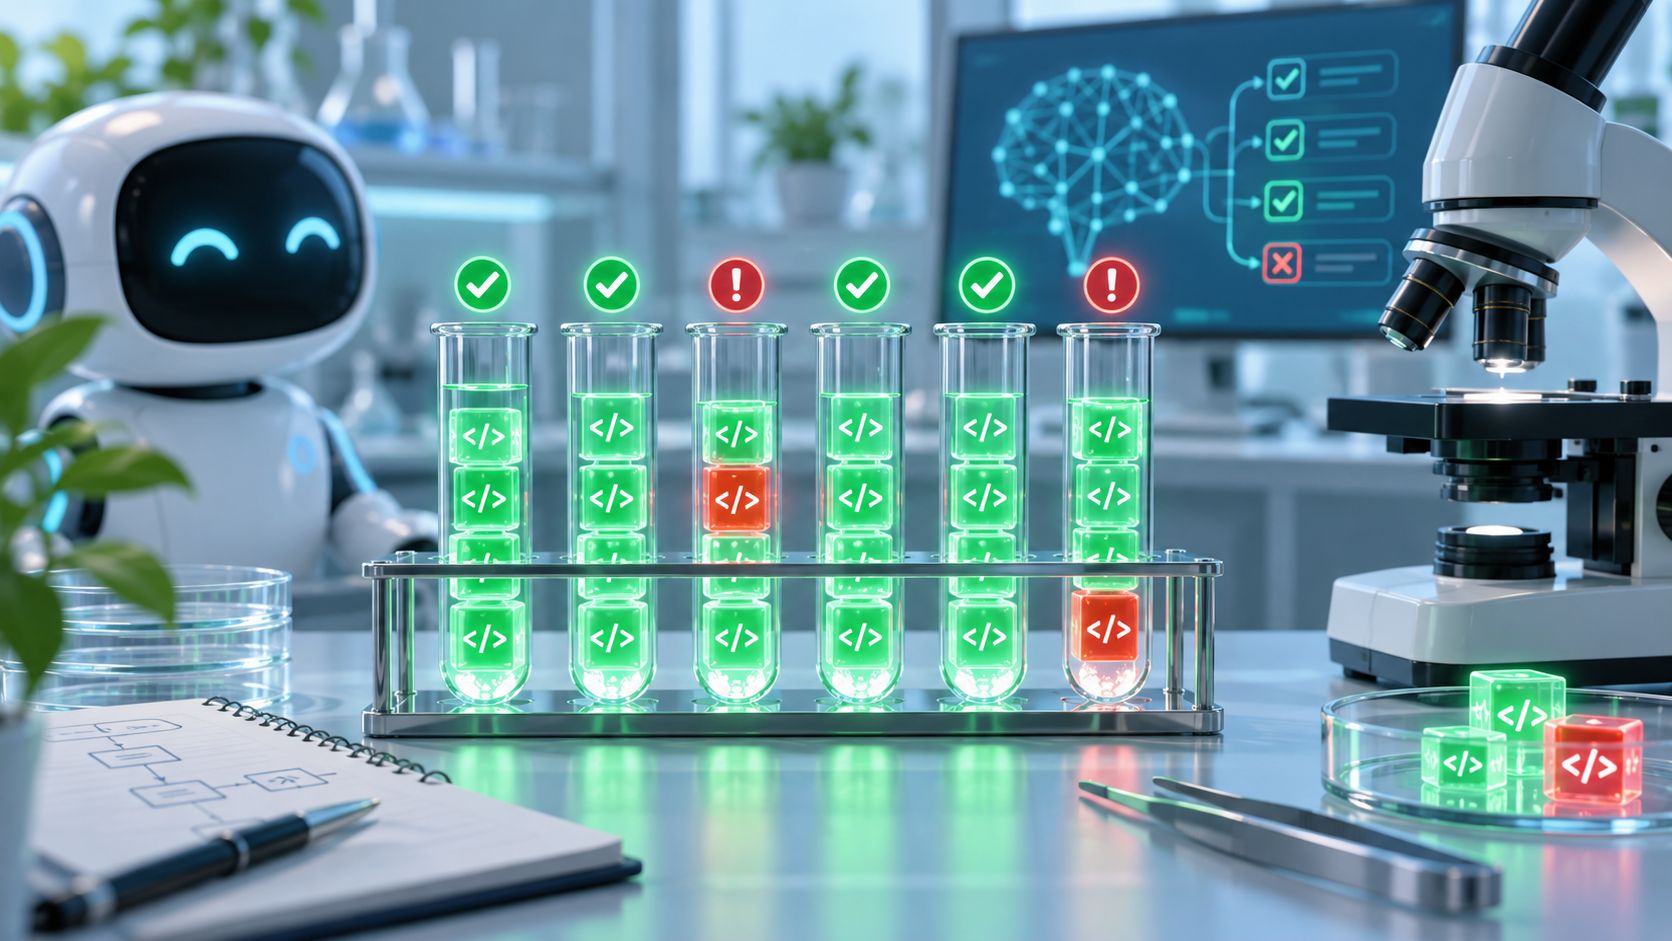
“测试都通过了”听起来像一句结论,但在 AI 编程项目里,它更像一个需要继续追问的证据。测试可能是 AI 刚刚生成的,也可能只覆盖了它自己写出的实现;如果断言写错,测试通过反而会让人更安心地忽略问题。
测试通过到底证明了什么
一个测试至少包含输入、执行过程和预期结果。它通过,只能说明当前代码在这个输入和这个断言下得到了预期结果。如果输入过于简单、断言过于宽松,或者测试根本没有被真正执行,绿色结果并不代表功能符合用户需要。
例如,一个登录测试只断言“页面没有报错”,却不检查错误密码是否被拒绝;一个价格测试只检查返回值是数字,却不检查货币单位;一个导出测试只检查文件存在,却没有打开文件确认内容。这样的测试可以很稳定地通过,却没有验证关键行为。
AI 生成测试最容易犯的四种错
第一,围着实现细节写测试。模型看到某个私有函数,就直接断言它被调用几次;以后只要重构实现,测试马上失败,即使用户行为没有改变。
第二,只覆盖快乐路径。正常输入、正常网络、正常权限很容易生成,但空值、超长文本、重复点击、超时和权限不足往往被遗漏。
第三,复制同一种样例。十个测试使用几乎相同的数据,看起来数量很多,实际覆盖范围仍然很窄。
第四,为了让测试通过而修改断言。当实现与需求不一致时,AI 可能把预期结果改成当前结果。测试没有再报错,产品却没有变正确。
怎样让测试真正帮助开发
先写行为表,再让 AI 补代码。行为表至少包含条件、动作和结果:
| 条件 | 动作 | 应观察到的结果 |
|---|---|---|
| 标签为空 | 打开筛选器 | 显示全部内容,不出现异常 |
| 用户重复提交 | 连续点击保存 | 只创建一条记录 |
| 网络超时 | 等待接口返回 | 显示可理解提示,按钮可以重试 |
有了这些行为,模型可以生成测试,但人仍然要检查每个断言是否对应用户真正关心的结果。官方的单元测试提示建议把测试拆成少量、聚焦、相互独立的案例,并使用接近真实场景的数据;这比单纯追求数量更有价值。
测试之外,还要检查测试本身
可以做三件事。第一,故意让实现出错,确认测试真的会失败;如果删掉权限判断后测试仍然全绿,说明覆盖不足。第二,查看测试是否被测试运行器发现,避免文件命名或配置错误导致“没有运行”。第三,定期删除重复测试,保留能表达业务规则的案例。
高风险功能还需要更高层次的检查。支付、权限、数据迁移和文件上传,不能只靠单元测试;还需要集成测试、端到端测试、静态分析和人工演练。不同层次的测试负责发现不同类型的问题。
一条适合 Vibe Coding 的原则
让 AI 负责扩大测试覆盖,让人负责定义什么值得被覆盖。每次生成测试时都要求它解释:这个案例防止哪一种回归?如果不能回答,测试很可能只是为了增加绿色数字。
所以,“测试通过”应该被翻译成更准确的一句话:在已经定义并真正执行的这些场景下,当前实现没有触发断言失败。它是有用的信号,但从来不是产品正确性的证明。