AI 编程为什么第一版很快,第二版却越来越难改
TL;DR
从原型、临时方案和结构复杂度出发,解释 Vibe Coding 项目为何越来越难维护,并给出适合 AI 协作的重构与版本节奏。
AI 能迅速做出第一版,却不一定自动带来可维护的第二版。本文解释原型速度为何会转化为结构复杂度,并给出识别重复状态、安排重构和控制 AI 改动范围的实用方法。
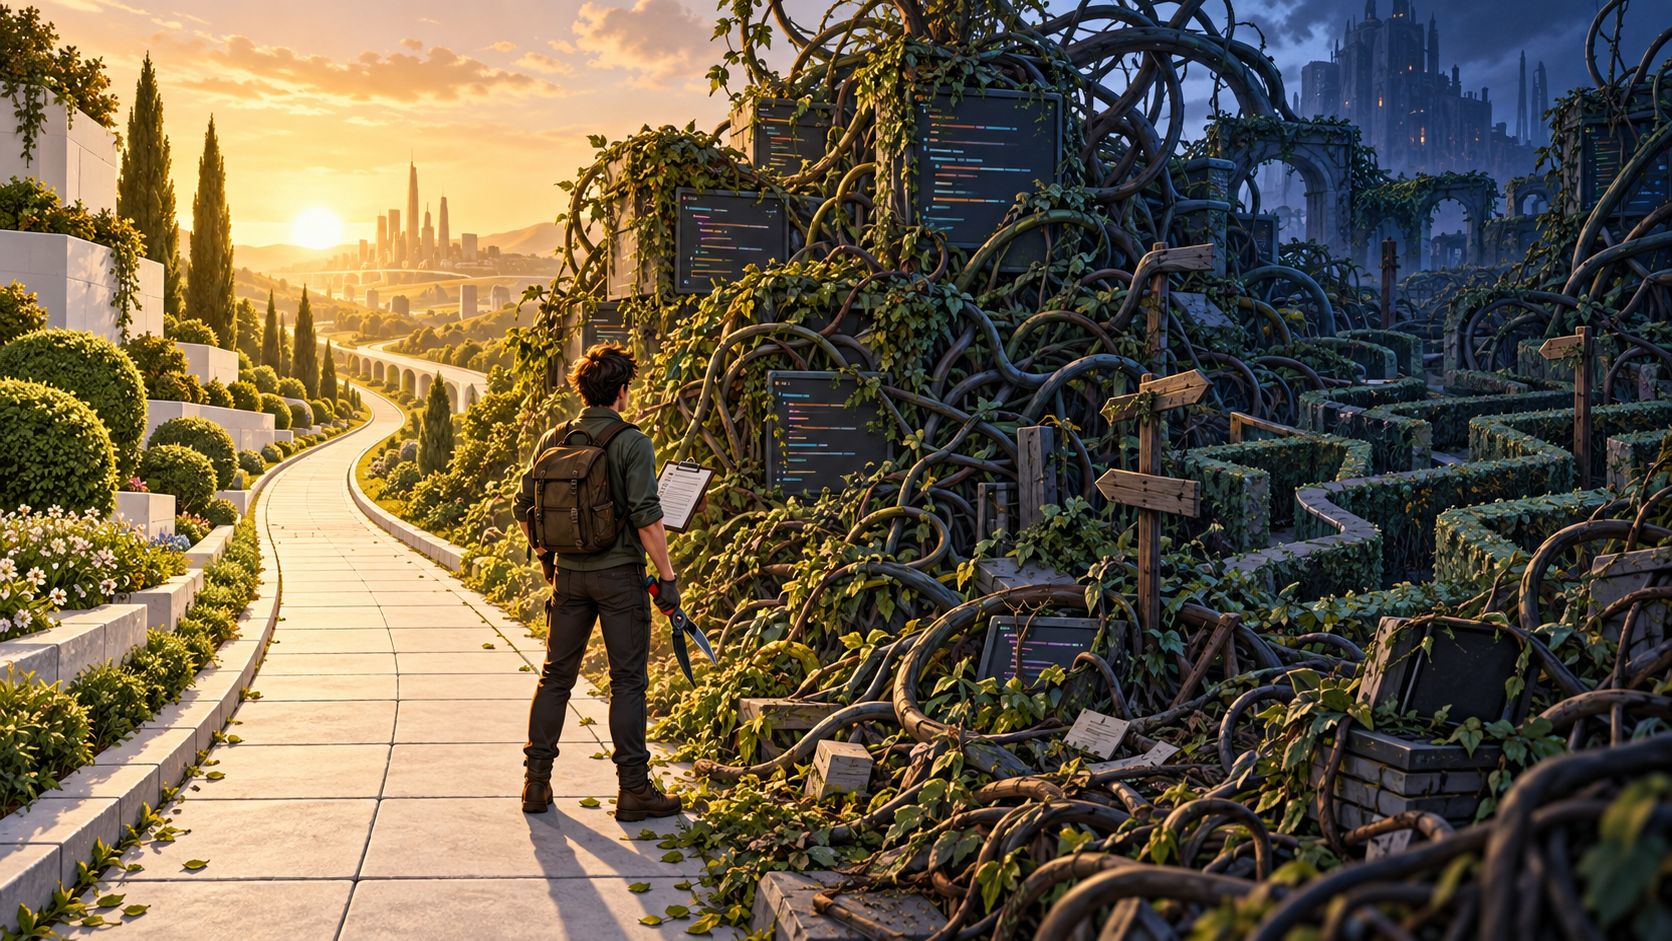
AI 编程最让人兴奋的瞬间,往往是第一版。你说出需求,模型很快搭出页面;再补一句“加上搜索、登录和导出”,功能也能继续长出来。可当项目进入第二周,修改一个按钮却牵动多个文件,原本简单的需求开始引发连锁报错。这不是 AI 突然“变笨”,而是原型速度与软件维护成本之间的差距显现了。
第一版解决的是“有没有”,后续版本解决的是“能不能长期存在”
原型阶段允许很多临时决定:数据先写在内存里,页面先用一份假数据,错误情况先不处理。这样做没有错,因为目标是尽快验证想法。但如果没有明确的过渡节点,临时方案就会逐渐变成系统的一部分。
维护阶段要回答完全不同的问题:这个状态由谁负责?接口失败时用户看到什么?旧数据如何迁移?同一个功能在移动端是否仍然可用?当模型继续沿着旧结构加功能,隐藏的临时决定就会一起被放大。
AI 为什么容易把复杂度越堆越高
模型通常根据当前上下文生成“局部合理”的修改。它看到一个报错,会优先让这条路径恢复;看到一个新需求,会倾向于增加一个组件、一个状态或一层适配,而不是重新审视原来的设计。对一次回答来说这很合理,对连续几十次补丁来说却可能形成重复逻辑。
最常见的症状包括:同一份数据有多个来源;相似的按钮各自维护一套状态;错误处理散落在页面各处;配置值被复制到多个文件;一个函数同时负责读取、校验、保存和提示用户。每一处都能运行,整体却越来越难理解。
什么时候应该停下来重构
可以观察三个信号:
- 修改一个小功能时,AI 需要同时触碰很多互不相关的文件。
- 你无法用一句话解释数据从输入到展示的路径。
- 测试只覆盖成功流程,任何改动都要靠手动点一遍才能确认没有回归。
出现这些信号时,不要继续让模型“再修一下”。先要求它只做盘点:列出重复逻辑、状态来源、外部依赖和未覆盖的错误情况,暂时不要修改代码。等结构图和风险清单出来,再选择一个边界清晰的部分重构。
一套适合 AI 协作的维护节奏
每次任务开始前,先给出不变的约束,例如“保留公开接口”“不要引入新依赖”“只修改某个目录”。每次任务结束后,要求模型列出实际改动文件、运行过的检查和仍然存在的假设。把这些信息写进提交记录,下一次协作就不必完全依赖聊天历史。
另外,要把“大需求”拆成可回滚的小提交。先补测试,再改实现;先替换内部细节,再修改外部接口;先迁移一类数据,再扩大范围。版本控制的价值不是保存代码,而是让你敢于尝试和撤回。
判断代码质量的简单问题
不要只问“页面能不能打开”,还可以问:新同事能否定位入口?删除一个功能时会不会留下无效配置?网络变慢时系统会不会重复提交?如果答案说不清,就说明第一版还没有真正变成可维护的产品。
Vibe Coding 的速度值得珍惜,但它最应该节省的是机械劳动,而不是省掉思考。第一版越快,越要尽早安排一次结构检查,让“能跑”及时过渡到“能改”。