Vibe Coding 最适合做什么,最不适合做什么
TL;DR
按边界、反馈、失败代价和可恢复性,判断哪些任务适合交给 Vibe Coding,哪些任务必须保留人工决策和批准。
Vibe Coding 最适合边界清楚、反馈快速、失败可恢复的任务,最不适合模糊决策和不可逆的高风险操作。本文用任务三问帮助读者判断何时放手让 AI 执行、何时必须人工把关。
Vibe Coding 并不是“把所有开发工作交给 AI”,而是把不同任务按风险和可验证程度分层。一个能在几分钟内做出原型的工具,未必适合改支付流程;一个能修复测试的 Agent,未必适合替你决定产品需求。用对地方,它像高效的结对伙伴;用错地方,它会快速放大模糊和错误。
最适合的任务:边界清楚、反馈快速
第一类是原型和个人工具。静态网页、表单、文本转换、数据展示和小型自动化脚本,通常可以在本地快速运行,失败成本也较低。目标不是直接上线,而是验证想法和收集反馈。
第二类是机械性改造。统一命名、补充文档、迁移重复 API、生成样板测试、修复明确的类型错误,都可以让 AI 先完成初稿,再由人检查差异。
第三类是有明确验收标准的维护任务。例如某个测试失败、某个响应字段需要兼容、某个页面在窄屏溢出。标准越具体,AI 越容易根据结果迭代,而不是凭感觉宣布完成。
最不适合的任务:目标模糊、代价不可逆
第一是直接决定业务规则。“设计一个合理的会员体系”包含定价、权限、合规和用户体验,无法只靠代码运行结果验收。AI 可以列出方案,但决策必须由了解用户和责任的人做。
第二是高风险的生产操作。删除数据、修改权限、轮换凭据、发布支付逻辑和执行大规模迁移,都需要人工确认、备份、回滚和审计。终端 Agent 的自动化能力越强,越应该限制它的权限。
第三是安全关键和隐含约束很多的系统。身份认证、加密、并发控制、医疗或金融数据处理,不能因为示例测试通过就认为实现可信。这里需要成熟方案、专家复核和针对真实威胁的测试。
用一个“任务三问”做判断
把任务交给 AI 前,先问:
- 成功是什么,能否写成具体的验收条件?
- 失败会造成什么,能否在沙箱、分支或备份后重试?
- 谁能发现它错了,是否有测试、日志和人工复核?
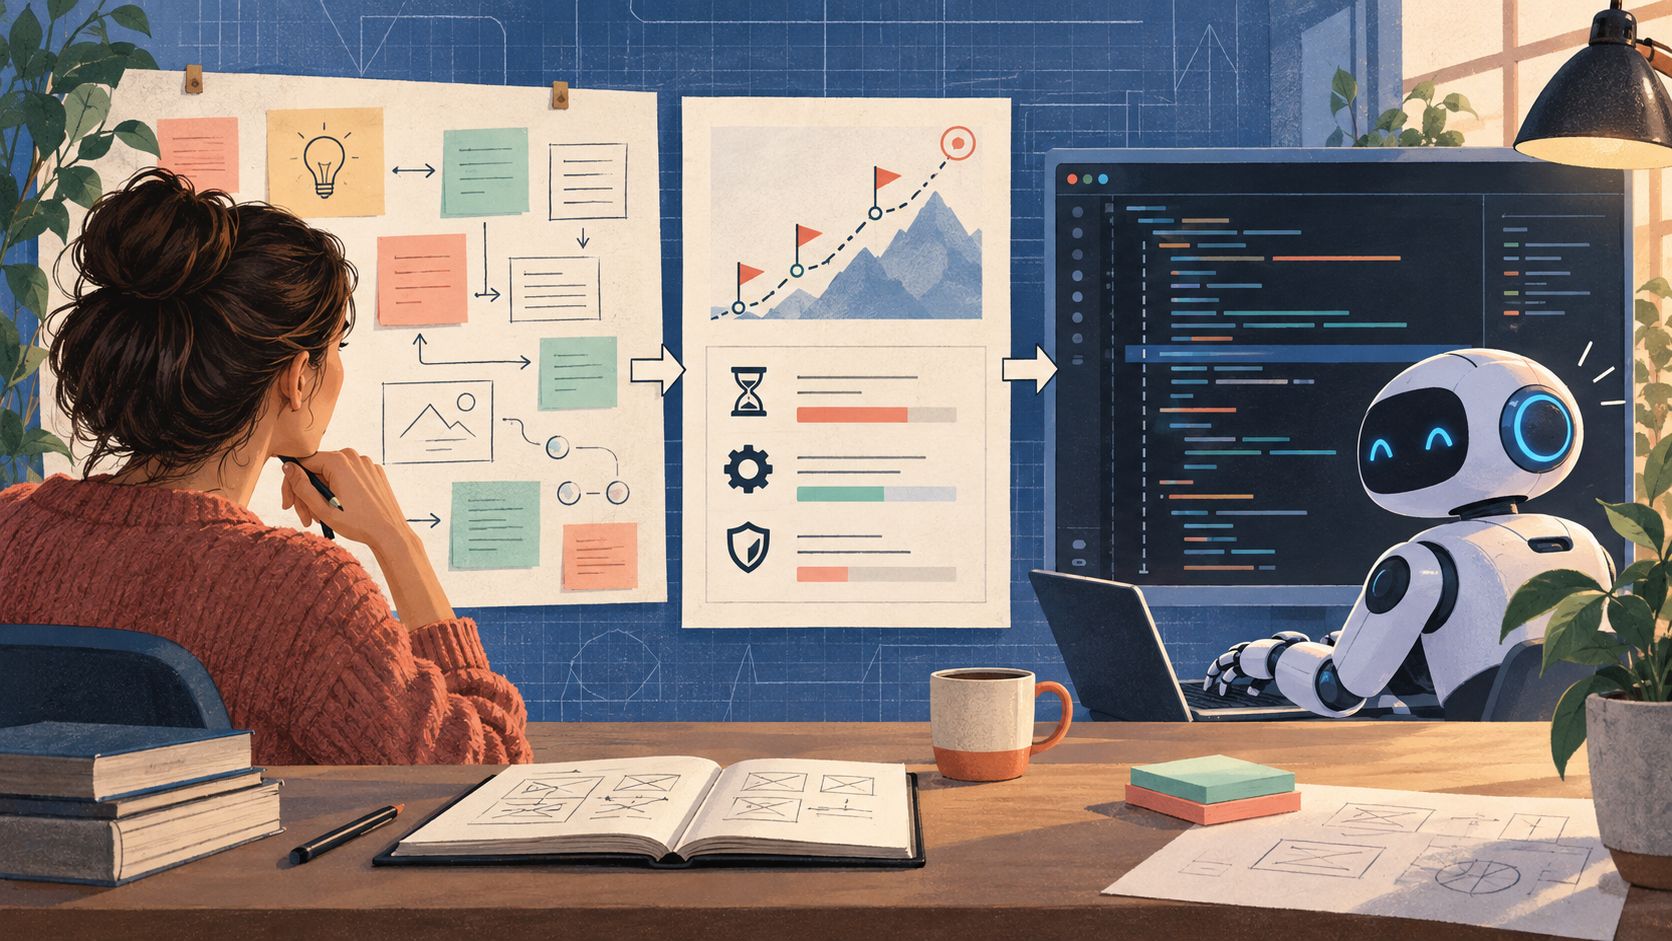
如果三个问题都能回答,任务通常适合 AI 辅助;如果失败代价很高、成功标准很模糊、又没有人能复核,就应该先做需求和架构工作,而不是直接生成代码。
把大任务拆成不同风险层
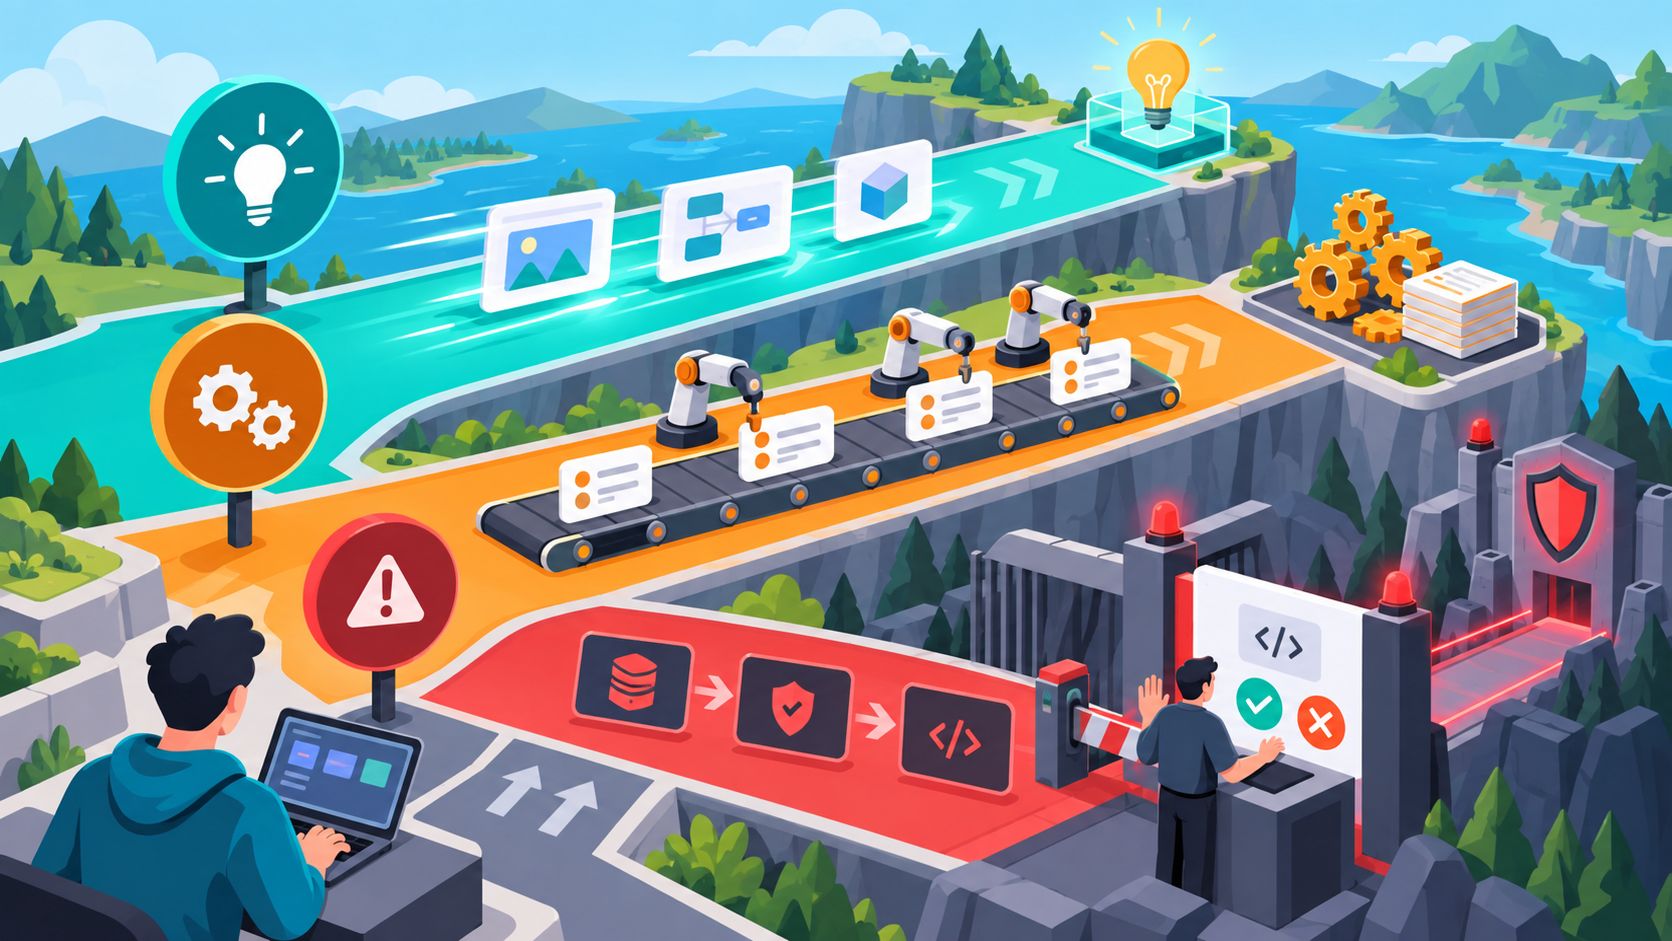
同一个项目也可以分层。AI 先生成静态页面和假数据,适合快速探索;随后让它补充单元测试和错误状态,仍然可控;接着接入真实数据和权限,这时需要更严格的审查;最后涉及生产写入和发布,就必须进入受保护的流水线。不是“能不能用 AI”,而是每一步该给它多少权限。
AI 最有价值的地方
它最适合减少等待和机械劳动:解释陌生代码、搜索相关文件、生成初稿、整理测试、比较实现方案。它不应该替你跳过定义问题、选择取舍、确认风险和承担后果。把这些边界写进任务和团队流程,Vibe Coding 才会从“凭感觉写软件”变成一种可管理的工作方式。
一句话判断标准:任务越接近可重复的实验,越适合交给 AI;任务越接近不可逆的承诺,越需要人来决定和批准。