Tree-sitter:为什么编辑器不用每次重读整个文件?
TL;DR
了解 Tree-sitter、语法树、增量解析,以及 AI 编程工具为什么需要结构化代码上下文。
Tree-sitter 用增量解析和语法树帮助编辑器与 AI 编程工具只处理代码变化的局部,让搜索、补全和结构化修改更高效。
Tree-sitter 解决的不是“把代码读懂”这么简单
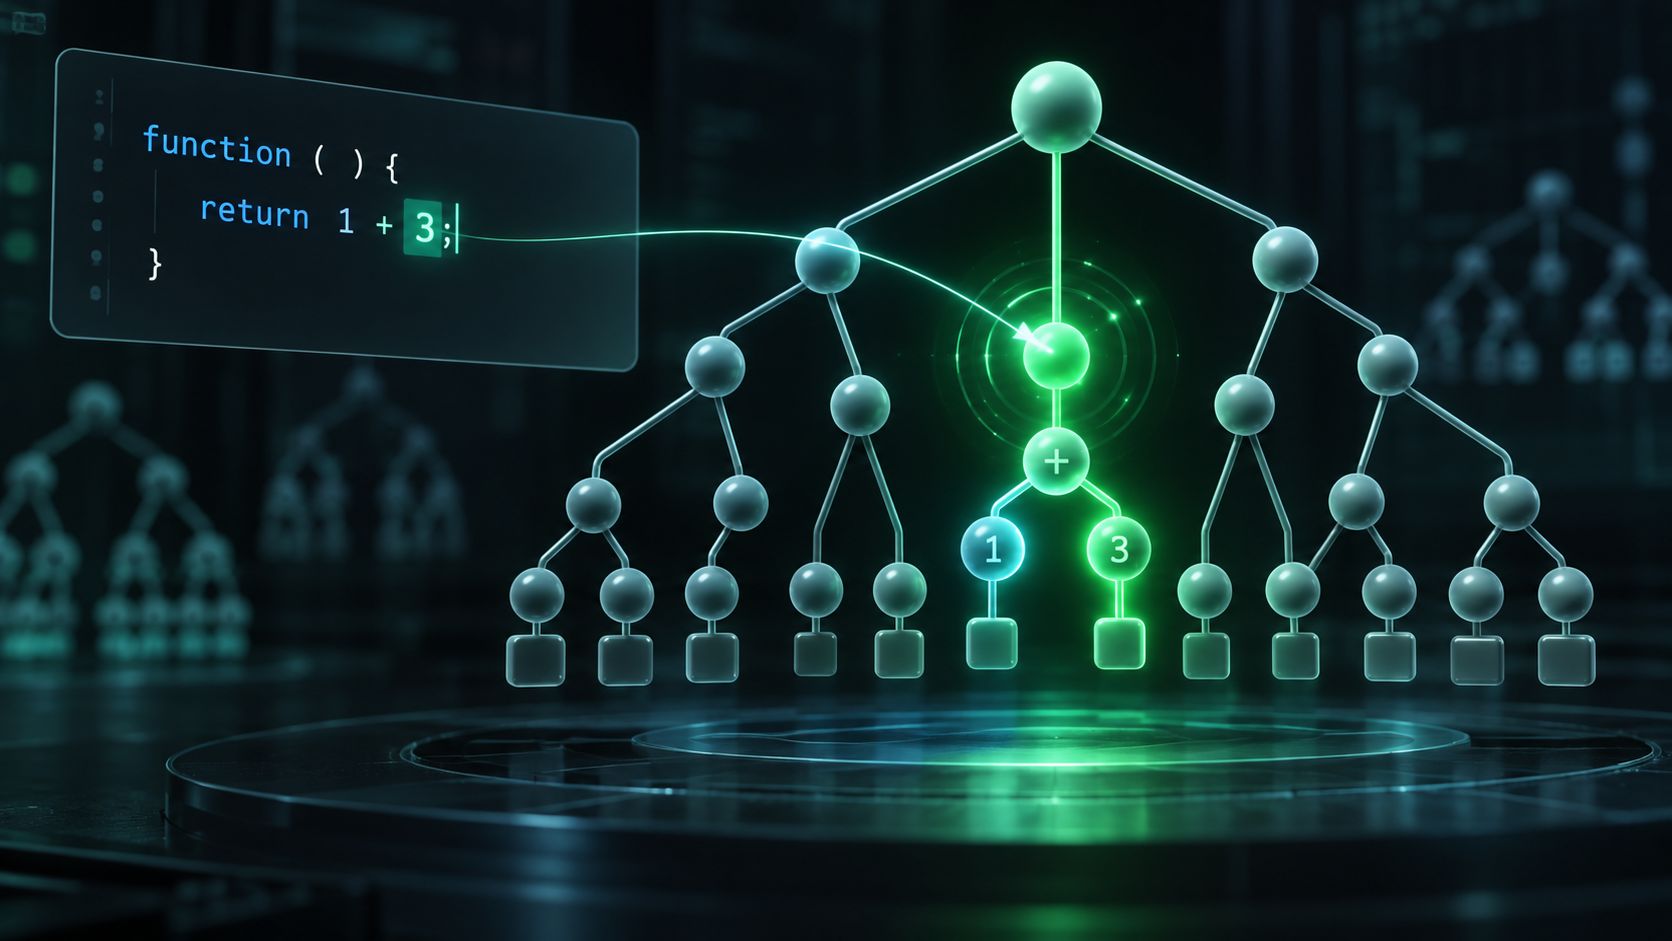
Tree-sitter 是一个解析器生成工具和增量解析库。它的名字听起来像一棵会听代码的树,但真正重要的能力是:它能把源代码组织成语法树,并在文件发生小改动时尽量复用原来的结果,而不是每次从头解析整个文件。
什么叫增量解析
如果你在一个几千行的文件中只改了一个变量名,传统做法可能重新扫描整个文件。增量解析会保留没有受影响的树节点,只重新计算变化附近的结构。对人来说,这就像修改一本书中的一个句子时,不需要重新理解整本书的目录。
编辑器的语法高亮、代码折叠、括号匹配和结构化选择,都可以从这棵树中获得帮助。即使代码暂时写到一半、语法还不完整,Tree-sitter 也会尽力恢复并标出错误节点,而不是因为一个缺失的括号就放弃分析。
它为什么和 AI 编程有关
AI 编程 Agent 经常需要做三类事情:找到某个函数,理解某个调用周围的上下文,以及把修改限制在结构边界内。直接按字符切片会把函数从中间截断,也可能把注释、字符串和真正的代码混在一起。基于语法树的查询则可以按照函数、调用表达式、条件节点来取上下文。
这会改变“给模型多少代码”的问题。好的上下文不一定是整份文件,而可能是一个完整函数、它调用的几个关键函数,以及与修改相关的类型定义。这样既减少无关文本,也降低模型把相似代码混为一谈的概率。
Tree-sitter 也不是万能解析器
它理解的是语法结构,不会自动知道数据库里的订单和代码里的 order 是同一个业务概念。不同语言需要不同语法描述,宏、动态生成代码和运行时反射也会给静态解析带来困难。解析成功只说明结构可读,不代表代码可以编译或运行。
普通开发者能从中得到什么
当一个 AI 工具提供“按函数修改”“只查看相关符号”或“结构化代码搜索”时,背后往往离不开解析器。你不需要直接学习 Tree-sitter 的查询语法,但可以关注工具是否能区分代码、注释和字符串,是否能在代码暂时不完整时继续工作,以及它给出的上下文是否以结构为单位。
Tree-sitter 的官方资料可以参考其解析器与语法文档。