OpenAPI 如何让 AI 同时写前后端不“各说各话”?
TL;DR
解释 OpenAPI 如何减少 AI 生成前后端代码时的接口错位,并介绍 Schema、契约测试和兼容发布。
AI 可以分别生成前端和后端,却容易在字段、错误和时间格式上互相错位。本文解释 OpenAPI 如何把接口输入输出变成共同契约,再连接生成代码和契约测试。
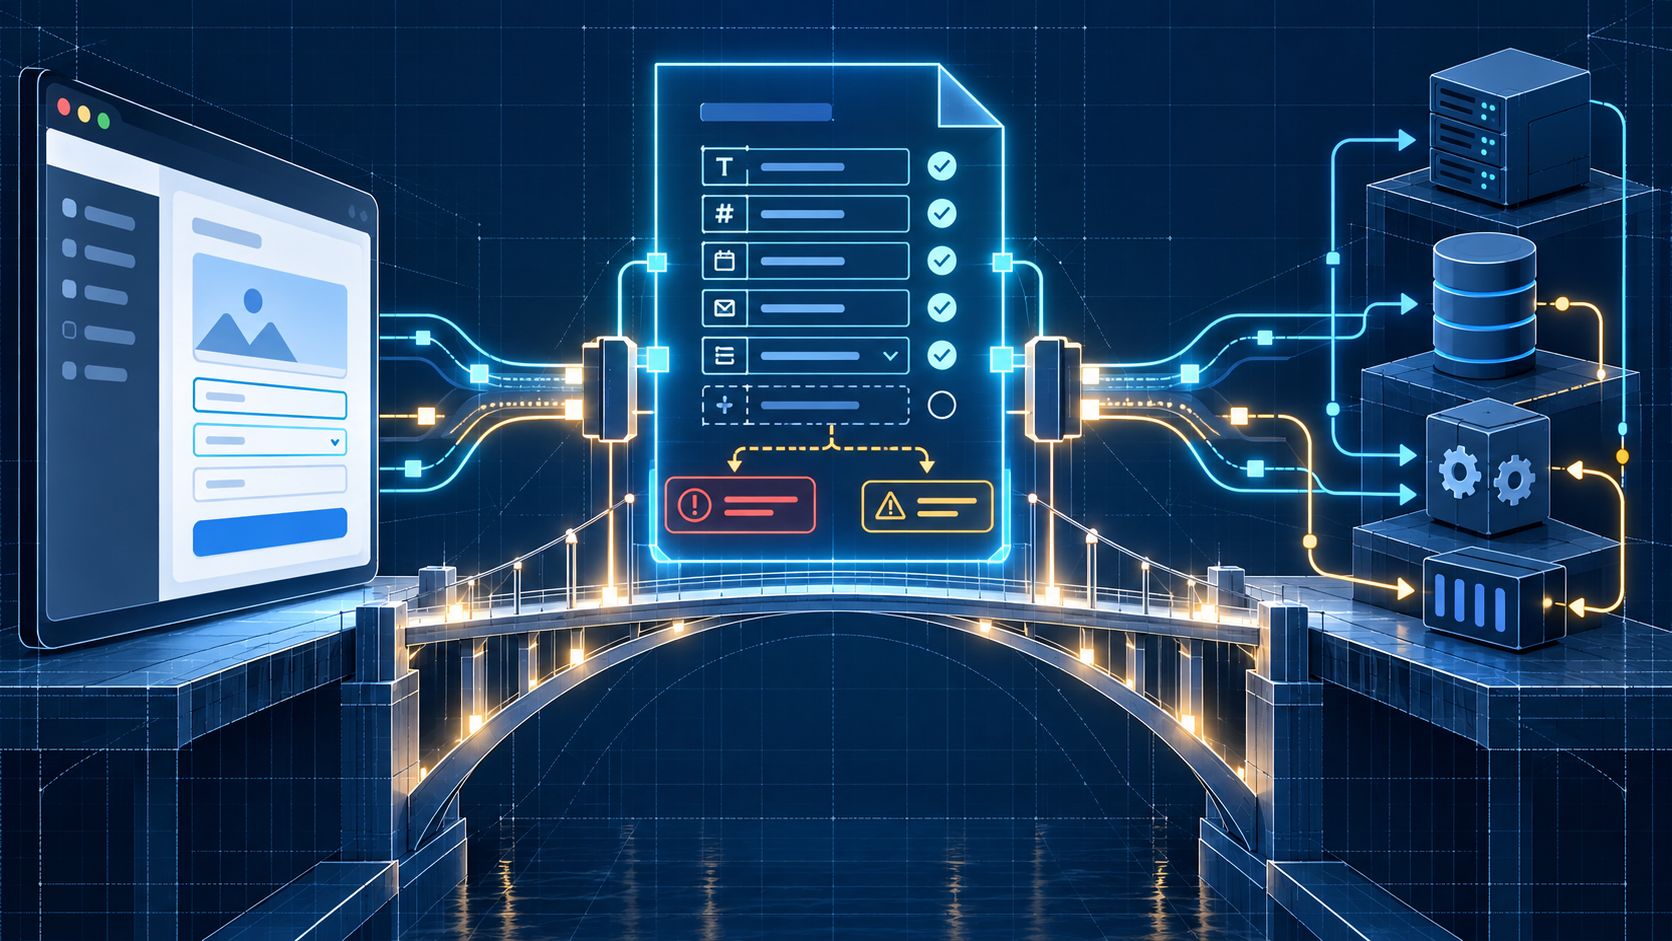
AI 可以很快写出一个前端页面,也可以很快生成一个后端接口。问题是,两边可能各自都“看起来合理”:前端把字段叫作 userName,后端返回 username;前端认为删除会返回空对象,后端却返回一条状态记录;一边把时间当本地时间,另一边把它当 UTC。代码都能生成,系统却无法稳定协作。
接口契约解决的是共同语言问题
OpenAPI 用结构化描述记录路径、参数、请求体、响应、错误和认证方式。它不是自动保证实现正确的魔法,但可以成为前后端、测试工具和 AI 共同读取的契约。模型不必从几十个文件里猜接口形状,而是可以先读取规范,再生成客户端、服务端和测试。
对 AI 编程来说,最有价值的不是“自动生成更多代码”,而是减少双方各自猜测。一个明确的 Schema 会告诉模型哪些字段必填、哪些值有枚举、错误返回长什么样,以及一个请求可能出现哪些状态。
为什么只靠自然语言容易错位
“做一个用户详情接口”没有说明分页、缺失用户、权限、字段格式和兼容要求。人类开发者可能通过经验补全这些信息,模型则可能选择一个看似常见的默认方案。等前后端都写完,再靠手动联调发现不一致,修改成本已经增加。
先写契约并不意味着要提前决定所有实现细节。可以先描述用户真正需要观察的输入和输出,再让 AI 分别生成实现。契约变成边界,内部实现仍然可以迭代。
一份适合 AI 协作的接口流程
第一步,写出最小 OpenAPI 文档,只包含当前功能需要的路径和 Schema。第二步,让 AI 检查规范中的歧义、重复字段和错误情况。第三步,根据规范生成服务端、客户端和契约测试。第四步,在 CI 中验证实际响应是否符合规范。第五步,修改接口前先讨论版本兼容和迁移方式。
这样做可以把错误尽量前移。若生成器和实际实现发生差异,构建或测试就会给出明确反馈;若业务需求改变,团队也能看到契约变化,而不是只看到几处分散的代码修改。
契约也有边界
OpenAPI 能描述结构和接口行为,却不能自动判断业务是否正确,也不能替代权限检查、性能测试和真实用户验收。一个接口可以完全符合 Schema,却把不该公开的字段返回给用户。AI 仍然需要业务上下文和安全约束。
普通项目不必一开始就写一份巨大规范。先为最容易错位、最常被多个客户端调用的接口建立契约,再逐步扩大范围,通常更容易获得收益。