CAS:文件的身份可以由内容决定
TL;DR
从内容摘要出发,理解构建缓存、容器镜像和软件产物为什么能按内容复用。
内容寻址存储 CAS 用内容摘要识别文件和构建产物,解释 AI 编程工具、容器和缓存为什么能复用结果。
CAS:文件的身份可以由内容决定
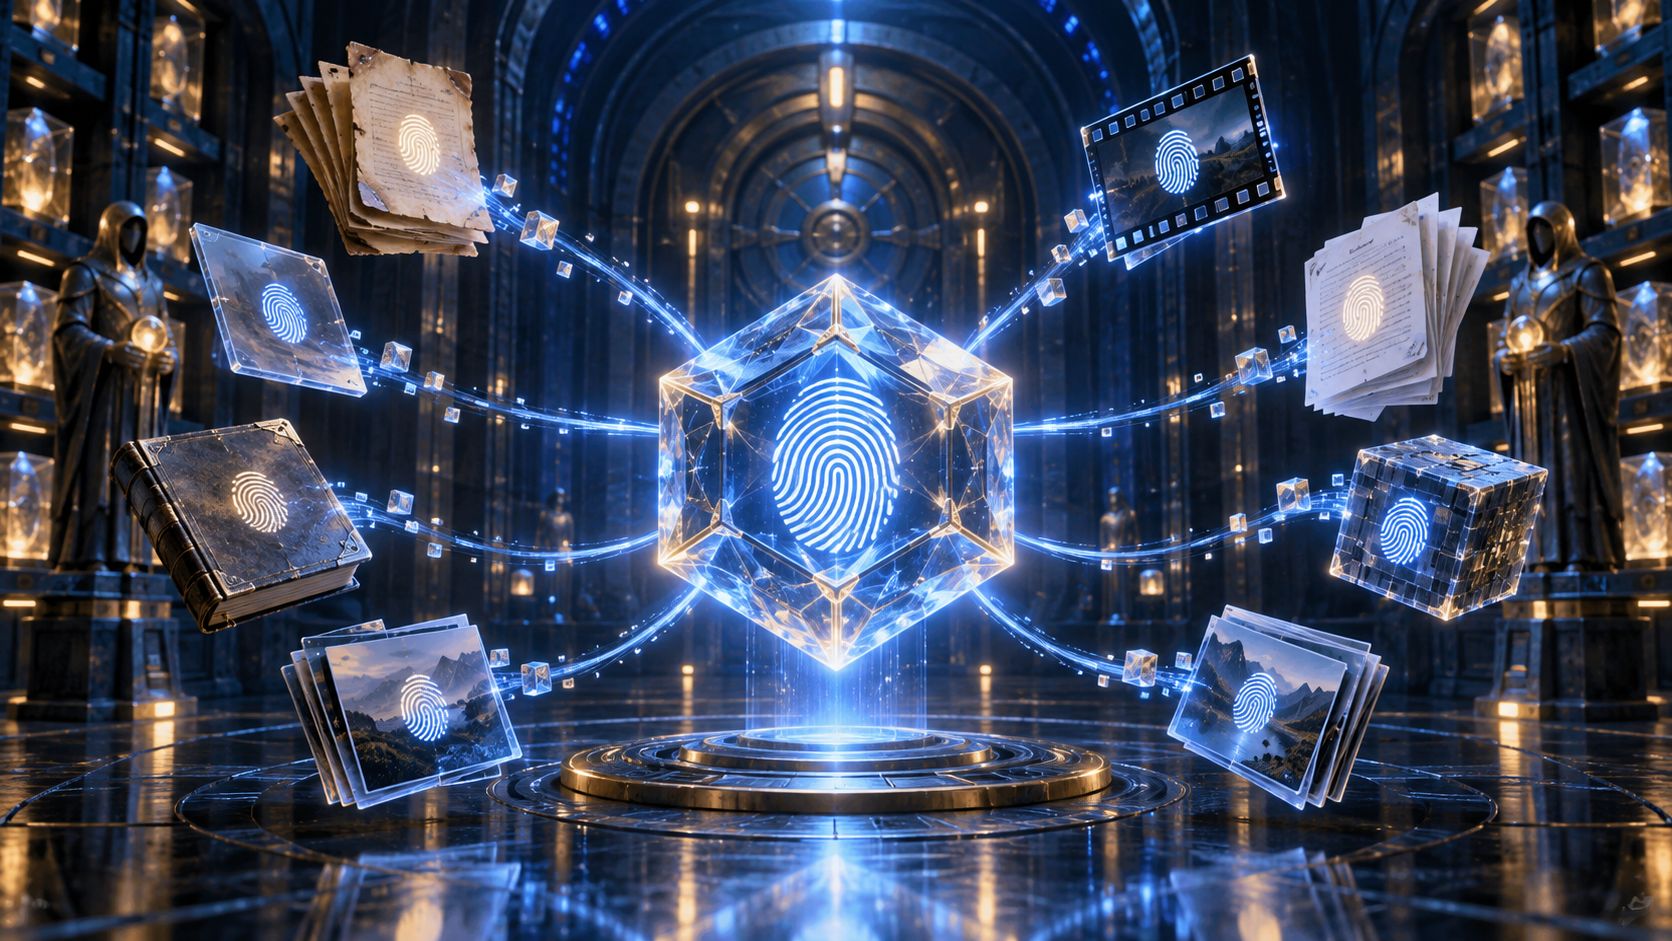
普通文件通常靠路径和文件名寻找:/project/dist/app.js。内容寻址存储,Content-Addressable Storage,简称 CAS,则用内容计算出的摘要作为身份。内容不变,摘要就不变;内容改变,摘要也会改变。名字可以变化,内容身份仍然可验证。
它和普通缓存有什么不同
普通缓存常常依赖人为命名,例如“最新构建”“昨天的依赖”。这些名字可能被覆盖,也可能指向不再相同的内容。CAS 通过哈希把对象和实际字节绑定起来,工具可以先判断“这个摘要是否已经存在”,存在就复用,无需重新下载或重新构建。
容器镜像层、编译产物、远程构建缓存和分布式对象存储,都可以使用这种思路。OCI 镜像规范中的内容描述符就包含内容类型、大小和摘要,消费者可以用摘要核对取回的数据。
AI 编程为什么会用到 CAS
Agent 工作时经常重复读取依赖、运行测试和生成构建产物。如果每次都从头开始,成本很高。基于内容的缓存可以告诉系统:输入源代码、工具和配置都没变,这一步的输出可以直接复用。
CAS 也提供了一种证据。AI 说“这是刚刚生成的产物”时,工具可以记录产物摘要;之后下载、部署或审查时,再验证摘要是否一致。这样,模型的文字总结就不再是唯一记录。
哈希不是魔法护盾
摘要能检测内容是否发生变化,但不能说明内容本身是否安全,也不能证明生成它的过程没有被篡改。若攻击者控制了可信入口,恶意内容仍可以获得一个全新的摘要。因此,CAS 常和签名、来源证明、权限控制一起使用。
怎样把它用在个人项目中
不必先搭建复杂的远程缓存。你可以先理解锁文件、构建缓存和容器层为什么都倾向于记录具体内容摘要;当 AI 修改依赖或构建配置时,注意哪些输入变化会让缓存失效,也要确认缓存复用不会掩盖真实构建问题。
OCI 对内容描述符和摘要校验的说明见 OCI Image Specification。