软件复杂度分配:开发者和用户各自该承担什么
TL;DR
当开发者选择“不做某些事情”时,这些事情的复杂度并不会自动消失,而是会以另一种形式转嫁到用户身上
当开发者选择“不做某些事情”时,这些事情的复杂度并不会自动消失,而是会以另一种形式转嫁到用户身上
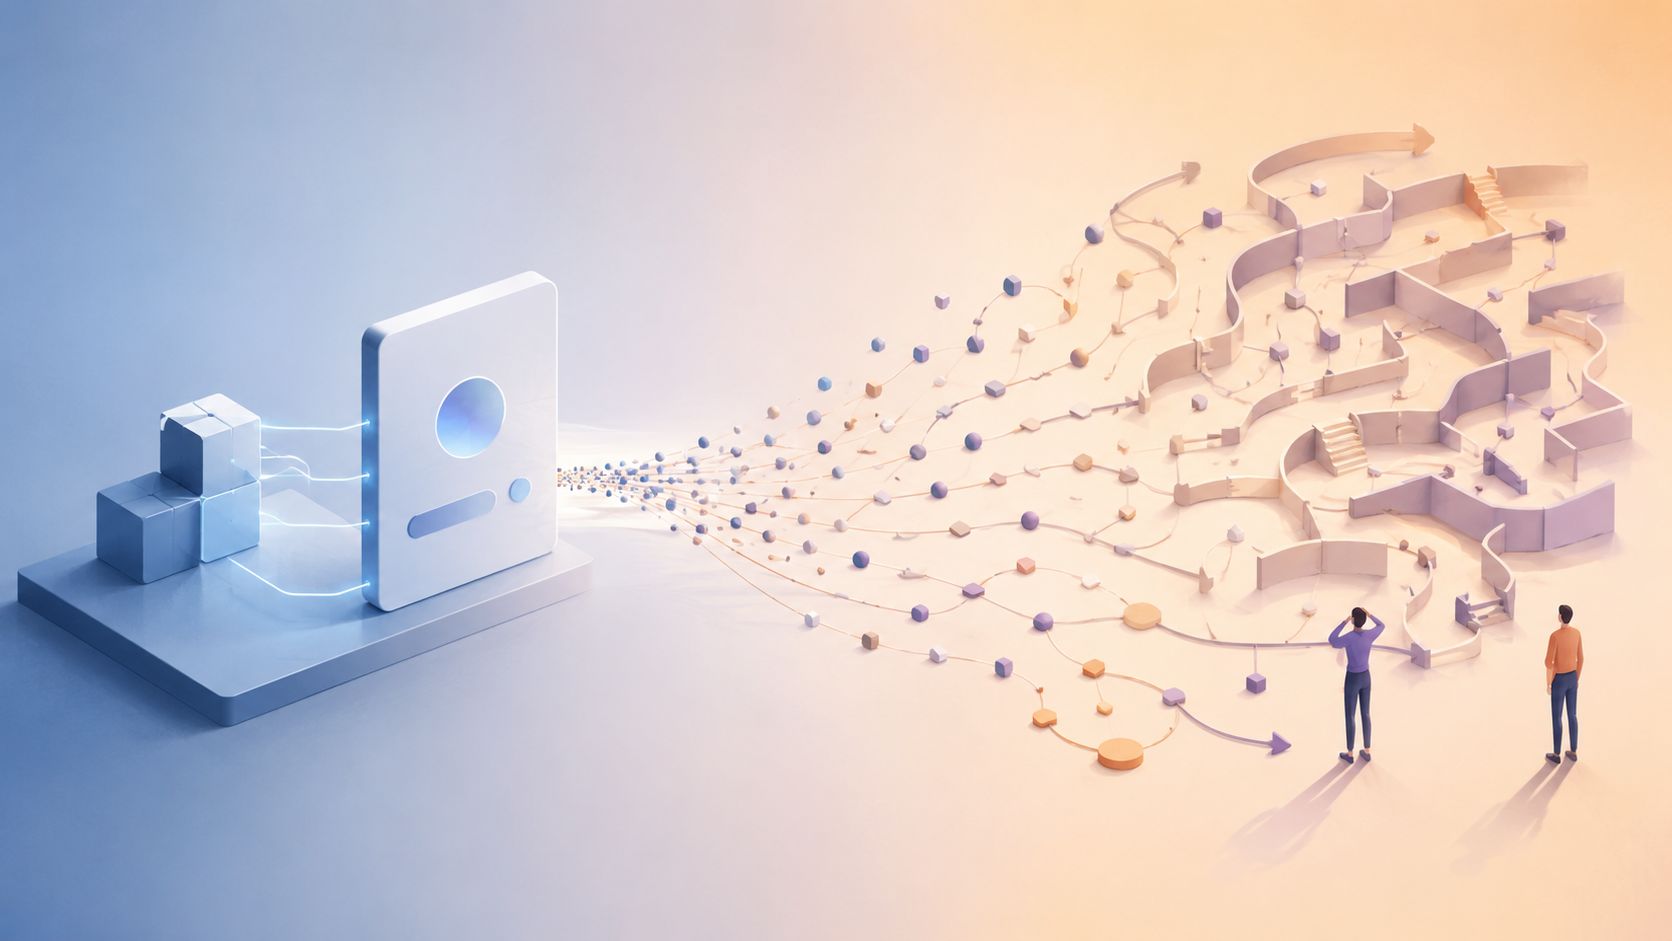
在数字产品领域大量的实践工作中,我们逐渐认识到:复杂度不会消失,它只会在开发者和用户之间转移。当开发者选择“不做某些事情”时,这些事情的复杂度并不会自动消失,而是以另一种形式——决策成本、学习成本、试错成本——转嫁到用户身上。
于是我们开始强调:
简洁不是简单,是极致的克制
这句话的另一面是:每一种克制的背后,都有开发者多承担了一部分复杂度。
复杂度正在被转嫁给用户
一个最简单的例子:用户问 AI “今天天气怎么样”,得到回答“今天气温 28°C,晴,空气质量良。另外我注意到您的日程中有一场会议,是否需要提醒?您也可以开启天气推送服务,或查询未来一周天气。”——这看起来是“周到”,实际上是一次复杂度转嫁:用户需要从一段话中筛选出自己真正需要的信息,还要额外处理多个不请自来的决策分支。
当我们追问“为什么 Agent 会这样回应”时,答案往往是:开发者没有在系统内部完成优先级判断,于是把所有信息都投喂给用户,让用户自己过滤。开发者逃避了“判断什么对用户更重要”的复杂度,用户则被迫承担“在海量输出中寻找答案”的复杂度。
又例如许多产品热衷于展示“功能大全”——工具栏上排满图标,侧边栏塞满入口,首页堆叠各类模块。用户打开应用的首要任务变成了“先弄明白这些东西是干什么的”,而不是“开始做我想做的事”。开发者把“如何组织信息”的复杂度推给了用户,让用户充当自己的信息架构师。
当用户需要先学习一套工具调用逻辑才能使用产品时,开发者只完成了 50% 的工作——实现功能,另外 50%——让功能在正确的时机出现——被丢给了用户。
这种转嫁的后果就是认知负荷陡增。用户把大量精力消耗在“理解界面”上,而非“完成任务”上,产品再强大也变成了一种负担。
开发者该承担什么
开发者应该承担的是系统内部的全部复杂度。
以静态页面托管网站Sited为例,复杂度包括:
技术实现的复杂度。 传统静态网站部署往往涉及服务器、对象存储、目录结构、域名、HTTPS、CDN、构建配置等一系列概念。即使每一项单独来看都不算困难,这些概念的叠加也会形成相当高的入门门槛。而在 Sited 中,整个流程被压缩为三个阶段:“上传内容—配置设置—一键发布”。用户只需要上传文件、拖放文件夹、导入 ZIP 或直接粘贴内容即可完成部署。CDN 配置、SSL 证书、服务器运维、数据库优化——所有这些技术复杂度并没有消失,而是被我们留在了系统内部,用户不需要看到,也不需要理解。任何互联网产品都应如此:底层技术栈的复杂性,应由开发者封装好,只对外暴露最简洁的操作路径。
情境判断的复杂度。 Sited 展示了一个重要的产品原则:简单的用户体验往往建立在复杂的工程实现之上。我们做的并不是删除能力,而是重新分配复杂度。在传统模式中,复杂度由用户承担;在 Sited 的模式中,更多复杂度被转移给系统。这意味着开发者需要做出判断:哪些技术细节是用户完成核心任务所必需的,哪些不是。对任何产品而言,这种情境判断的复杂度同样应由开发者承担——根据用户当前的操作场景,自动预测下一步需求,而不是把所有可能操作平铺出来让用户手动挑选。
优先级排序的复杂度。 “极致的克制”真正克制的是让用户参与技术细节的冲动。开发者可能有能力向用户展示服务器状态、CDN 节点、SSL 配置和大量高级参数,但如果这些信息不是用户完成核心任务所必需的,就不应该因为“系统支持”而强迫用户理解。Sited 将网站部署压缩成上传、配置和发布三步,就是把大量基础设施操作转移给了系统。同样的逻辑适用于所有互联网产品:当产品拥有多个能力时,开发者必须在内部完成优先级评判——在当前场景下,哪些功能应该最显眼,哪些信息应该优先呈现——而不是把排序工作交给用户。
错误处理的复杂度。 在 Sited 中,文件上传失败、部署超时、域名解析异常——所有这些技术故障的处理方案、降级策略、重试机制,全部由我们预先设计好,用户只会看到“部署成功”或“请稍后重试”这样清晰的状态提示,而不会面对任何错误码或调试信息。任何互联网产品都应如此:网络超时、数据格式异常、权限校验失败等所有技术层面的异常,都应该被转化为用户能理解、能行动的语言,而不是把堆栈跟踪或错误代码直接抛出。
用户该承担什么
用户需要承担的,仅限于与其目标直接相关的决策。具体来说:
目标的陈述。 用户需要告诉系统“我想做什么”。这不是复杂度,而是使用任何工具的前提。
关键参数的确认。 某些决策点必须由用户做出,因为系统缺乏必要信息。例如“发送邮件前确认收件人”“支付前确认金额”——这些是高风险的决策,需要人类承担责任。
偏好的表达。 用户可以表达自己的使用习惯,例如“我喜欢简洁的界面”或“我需要高级模式”。但这些偏好应当是“设定一次,长期生效”的系统级配置,而非每次操作都要重复的指令。
反馈和纠偏。 当系统判断错误时,用户需要能够纠正。但纠正本身应该是低成本的——点击一下“不对”或重新输入,而不是进入某个配置面板修改底层参数。
除此之外的一切——功能选择、信息筛选、步骤规划、异常处理——都应该是系统的职责。
复杂度分配失衡的放大效应
互联网产品有一个共同趋势:版本迭代越久,功能越多,界面越拥挤,而开发者往往倾向于用“增加选项”来解决问题——新增需求就加一个新开关,新场景就加一个新入口。久而久之,产品就变成了一个复杂度的堆积场,而每一次堆积都在增加用户的理解负担。
这种堆积之所以危险,是因为互联网产品的用户场景极其多样,开发者不可能预料到每一种用法,于是就用“把控制权全部交给用户”来回避设计决策。但用户不是产品专家,他们只想完成自己的任务。当产品把选择权变成选择负担时,就已经失去了作为工具的基本尊严。
互联网产品一旦形成“复杂就是强大”的认知惯性,就会陷入功能竞赛的囚徒困境,最终所有产品都变得臃肿难用,而最先做出克制的产品反而可能被贴上“功能太少”的标签。打破这种循环,需要开发者主动承担复杂度分配的职责,而不是随波逐流。
结语
回到我们的核心观点:简洁不是简单,是极致的克制。这句话的底层逻辑正是复杂度分配——开发者在系统内部承担了足够多的复杂度,用户才得以面对一个简洁的界面。
我们相信,互联网产品竞争力的分水岭,不在于谁的功能列表更长,而在于谁更清楚地把复杂度留在了系统内部、把简洁留给了用户。用户打开产品的时候,他真正想要的不是看到一排排按钮和选项,而是事情被高效地完成了。
让用户感知不到复杂性的存在,就是开发者对复杂度最好的承担。