科研人员用 AI 写软件,为什么“科学正确”比“代码能跑”更难?
TL;DR
从已知答案、模拟数据、统计性质和交叉验证出发,解释 AI 辅助科研编程如何判断科学结果是否可信。
科研软件的验收不只看程序是否运行,还要看结果是否符合理论、实验和已有工具。本文介绍 AI 辅助科研编程的适用工作,以及已知答案、模拟数据和交叉验证的重要性。
把 AI 用在个人网页上,页面能不能运行往往就是最直观的验收标准。但在科研软件里,“代码能跑”只是起点。一个程序可能没有报错,却使用了错误的参数、改变了统计含义、丢失了精度,或者在特殊数据上产生看似合理但科学上错误的结果。
科学正确不等于软件正确
普通软件通常关心输入、输出、性能和稳定性;科研软件还关心结果是否符合理论、实验和已有工具。一个函数返回了数字,不代表数字有意义;一张图成功生成,不代表趋势解释正确;一个模型训练结束,不代表它没有数据泄漏。
因此,科研人员让 AI 写代码时,需要把领域知识转化成可验证的参考。可以是已知答案、模拟数据、守恒定律、统计性质、已有软件的结果,或专家明确规定的范围。没有外部参照,模型很容易把“格式正确”误判为“结论正确”。
AI 在科研软件里适合做什么
它适合处理重复的工程工作:补充数据读取器、重构目录、编写测试、增加日志、转换语言、包装命令行接口、整理文档和搭建实验脚本。这些任务如果有清晰输入和可测输出,AI 能减少工程负担,让研究人员把更多时间放在问题设计上。
它不应该独立决定实验方法、解释异常结果或选择关键统计假设。模型可以提出候选方案,但专业人员必须确认其科学含义。
怎样为科研代码建立验收标准
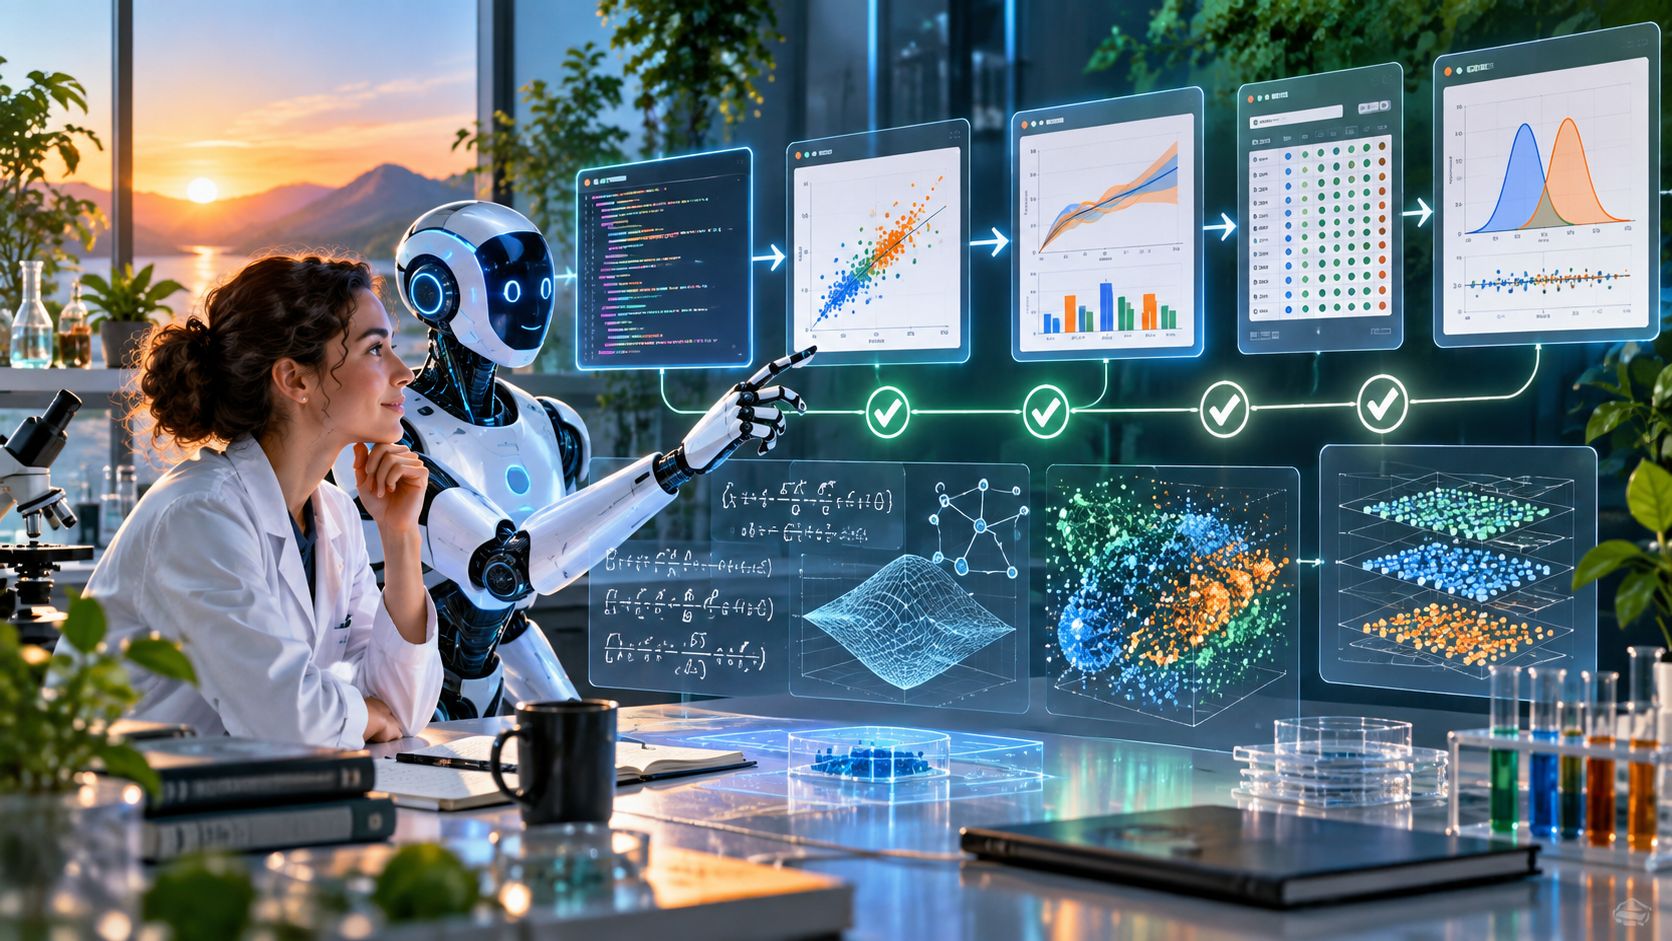
第一,准备最小的已知数据集,结果要能和参考答案比较。第二,使用模拟数据覆盖边界,例如空样本、极端值、缺失值和不同单位。第三,比较的不只是字符串或代码形式,还要比较结果、误差范围和关键统计性质。第四,记录运行环境、随机种子、参数和输入版本,保证结果可以复现。
当 AI 修改已有算法时,可以先要求它生成等价性测试,再让它实施重构;当 AI 新增计算方法时,可以让它与成熟工具或独立实现做交叉验证。越重要的结果,越不应该只有模型自己检查自己。
为什么人的判断仍然是瓶颈
科研人员最清楚什么结果值得信任,但往往没有足够时间修补所有工程细节。AI 能提高实现速度,却不会自动知道一个近似是否破坏了实验结论。OpenAI 分享的科研软件案例也指出,Agent 能有效处理边界清楚的请求,但判断科学有效性仍然依赖外部参考和人的专业判断。
适合大众理解的类比
让 AI 写科研程序,就像让一位很快的实验助理搭建仪器:它可以按说明连接线路、整理记录和重复测量,但不能仅凭仪表亮灯就判断实验结论成立。真正可靠的科研 Vibe Coding,需要把“能运行”升级为“可验证、可复现、符合领域规律”。