AI 写 SQL 和数据库迁移,为什么必须人工确认
TL;DR
从数据语义、锁、兼容发布、回滚和真实数据量出发,解释 AI 生成数据库迁移为什么必须经过人工确认。
数据库迁移会改变持久数据、锁和应用契约,语法正确不代表上线安全。本文解释 AI 生成 SQL 的风险,介绍扩展、迁移、收缩的兼容策略,以及生产执行前应检查的门槛。
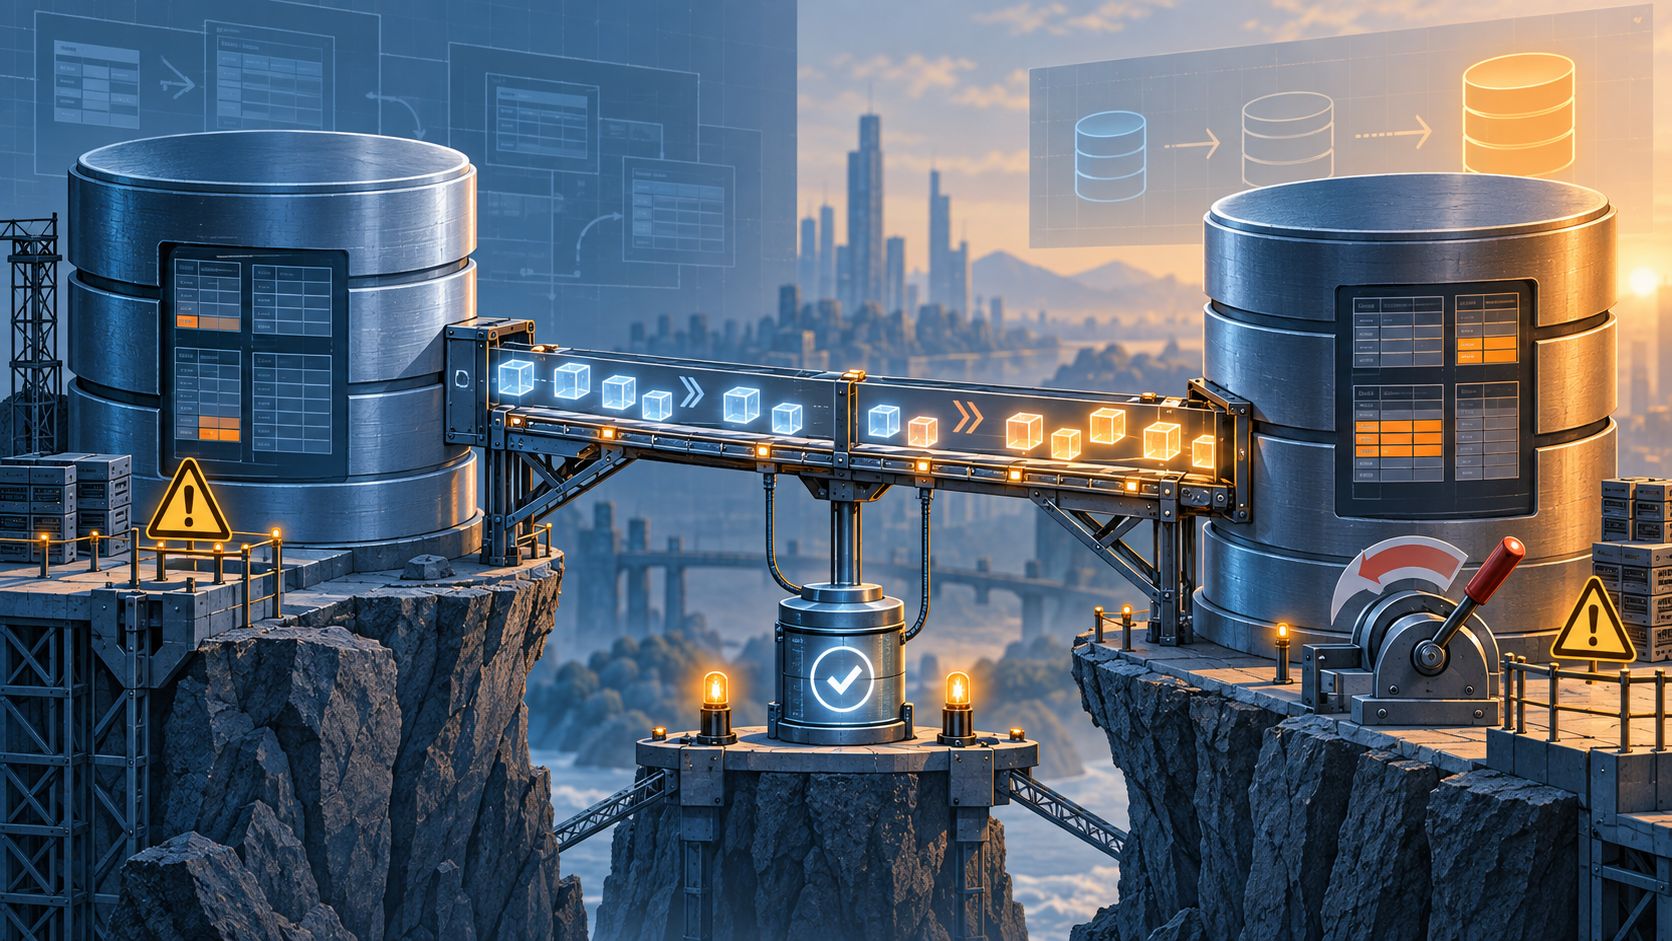
让 AI 写一条查询语句很容易,真正危险的是让它修改数据库结构。增加一列看起来只是几行 SQL,实际可能锁住大表、打断旧版本服务、改变数据含义,甚至在回滚时发现旧数据已经无法恢复。数据库迁移不是“把代码翻译成 SQL”,而是对正在运行的系统进行状态变更。
查询可以试错,迁移不能只看语法
普通查询的主要问题是结果不对或速度太慢;迁移还会带来持久影响。AI 生成的 ALTER TABLE 可能语法正确,却没有考虑表规模、索引、默认值、锁行为和并发写入。给一张在线大表添加非空列,和在本地空数据库里执行同一条语句,风险完全不同。
模型也可能根据一个不完整的 schema 做出假设:把“用户编号”当成唯一值,把时间当成本地时区,把删除理解成物理删除。只要业务语义没有写清楚,SQL 再漂亮也可能改变错误的数据。
迁移最重要的是顺序
安全的结构变更通常采用向后兼容的多步策略。以重命名字段为例,可以先增加新字段,让旧代码和新代码同时读写;再回填历史数据;发布只读取新字段的版本;确认稳定后,最后删除旧字段。每一步都可以单独验证和回滚,而不是一次性让所有服务切换。
这种“扩展、迁移、收缩”的思路尤其适合由 AI 辅助,因为你可以要求模型每次只处理一个可验证阶段,并列出旧版本仍然能够工作的条件。若它直接生成一条破坏兼容性的重命名语句,往往说明任务边界还不够清楚。
给 AI 的数据库任务应该包含哪些信息
至少提供:数据库类型和版本、表结构、数据量级、读写高峰、应用的部署顺序、是否允许短暂锁表、备份与回滚策略,以及不允许改变的业务规则。不要只贴一张表定义就让模型“优化数据库”。
执行前让 AI 输出三份东西:迁移 SQL、影响分析和验证步骤。影响分析要回答会锁哪些对象、是否需要全表扫描、旧代码是否仍能运行、失败时如何恢复。验证步骤应包含约束、行数、抽样数据和应用接口,而不只是“命令返回成功”。
人工确认的最低门槛
在生产执行前,人工核对四点:
- 变更是否符合业务语义,而不是仅符合语法。
- 事务边界、锁和索引是否适合真实数据量。
- 发布顺序是否保证新旧版本短暂共存时仍可工作。
- 备份、监控、回滚和演练是否真实存在。
PostgreSQL 的官方文档把 ALTER TABLE 作为数据定义语言的一部分说明,这提醒我们:表结构不是普通配置,而是数据库契约。无论使用哪种数据库,执行前都应阅读对应版本的官方说明,确认默认行为而不是依赖模型记忆。
让 AI 帮忙做“危险前的准备”
AI 很适合生成只读的检查查询、解释执行计划、补充迁移测试、列出依赖表和设计回滚草案。它也适合在沙箱数据库里反复演练。真正写入生产前,保留人工批准,并让工具权限与环境分级:开发环境可自动执行,预发布环境需确认,生产环境只允许受控流水线执行。
Vibe Coding 可以加速数据库工作的准备阶段,却不能把责任变成自动化按钮。凡是会改变持久数据的操作,都应让“可回滚、可观察、可解释”先于“生成得很快”。