SSA:为什么编译器喜欢让变量“只赋值一次”
TL;DR
用简单例子理解静态单赋值 SSA,以及它如何帮助编译器优化和 AI 代码分析。
通过变量版本和分支合并的直观例子,理解 SSA 如何帮助编译器、静态分析器和 AI 工具追踪值的来源。
SSA:为什么编译器喜欢让变量“只赋值一次”
在普通代码里,同一个变量可以被反复修改:先是 0,后来变成 1,再经过条件判断变成另一个值。编译器为了更容易分析这些变化,常把程序转换成 SSA,也就是 Static Single Assignment,静态单赋值形式。它的核心规则很简单:每个变量版本只被赋值一次。
变量改名不是为了让代码更难读
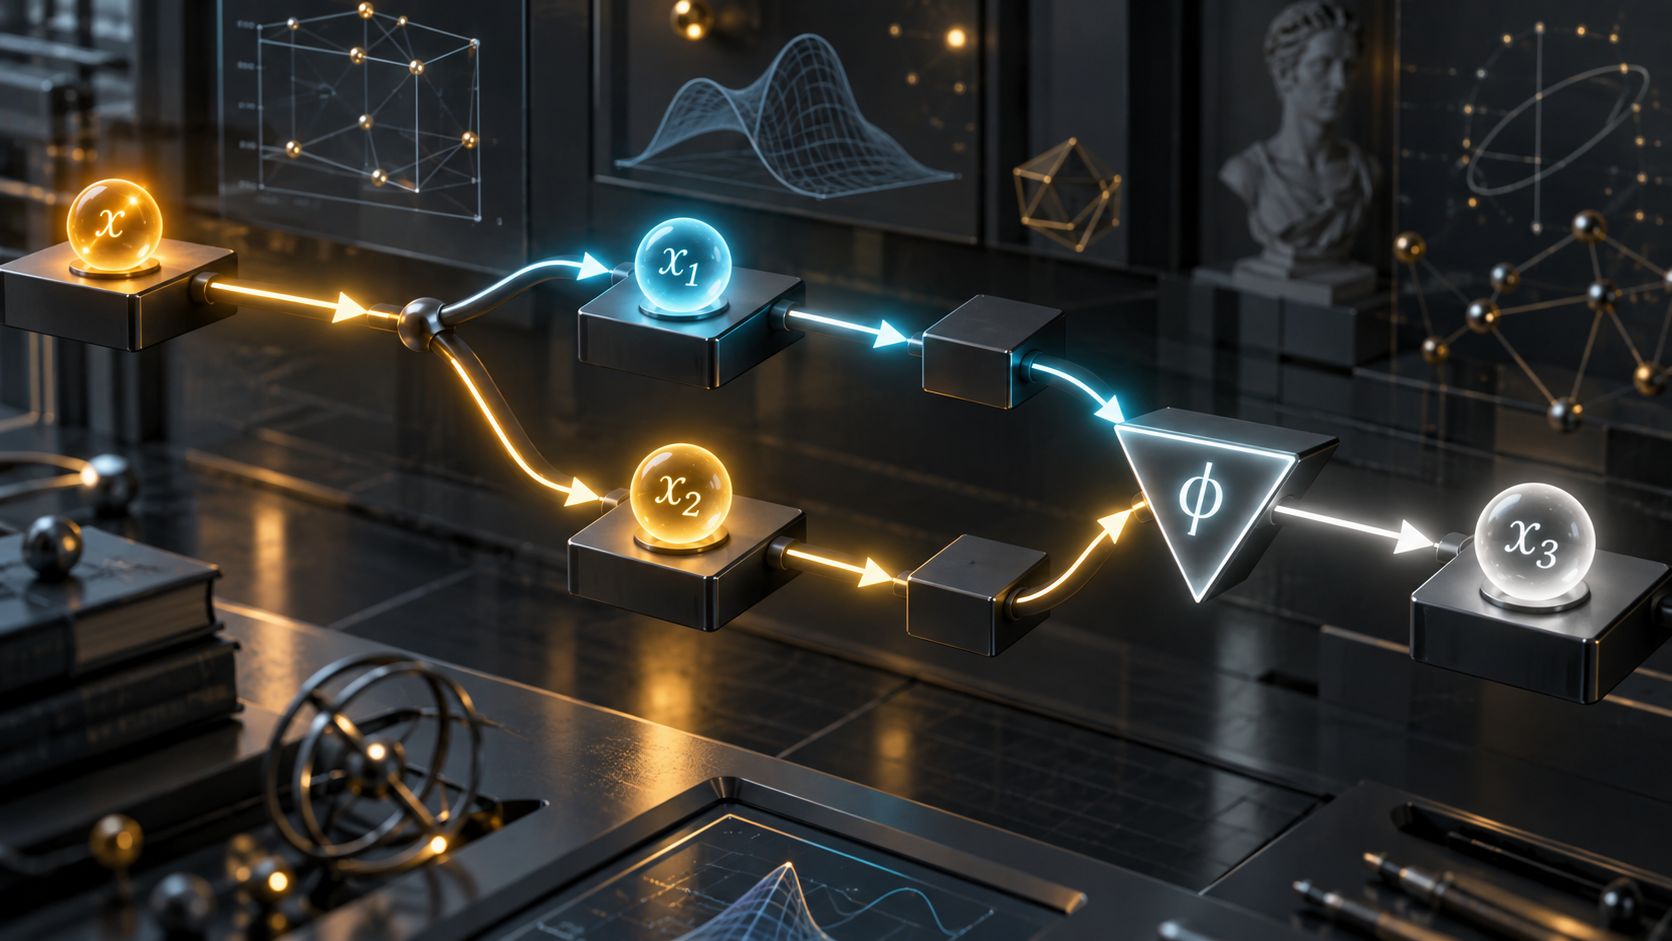
例如原始代码里有 x = 1,之后又有 x = x + 2。在 SSA 表示中,它们可能变成 x1 = 1 和 x2 = x1 + 2。这不是给程序员增加负担,而是把“哪个值来自哪次赋值”明确标出来。条件分支汇合时,编译器还会使用特殊的合并节点,表示这个位置可能接收不同路径产生的值。
一旦每个版本只有一个来源,编译器就更容易做常量传播、死代码删除、范围分析和依赖判断。很多看似复杂的优化,其实都建立在“值的来源更清楚”这个基础上。
它和 AI 编程有什么关系
AI 生成代码时,常见问题是变量被多次重写,或者在一条路径上可能未初始化。模型如果只看表面文本,很容易把几个同名变量混为一谈。SSA 这样的中间表示,提供了更精确的值流线索:一个表达式使用的是哪个变量版本,某个返回值经过了哪些赋值。
这对自动重构和静态检查尤其重要。工具可以判断某个变量是否真的被使用、某个计算是否永远不会影响结果,以及一个条件分支是否改变了后续值。AI 负责生成候选代码,编译器中间表示则帮助发现候选代码在数据层面的矛盾。
SSA 也不是业务理解
SSA 能追踪值的产生和传播,却不知道“金额不能为负”“状态不能从已支付退回待支付”这样的业务规则。它擅长回答程序结构问题,不擅长替代产品和领域判断。因此,SSA 能提高代码分析质量,却不能单独证明软件符合需求。
一个实用的理解方式
当你看到编译器、静态分析器或 AI 代码工具在讨论 IR、变量版本和数据流时,可以把 SSA 想成一份“值的出生证明”。它让每个值的来源更容易被追踪,也让机器更容易判断修改是否改变了真正的计算关系。
LLVM 对 SSA 的基础描述见 LLVM Language Reference Manual。