Semantic Diff:代码改了多少行,不等于逻辑改了多少
TL;DR
从代码移动、重命名和格式化出发,理解语义 Diff 如何减少 AI 代码审查中的噪声。
语义差异比较从函数、类和表达式层面理解代码变化,帮助人和 AI 区分真正的逻辑修改与格式噪声。
Semantic Diff:代码改了多少行,不等于逻辑改了多少
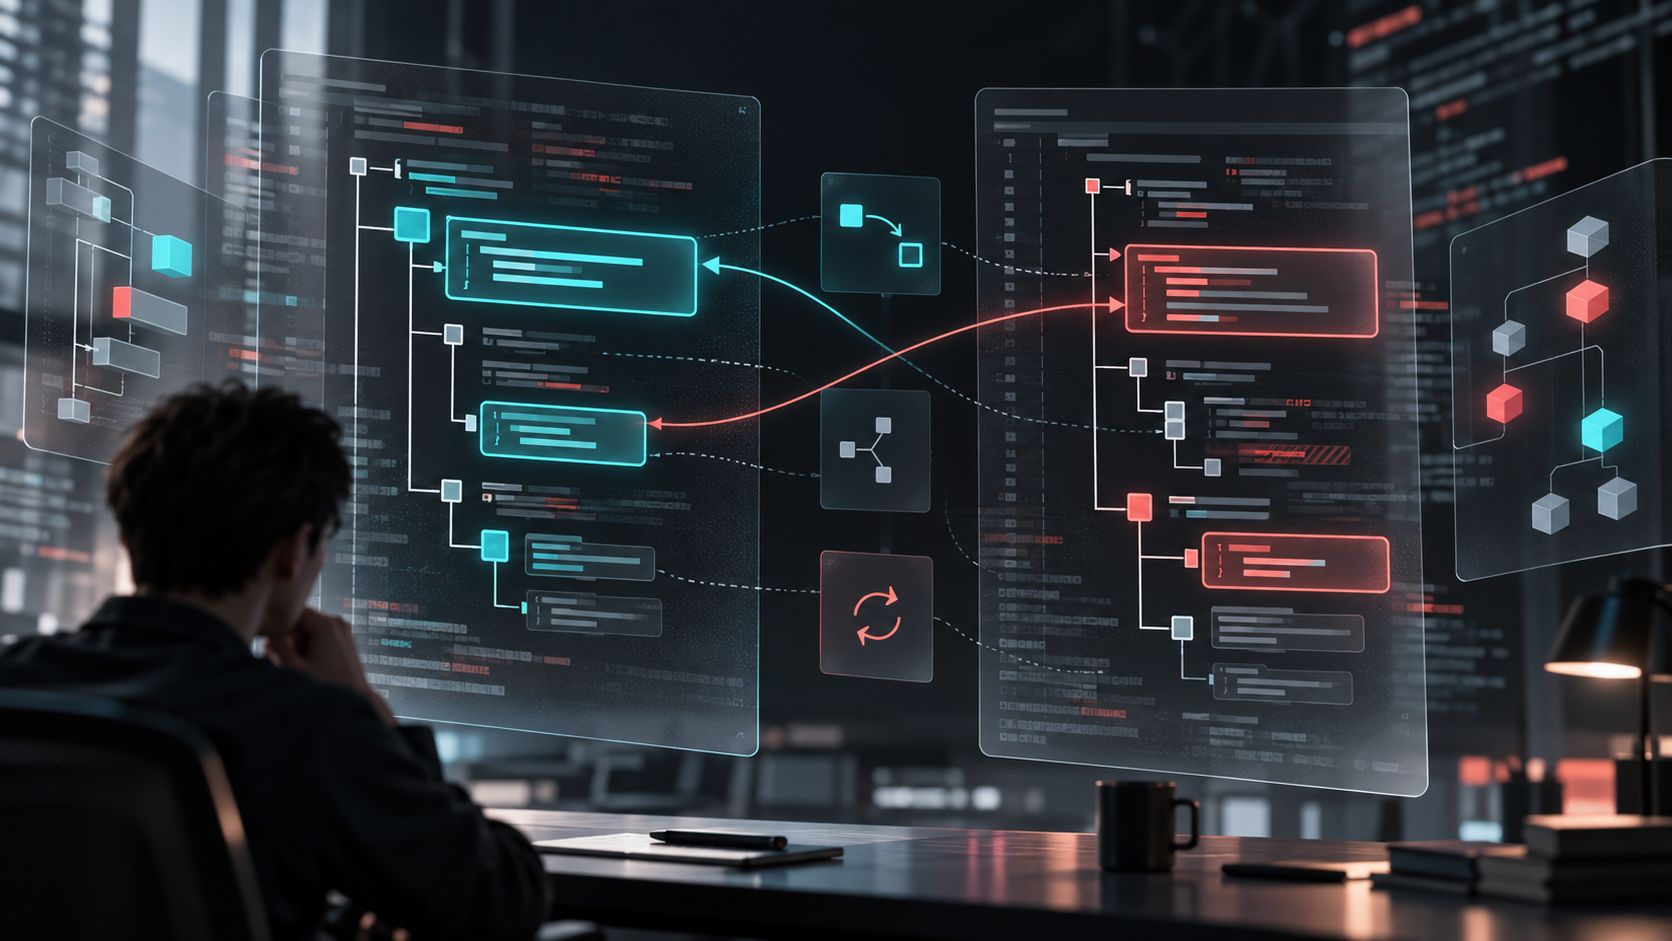
传统 diff 通常逐行比较文本。空格、换行、格式化和代码移动,都可能制造大量红色和绿色区域。Semantic Diff,语义差异比较,则尝试先理解代码结构,再比较函数、类、变量和表达式发生了什么变化。
文本差异为什么会误导人
把一个函数从文件顶部移到文件底部,逐行 diff 可能显示整段代码被删除又新增。统一格式化也可能让整份文件看起来都变了。审查者必须在大量噪声中寻找真正的逻辑变化,AI 代码生成速度越快,这种审查压力越大。
语义 diff 会把“移动”“重命名”“新增参数”“条件改变”和“实现替换”区分开。它不一定能理解业务含义,但至少能把结构上的变化表达得更接近程序员真正关心的问题。
它为什么适合 AI 编程
AI 常常会重新排版、调整导入顺序、拆分函数或重写一段实现。把普通文本 diff 直接塞给另一个模型,会浪费上下文在格式变化和重复代码上。结构化 diff 可以帮助审查 Agent 聚焦真正改变的实体。
对人类审查者来说,语义 diff 也提供了更好的提问入口:这个函数的输入输出是否改变?某个权限判断是否被移动?是否新增了一个外部调用?这种问题比“请检查这 500 行红绿文本”更具体。
语义 diff 也有边界
不同语言需要不同解析和匹配规则;宏、动态代码和生成文件可能难以准确比较。更重要的是,结构相同不代表行为相同,结构差异也不一定代表业务变化。最终审查仍需结合测试、调用关系和需求。
一个实用工作流
先用普通 diff 确认修改范围没有超出任务,再用结构化视角查看函数和接口变化,最后运行测试与静态检查。让 AI 总结“新增、删除、移动、重命名和行为变化”五类信息,可以明显降低审查遗漏。
语义差异工具的基本思路可参考 SemanticDiff 官方说明。