PagedAttention:大模型推理为什么也需要“内存分页”?
TL;DR
PagedAttention 把大模型推理时不断增长的 KV Cache 切分为固定大小的块,并通过映射表管理它们,减少连续分配带来的浪费。本文用图书馆书架解释它如何提升显存利用率,以及为什么它不是压缩算法或质量增强技术。
PagedAttention 把大模型推理时不断增长的 KV Cache 切分为固定大小的块,并通过映射表管理它们,减少连续分配带来的浪费。本文用图书馆书架解释它如何提升显存利用率,以及为什么它不是压缩算法或质量增强技术。
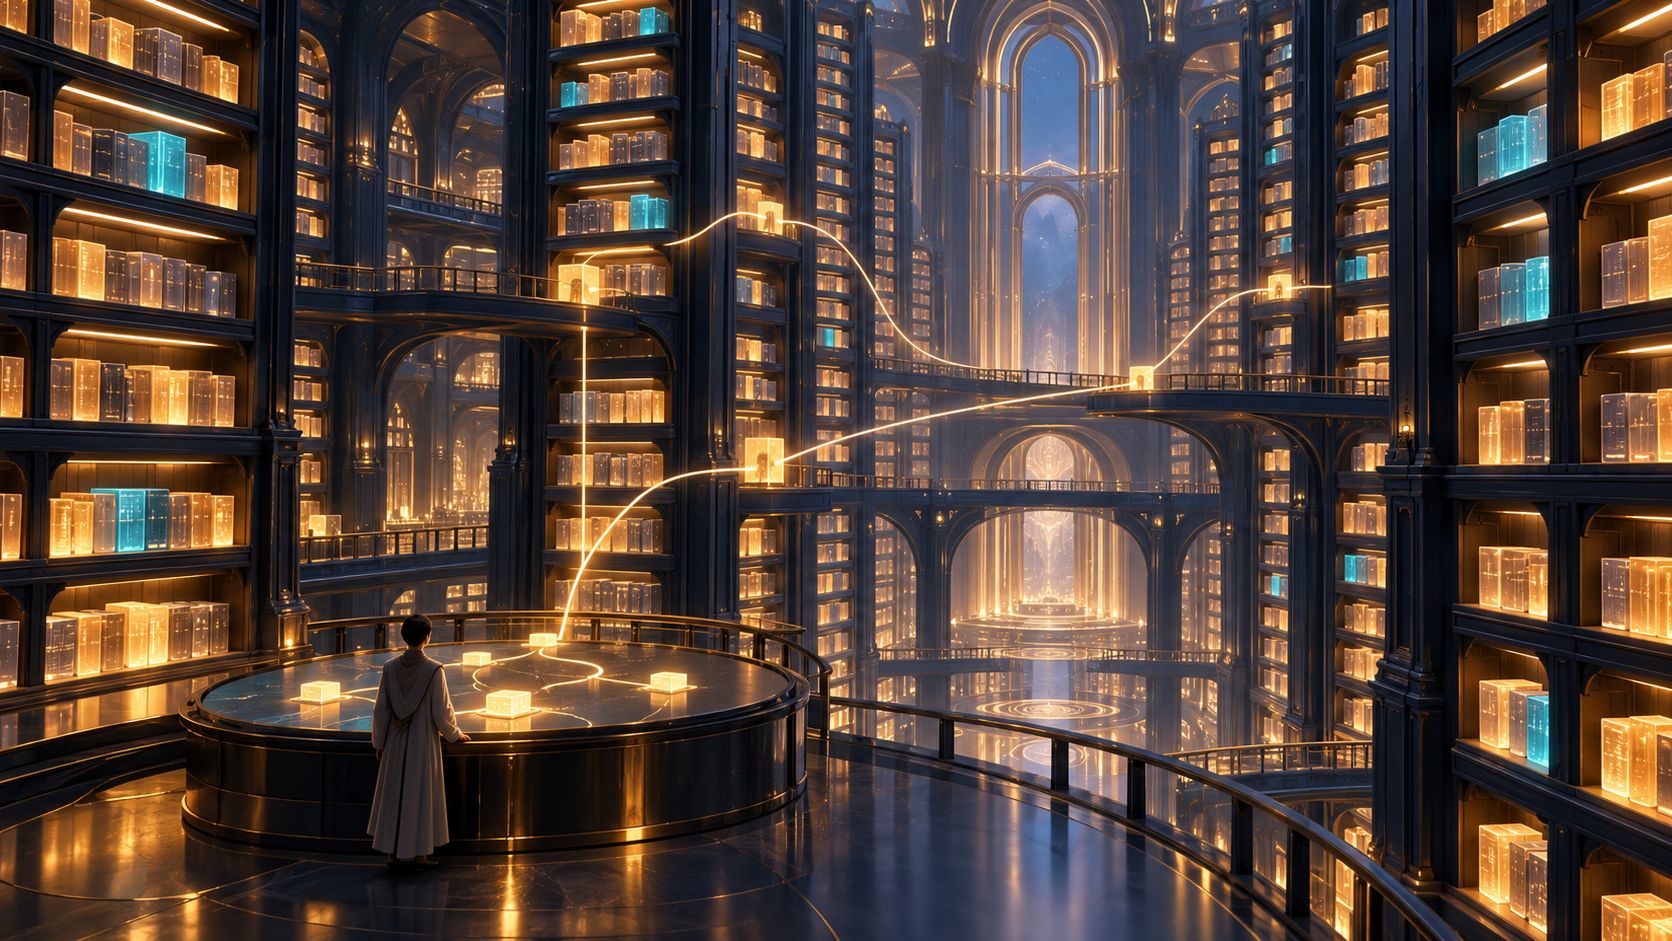
大语言模型生成回答时,会不断积累此前 token 的键和值,也就是 KV Cache。对话越长、并发请求越多,这块缓存越大。若每个请求都预留一整段连续显存,真实使用长度各不相同,就像图书馆为每位读者预留一排书架:有人只放几本,大片空间却被占着;有人还没座位,整体利用率不高。
把缓存切成小页来管理
PagedAttention 的灵感来自操作系统虚拟内存分页。它把每个请求的 KV Cache 分成固定大小的块,块在物理显存中不必连续存放;系统用映射表记录逻辑 token 位置对应哪个物理块。注意力计算需要相关缓存时,再按映射关系取出所需内容。
这种做法允许按需分配,避免为每个请求预留一整段连续空间。请求增长时再增加块,结束后释放块,系统也更容易管理不同长度的会话。论文展示的 vLLM 系统还利用块管理探索缓存复用等优化;具体实现收益会因模型、请求长度和硬件而异。
可以把它看成共享图书馆的可移动书架:每个读者的书仍按阅读顺序排列,但书架不必在房间里相邻。管理台维护目录,计算时按目录把需要的页找回来。空间碎片减少后,同一块显存可能承载更多并发请求,从而改善整体服务吞吐。
分页不等于压缩,也不改变模型知识
PagedAttention 不会把 KV Cache 中的数据变小,也不改变模型参数、答案质量或推理逻辑。它优化的是缓存的分配与访问方式。显存带宽、计算能力、缓存块大小、批处理策略和请求模式,仍会共同决定性能;访问非连续数据也需要额外的映射与调度设计。
如果单个请求极长、并发很低,或工作负载本来就没有明显的内存碎片,分页策略的好处可能有限。不同推理框架使用的具体实现也不完全相同,不能仅凭“用了 PagedAttention”推断固定的速度提升。
理解它的关键是认清被分页的是推理过程的 KV Cache,而不是模型文件或用户聊天记录。PagedAttention 是一种显存管理与注意力访问系统设计,帮助推理服务把有限显存安排得更灵活,最终收益要看真实请求形态与硬件配置。
来源:论文:Efficient Memory Management for Large Language Model Serving with PagedAttention