1.58 比特大模型:参数只有 −1、0、1,为什么还能推理?
TL;DR
解释 1.58 bit、三值权重、原生低比特训练与 INT4 量化的区别,以及低比特大模型对硬件和端侧部署的意义。
BitNet b1.58 让模型从训练阶段就使用 −1、0、1 三值权重,探索更低的内存、延迟和能耗。本文解释 1.58 bit 的由来、原生低比特与 INT4 量化的区别、零值的作用,以及为什么收益依赖硬件和运行时。
大语言模型的参数通常用 FP16、BF16 或 INT8 等数值表示。数值越精细,模型越容易保留表达能力,但权重占用的内存和计算搬运也越多。于是一个很诱人的问题出现了:如果模型参数只保留极少几种取值,它还能正常工作吗?
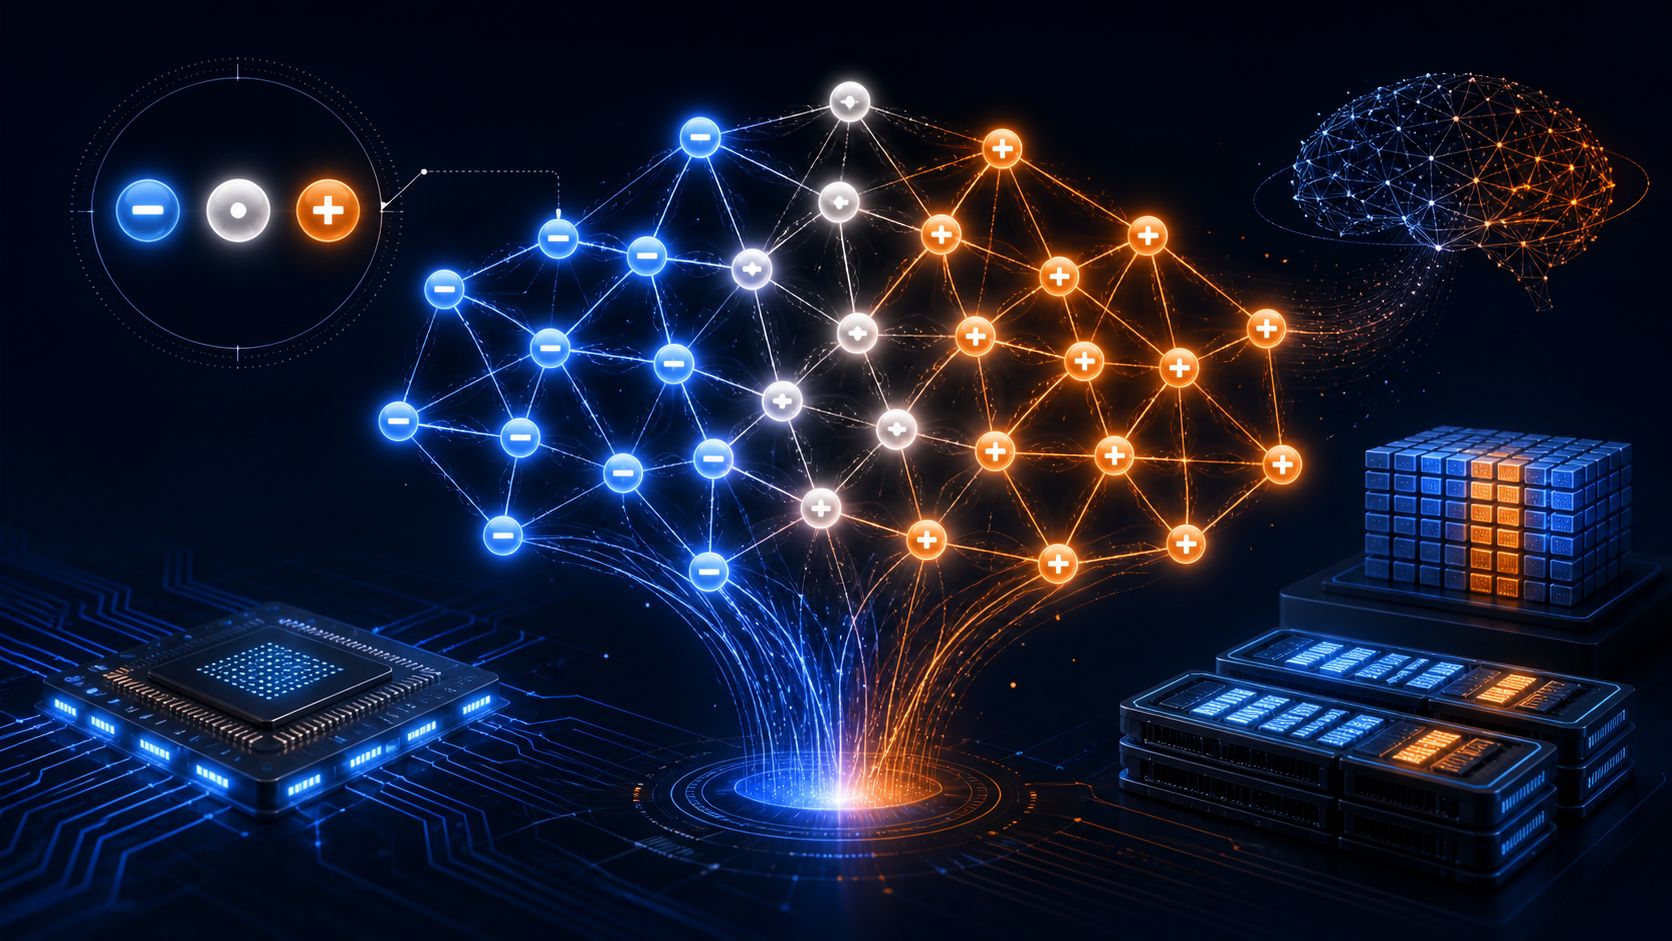
BitNet b1.58 给出了一个重要的研究方向:让模型从训练开始就使用三值权重,参数取值为 −1、0 或 1。这里的“1.58”不是把一个普通模型简单压缩成 1.58 bit,而是改变模型的训练和计算方式。
先给结论:1-bit LLM 不是普通量化的极限档
普通量化通常是先训练一个全精度模型,再把权重映射到更低位数,例如 INT8、INT4。它的目标是在尽量少损失精度的情况下减少存储和推理成本。
BitNet 的路线更激进:模型本身在训练时就围绕低比特权重设计。Microsoft Research 对 BitNet b1.58 的介绍指出,其权重使用三值集合 {-1, 0, 1},并探索在较低内存、延迟和能耗下保持竞争力的语言模型。Microsoft Research:The Era of 1-bit LLMs
所以,“1-bit”更接近一种原生架构和硬件协同设计,而不是给现有模型拧一个压缩旋钮。
为什么是 1.58 bit
如果每个参数只有三种状态,理论上需要表示 3 种可能性。信息论中的位数约为 log₂3,也就是大约 1.585 bit,因此常被简称为 1.58 bit。
真正存储时,计算机通常不会把每三个权重直接塞成一个奇怪的 1.58 位字段。工程实现可以使用打包、位运算或专门的内核来表达三值权重。这个名字强调的是每个参数可表达的信息量,而不是某个通用文件格式。
它为什么可能更省
以普通全精度权重为例,每个参数通常需要 16 位甚至更多存储空间。模型运行时,权重需要不断从内存或显存搬到计算单元。对大模型来说,数据搬运和内存带宽往往是重要瓶颈。
三值权重带来两个潜在优势:
- 权重更紧凑:同样参数量需要搬运的数据更少。
- 计算更简单:与三值权重相乘时,一部分操作可以转化为加法、减法或跳过,而不是执行完整的浮点乘法。
但这并不意味着所有硬件都能自动获得同样的加速。实际收益取决于内存布局、打包方式、指令集、编译器和内核实现。一个理论上更省的模型,如果没有匹配的运行时,可能只是换成了更复杂的解码流程。
从一个矩阵乘法看直觉
普通矩阵乘法会把输入值和权重值相乘,再累加;三值权重可以把每个权重看成三种动作:
权重为  1:把输入加到累加器
权重为  0:跳过这一次
权重为 -1:从累加器中减去输入
这只是帮助理解的简化模型。真实 BitNet 还涉及缩放因子、激活值精度、训练时的梯度处理和具体硬件内核,不能把它直接等同于“模型只做加减法”。
它和 INT4 量化有什么区别
| 方向 | INT4 量化 | 原生 1-bit/1.58-bit 模型 |
|---|---|---|
| 起点 | 先训练全精度模型 | 从训练阶段就采用低比特设计 |
| 权重取值 | 通常有更多离散等级 | 以少量离散值为核心 |
| 迁移成本 | 可以直接处理已有模型 | 需要重新训练或使用专门模型 |
| 兼容性 | 生态和工具相对成熟 | 更依赖专门运行时与硬件 |
| 主要问题 | 量化误差 | 训练稳定性、表达能力和生态成熟度 |
因此,1-bit LLM 不是“INT4 的下一档菜单”,而是模型、训练算法、编译器和芯片一起改变的一条路线。
为什么零值也很重要
三值集合中的 0 不只是少一种数字,它意味着某些连接可以在当前计算中被跳过。对于稀疏性友好的硬件和内核,这可能带来额外机会;但如果零值分布不规则,硬件为了跳过它们而产生的索引和分支开销,也可能抵消收益。
所以不能只看“每个权重有几种取值”,还要观察这些取值如何分布,以及硬件是否真的能利用这种分布。
低比特不等于低能力
模型能力取决于架构、参数量、训练数据、优化过程和推理方式。减少权重精度通常会压缩表示空间,但原生低比特训练可以让模型从一开始就适应这种约束。BitNet 研究报告了与全精度 Transformer 进行性能比较的结果,但这些结果属于特定模型、数据和实验设置,不能直接推广成“所有任务都不会损失精度”。
尤其要警惕三个误区:
- 研究模型的结果不等于所有开源模型都能直接转换;
- 参数存储变小不等于总显存一定按同样比例下降,激活和 KV Cache 仍然存在;
- 推理速度取决于实现,不能只根据位数计算。
它可能改变什么
如果原生低比特模型和匹配硬件逐渐成熟,模型部署可能从“尽量把大模型塞进 GPU”转向“让模型从训练开始就适配目标设备”。CPU、边缘设备和低功耗终端都可能因此获得更多可运行的模型选择。
但这需要完整生态同时跟上:训练框架要能处理低比特权重,编译器要生成高效内核,模型仓库要提供可靠权重,评测还要覆盖速度、能耗、准确率和长上下文表现。
一句话总结:1-bit LLM 的价值不在于把数字变小,而在于重新设计“模型应该怎样被计算”。