不做 OCR 也能搜 PDF?视觉文档检索怎么工作
TL;DR
解释 ColPali 如何绕过纯 OCR 流程,直接对 PDF 页面图像建立多向量索引,并分析视觉 RAG 的优势与成本。
ColPali 直接把 PDF 页面作为图像进行多向量检索,保留表格、图表和版式信息。本文解释视觉文档检索、late interaction、RAG 接入方式和索引成本。
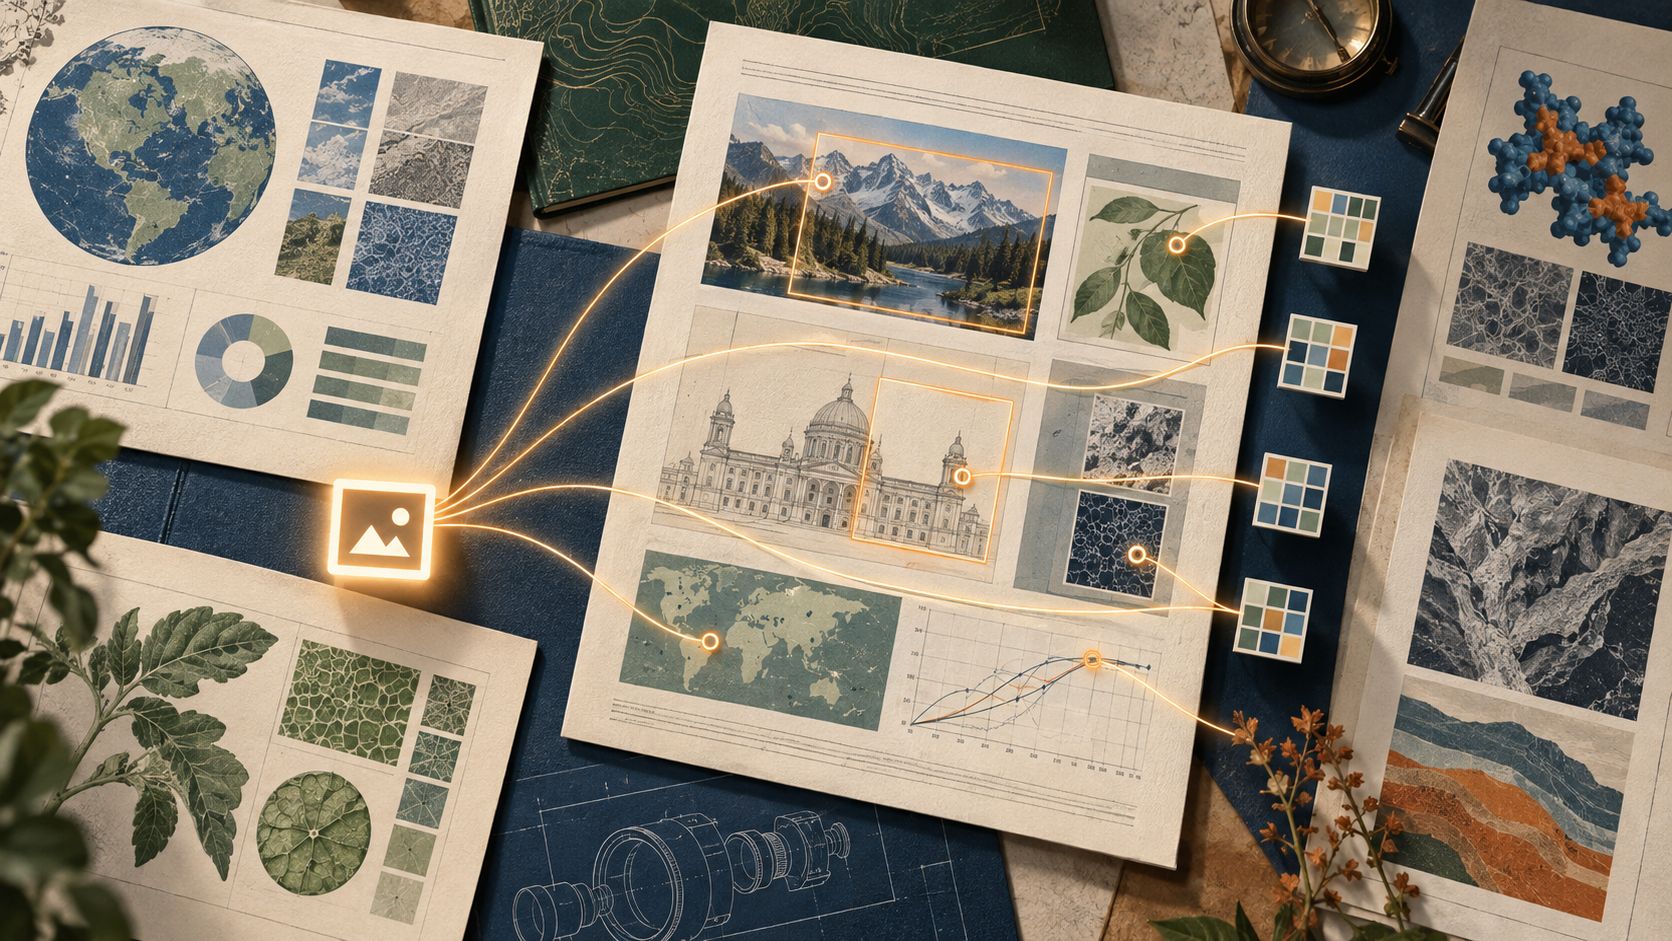
很多 PDF 看起来是“文字文档”,实际上信息可能藏在表格的空间关系、图表的坐标、标题的层级和页面的排版里。传统文档 RAG 通常先做 OCR,再把文字切块、嵌入和检索。只要 OCR 把表格列错位,或者把脚注和正文混在一起,后面的检索就会继承这个错误。
ColPali 提供了另一种思路:不急着把页面还原成纯文字,而是直接把渲染后的文档页面当作图像进行检索。它使用视觉语言模型为页面生成多向量表示,再用查询和页面之间的细粒度匹配找出相关页面。
从一页 PDF 到一次检索
可以把 ColPali 风格的流程拆成四步。第一步,把 PDF 页面渲染成图像;第二步,视觉编码器把页面中的文字、图表和布局转换成一组向量,而不是压缩成一个向量;第三步,查询文本也被编码成一组向量;第四步,在查询向量和页面向量之间执行 late interaction,计算它们的细粒度相关性。
这里的“多向量”很关键。一页页面不是一个单一概念:左上角可能是标题,右侧是价格表,底部是脚注。保留多个局部表示,检索系统就有机会把查询中的不同词与页面上不同区域对应起来,而不是让所有信息被平均到一个向量中。
它为什么能避开一部分 OCR 问题
OCR 管线的优势是结果容易进入传统搜索和数据库:你可以按词、段落、页码和坐标索引文本。但它也需要在识别、阅读顺序、表格恢复和图片理解之间做一连串转换。视觉检索直接保留页面外观,因此对复杂排版、表格和图文混排更自然。
这并不意味着 OCR 没用了。检索只需要回答“哪一页可能相关”,而最终回答往往仍需要精确读取数字、复制字段或引用原文。实际系统可以把视觉检索用作第一阶段召回,再用 OCR、版面分析或视觉语言模型完成第二阶段抽取。
多向量也带来新的成本
一页文档不再对应一个向量,而是对应一组与图像 patch 或视觉 token 相关的向量。页面越多,索引占用和相似度计算就越需要规划。查询时的 late interaction 也比单向量近邻搜索更复杂,必须考虑候选数量、向量压缩、缓存和批处理。
另外,视觉模型并不会自动解决所有语义问题。低分辨率扫描件、手写内容、极细小字体和跨页表格仍然可能被误读;只检索到正确页面,也不代表模型就能准确解释其中的数字。因此,评测不能只看页面召回率,还要看最终回答是否引用了正确区域、是否保留了表格关系,以及不同文档模板之间能否泛化。
适合什么场景
视觉文档检索适合合同、财报、说明书、表单、学术论文和带大量图表的企业资料。对于结构简单、纯文本占主导的知识库,普通文本嵌入可能更便宜、更容易维护。选择 ColPali 一类方案的理由,不应该是“视觉模型更先进”,而应该是原始文档的视觉结构本身就是信息。
ColPali 的启发不只是换了一个嵌入模型,而是重新定义了文档进入检索系统的方式:文档不一定要先被压扁成文字,页面的空间和视觉结构也可以成为可检索的表示。对 RAG 来说,这为复杂 PDF 提供了一条更接近原始信息形态的路径,但工程上仍需要在召回质量、索引成本和精确抽取之间做平衡。
来源:ColPali:Efficient Document Retrieval with Vision Language Models