Monomorphization:泛型代码为什么会被编译成很多份?
TL;DR
Monomorphization 会为实际使用到的具体类型生成专门代码,让泛型在运行时更接近手写实现,但也可能增加编译时间和二进制体积。本文用模板机器解释 Rust 的单态化及其工程取舍。
Monomorphization 会为实际使用到的具体类型生成专门代码,让泛型在运行时更接近手写实现,但也可能增加编译时间和二进制体积。本文用模板机器解释 Rust 的单态化及其工程取舍。
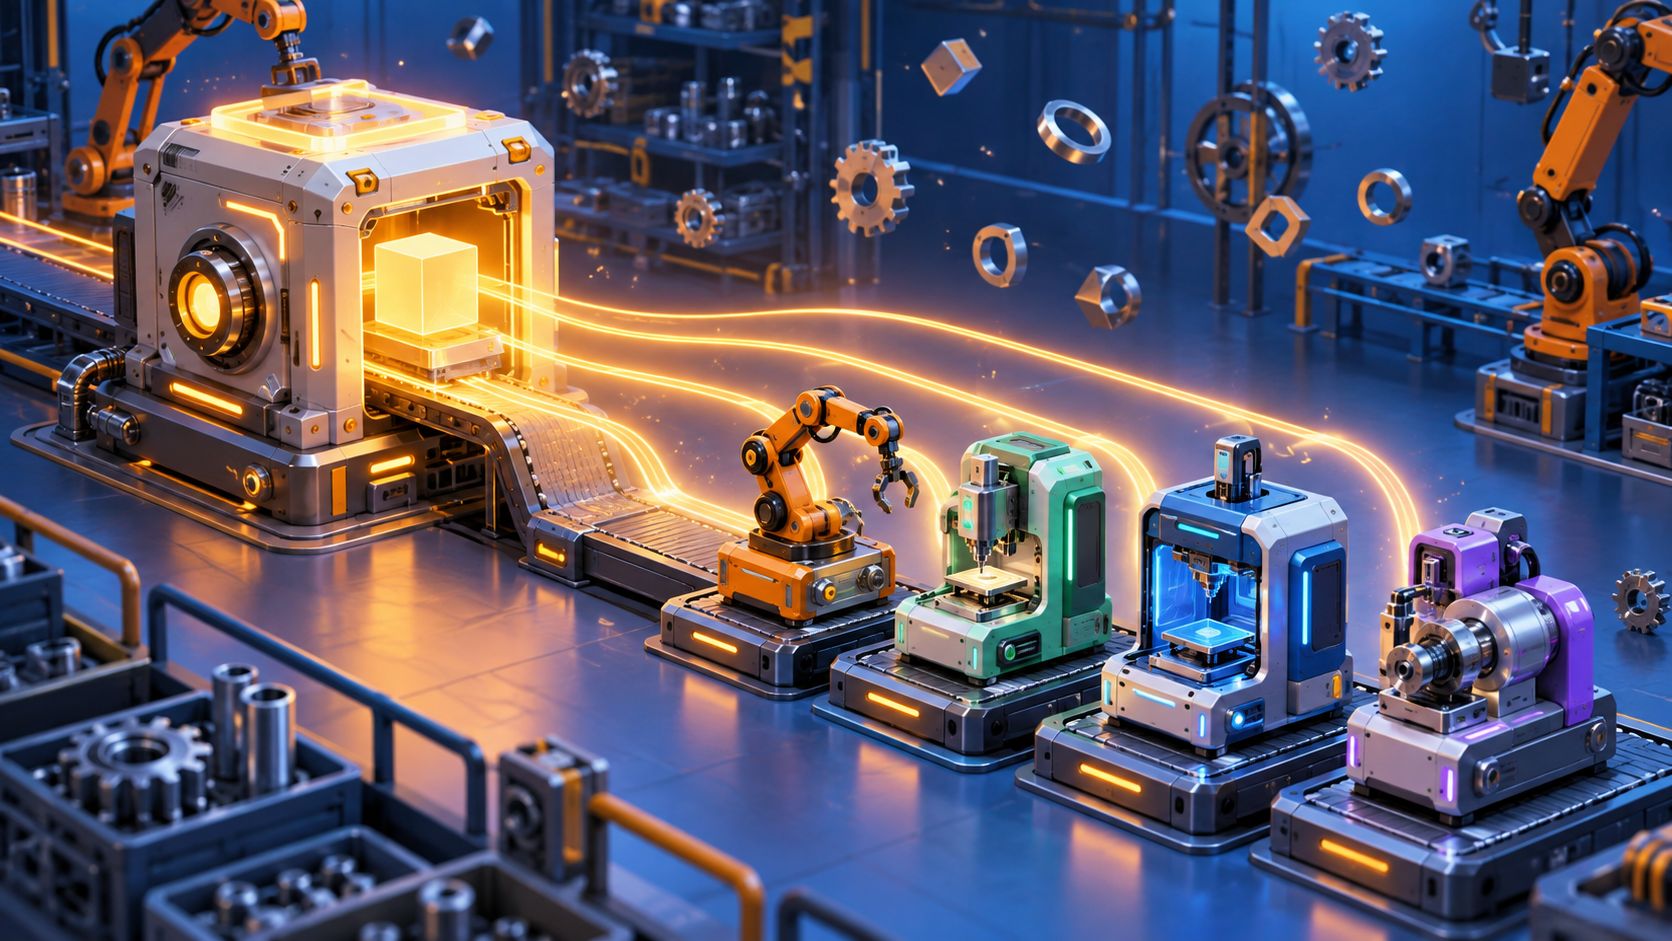
泛型函数像一份可以处理多种材料的模板:同一个排序函数既可以处理整数,也可以处理字符串。但 CPU 执行的不是“泛型”,而是已经确定了数据布局和调用方式的机器代码。Monomorphization,中文常译为“单态化”,就是在编译时为实际使用到的具体类型生成专门版本。
一个泛型函数如何变成多份代码
假设程序使用了 Vec<u64> 和 Vec<String>。编译器会收集这些具体实例,并为相关操作生成针对 u64 与 String 的代码。之后,优化器可以知道元素大小、移动方式和调用目标,省去部分运行时分派。
这也是 Rust 静态分发效率高的原因之一。泛型函数在源代码里只写一份,但生成的中间表示和机器代码可能有多份。编译器开发指南把这一步放在后端代码生成之前,并且会把具体实例收集成待编译项目。
性能收益和成本
单态化让编译器更容易内联函数、消除抽象开销,并利用具体类型做优化。代价是:类型组合越多,生成的实例越多,编译时间和二进制体积也可能增加。大型项目会通过增量编译、代码生成单元、共享泛型实例等方式缓解。
这和 Java 的类型擦除形成鲜明对比。擦除倾向于共享一份运行时代码,单态化倾向于生成更专门的代码。没有“永远更好”的选择,关键在于项目更在意运行时性能、编译速度、包体积还是跨语言兼容。
对 AI 编程的启发
AI 可能为了追求“泛化”而设计很多层泛型,也可能复制出大量近似实现。理解单态化后,开发者会更关注泛型的实际实例数量:哪些类型真的会用到?抽象是否值得它带来的编译成本?是否应改用动态分发或共享实现?
读者应该记住
Monomorphization 是把“一份泛型模板”编译成“多份具体机器代码”的过程。它把抽象成本从运行时挪到编译时,换来更直接的执行路径,同时也需要控制代码膨胀。