Backpressure:生产者太快时,系统怎样不被数据淹没?
TL;DR
Backpressure 让下游处理能力反过来影响上游生产速度,避免异步流水线靠无限缓存硬撑。本文用水管和阀门解释响应式流、需求信号、数据丢弃与容量设计,也说明它和普通限流的区别。
Backpressure 让下游处理能力反过来影响上游生产速度,避免异步流水线靠无限缓存硬撑。本文用水管和阀门解释响应式流、需求信号、数据丢弃与容量设计,也说明它和普通限流的区别。
在数据流系统里,生产者和消费者的速度经常不一样。传感器、网络连接或上游服务可能持续高速产生数据,而下游数据库、浏览器或模型处理得更慢。如果系统只会不断接收,内存最终会被队列填满,延迟和故障会一起上升。Backpressure,中文常译为“背压”或“反压”,就是让下游的处理能力反过来影响上游生产速度。
它像水管里的阀门
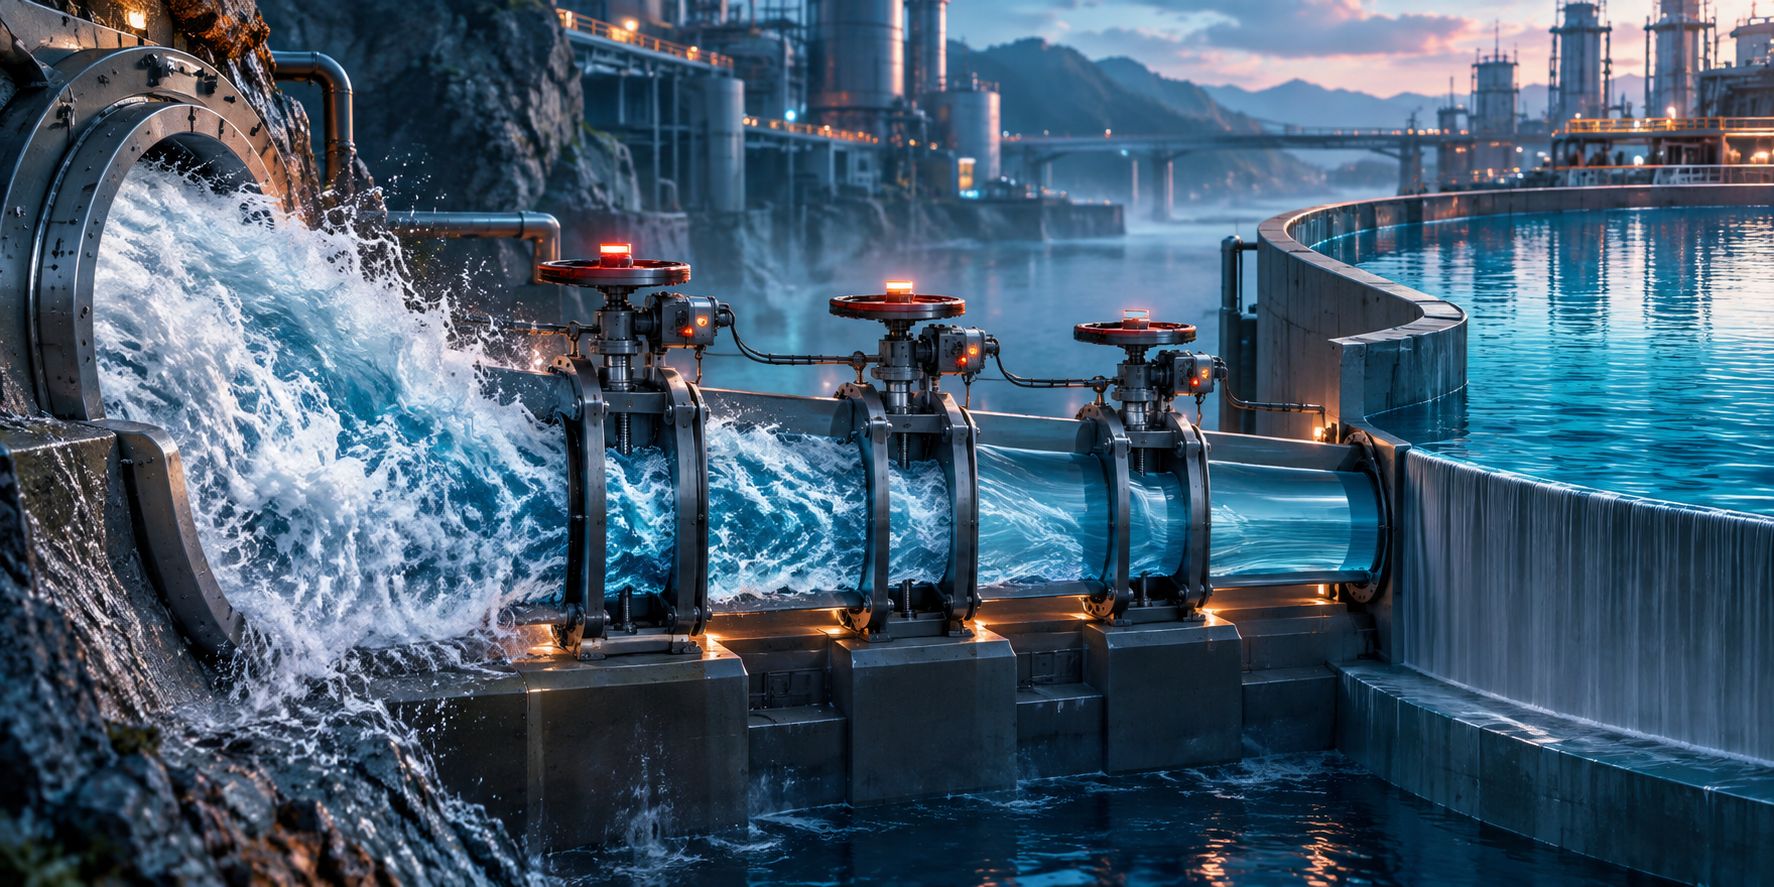
可以把数据流想成水流。生产者是水源,消费者是水池,中间有管道和阀门。消费者处理不过来时,需要通过请求数量、窗口大小、暂停读取或降低采样率告诉上游:“先慢一点”。这比无限堆积更健康,因为系统主动把压力传回源头。
Reactive Streams 规范把非阻塞背压作为异步流处理的核心目标。消费者可以请求自己能处理的数量,生产者再按需求发送。不同框架的 API 不完全一样,但基本思想都是把“需求”纳入数据流协议,而不是靠一个没有上限的缓冲区兜底。
背压和限流不是一回事
限流通常由系统预先设定一个允许速率,背压则更强调根据消费者当前状态动态调整。限流可以保护服务不被突发流量打垮,背压可以让一条流水线内部的每一段协同工作。两者可以同时使用。
背压也有代价。数据可能需要丢弃、降采样、写入持久队列,或者让用户看到“处理中”。如果业务不能丢数据,就要明确队列容量、重试、顺序和恢复策略。把数据简单塞进内存,只是把问题延后。
AI 应用中的背压
流式模型输出、日志管道、检索结果和工具调用都可能出现生产过快。AI 生成的异步代码若没有取消信号、队列上限和消费反馈,短时间演示可能正常,长时间运行就会积压。
读者应该记住
Backpressure 不是让系统“更快”,而是让快的一方知道什么时候必须慢下来。它把系统稳定性从无限缓存,转移到明确的流量协商和容量设计上。