LSM-tree:为什么高写入数据库要先记下来,再慢慢整理?
TL;DR
LSM-tree 先把写入放入内存结构和顺序日志,再通过后台 Compaction 合并成有序文件,以此降低随机写成本。本文解释 memtable、SST、WAL、读放大和写放大,说明 RocksDB 一类存储引擎的设计取舍。
LSM-tree 先把写入放入内存结构和顺序日志,再通过后台 Compaction 合并成有序文件,以此降低随机写成本。本文解释 memtable、SST、WAL、读放大和写放大,说明 RocksDB 一类存储引擎的设计取舍。
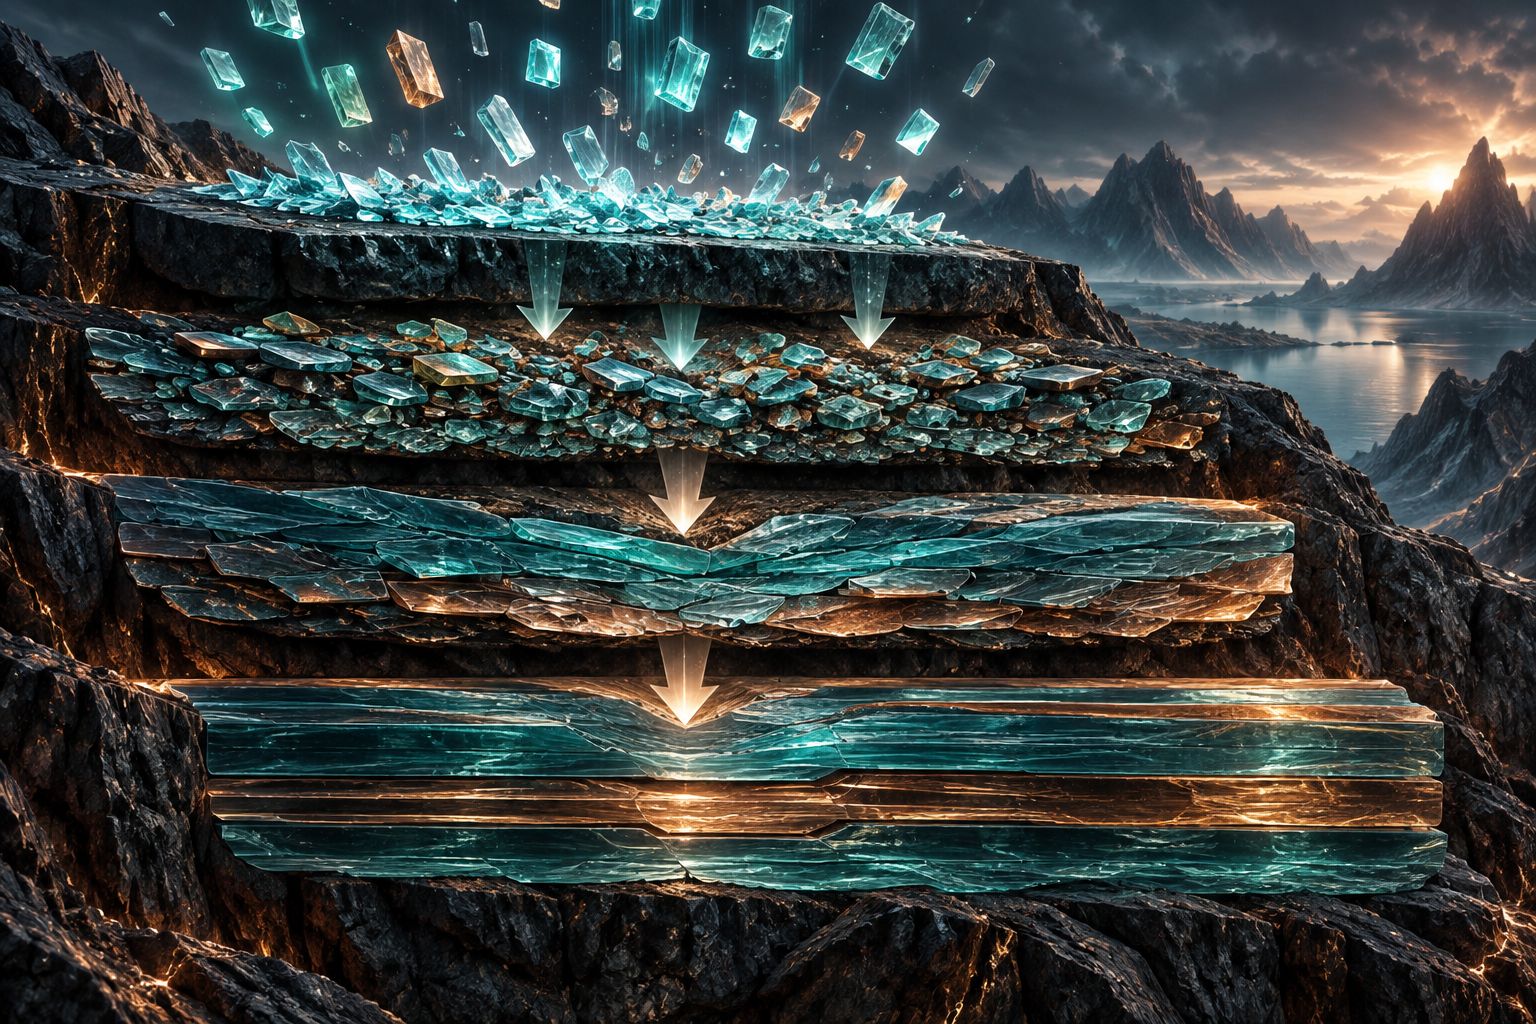
高写入量数据库通常不急着把每一条新数据都插入一个巨大的有序索引。那样会产生大量随机写入。LSM-tree,Log-Structured Merge-tree,日志结构合并树,选择先把新写入放到内存结构和顺序日志里,之后再把数据批量整理成有序文件。
写入路径是怎样的
以 RocksDB 的典型结构为例,新写入先进入 memtable,同时可以写入 WAL。memtable 达到一定大小后,被刷新成排序好的 SST 文件。后台线程再把多层文件合并、压缩和清理旧版本,这个过程通常称为 compaction。
它的优势是把很多小的随机写,转化为更适合存储设备的顺序写和批量合并。对日志、事件、时序数据和键值写入密集型负载,这种设计很有吸引力。
为什么读和后台整理会变复杂
一次读取可能需要查询内存表和多个 SST 文件。系统会用 Bloom Filter、索引块和缓存减少不必要的磁盘访问。后台 compaction 还会占用 I/O 与 CPU,如果整理跟不上写入,文件层数、读放大和写放大都会增加,甚至出现写入停顿。
因此 LSM-tree 不是“写入快就完事”。工程师需要在写放大、读放大、空间放大、压缩策略和延迟稳定性之间做取舍。不同业务的读写比例、键分布和删除模式,都会影响最合适的配置。
它和 WAL 是什么关系
WAL 主要解决崩溃恢复,LSM-tree 主要解决高写入下的数据组织。两者经常一起出现,但不是同一个概念:日志保证“已经接受的变化有迹可循”,LSM 层次负责“如何把变化整理成可查询的持久结构”。
AI 编程的启发
当 AI 建议把所有数据都写进缓存或队列时,LSM-tree 提醒我们必须考虑后续整理成本。快速接收只是第一阶段,后台压缩、恢复、查询和空间回收同样属于系统设计。
读者应该记住
LSM-tree 的核心是“先顺序接收,再批量合并”。它把写入性能换成后台整理和读取复杂度,是许多现代键值存储引擎的底层骨架。