AI 为什么会推荐不存在的 npm 包?
TL;DR
解释 AI 推荐不存在依赖的原因,以及包名验证、维护历史、漏洞扫描和最小权限如何降低软件供应链风险。
AI 可能把不存在或过时的依赖说得很像真的,甚至让开发者把陌生包安装进项目。本文解释依赖幻觉、恶意抢注、版本风险和安装前的供应链检查。
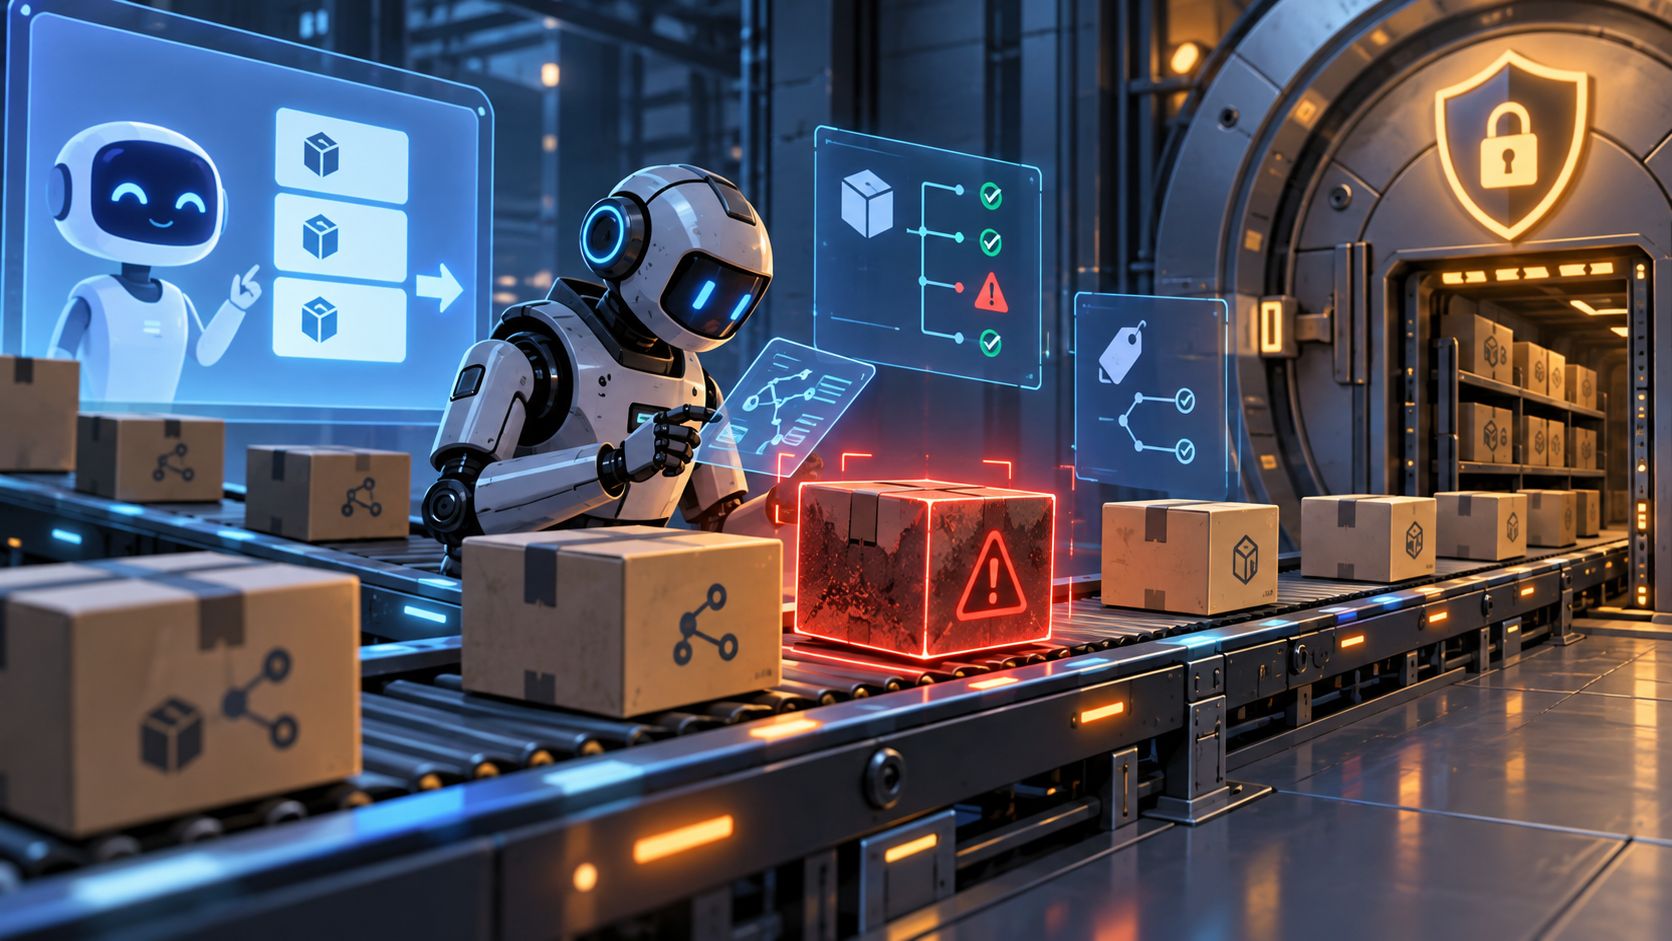
AI 编程最容易让人放松警惕的地方,是它经常把不存在的依赖说得很像真的。模型可能推荐一个听起来合理的包名,给出安装命令和示例代码,开发者复制运行后却把一个陌生依赖引入了项目。如果攻击者提前注册这个名称,所谓的“便捷安装”就可能变成供应链入口。
依赖幻觉是怎么发生的
模型学习过大量代码和文档,但它并不总能实时确认包管理器里是否存在某个包,也不一定知道哪个版本仍然维护。它会把相似的库名、旧版本名称和开发者常见的命名方式拼接起来,生成一条语法看起来完整的建议。
这类错误和普通代码 Bug 不一样。代码写错了,运行时可能马上报错;包名写错了,如果有人恰好注册了同名恶意包,安装过程就可能执行脚本、读取环境变量或修改构建环境。
安装前至少确认五件事
第一,在对应的官方包仓库搜索包名,不要只相信模型提供的链接。第二,确认发布者、维护历史、版本时间和下载情况。第三,阅读安装脚本和依赖树,关注是否有不必要的网络或文件操作。第四,检查许可证和已知漏洞。第五,确认它解决的问题没有现成的官方库或项目内部工具可以承担。
包名真实存在,也不代表当前版本安全。AI 可能推荐一个历史上常见、现在却已经过时的版本。依赖版本应该通过锁文件、更新工具和安全数据库管理,不应每次让模型随意决定。
把依赖检查变成自动门槛
个人项目至少可以在安装前手动检查包名,在提交前运行审计工具,并锁定版本。团队项目则可以维护允许使用的包清单,限制新依赖的最小年龄,要求 Pull Request 说明引入原因,并让 CI 检查已知漏洞和许可证。
给 AI 的任务也应明确:“不要自动安装新依赖;若必须增加,请先列出包的官方地址、维护者、版本、许可证、已知漏洞和替代方案,等待确认后再执行。”这会让模型从“找一个能用的包”转向“提供可审查的选择”。
不要误以为 .gitignore 能保护秘密
很多 AI 工具可以直接读取文件系统,而不是只读取 Git 已跟踪文件。.gitignore 能阻止文件被提交,却不一定阻止工具看到 .env、私钥或本地配置。敏感文件需要通过工具自身的排除规则、沙箱路径和权限控制保护。
同样,依赖风险也不能只靠“模型不会恶意”。模型可能不具备最新安全信息,工具也可能被恶意上下文诱导。把包验证、依赖扫描和网络限制放进工程流程,才不会把安全寄托在一次生成的运气上。
一条容易记住的原则
AI 推荐的包名只能算线索,不能算事实;AI 推荐的版本只能算候选,不能算批准。安装任何新依赖前,先确认它存在、有人维护、来源可信、风险可接受,再让它进入项目。