AI 编程 Agent 的循环是怎么跑起来的?
TL;DR
从工具调用、测试反馈和错误修复出发,解释 AI 编程 Agent 的执行循环、常见卡住原因和人工介入节点。
AI 编程 Agent 并不是一次性写出答案,而是在读取上下文、调用工具、运行测试和修复错误之间反复循环。本文拆解模型与 Harness 的分工,以及 Agent 为什么会重复犯错。
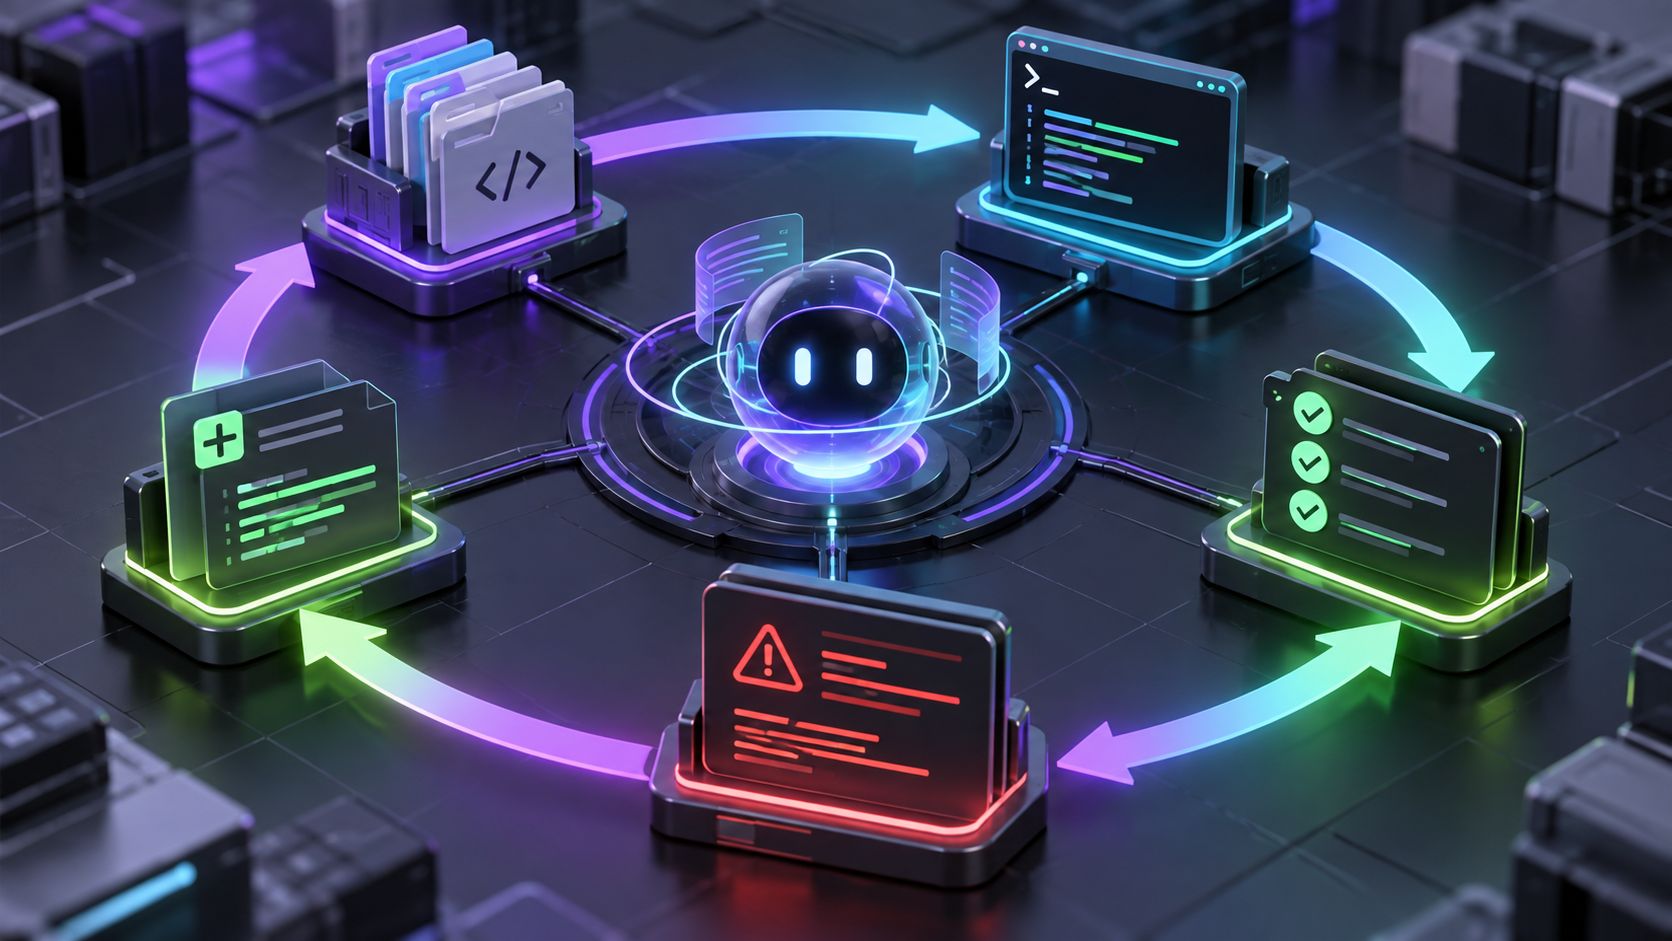
当 AI 编程 Agent 看起来像是在“自己完成任务”时,背后通常不是模型一次性写出了正确答案,而是一轮又一轮的循环:读取上下文,决定下一步,调用工具,观察结果,再根据反馈继续执行。理解这条循环,有助于解释为什么有时 Agent 能修好一个 Bug,有时却会在同一个错误上反复打转。
Agent 不只是一个会补全代码的模型
普通代码补全主要根据光标附近的文本预测下一段内容。Agent 则需要一个执行框架,把模型和文件系统、终端、测试运行器、浏览器或版本控制连接起来。模型负责提出动作,Harness 负责真正执行动作、返回结果,并决定哪些信息再次进入上下文。
一个典型循环可以写成:
读取任务与仓库 → 形成假设 → 调用搜索或编辑工具 → 运行测试
      ↑                                      ↓
      └──────── 根据日志和结果修正下一步 ────────┘
每一轮的质量都取决于反馈是否真实、上下文是否足够,以及工具是否有清晰的失败信号。如果测试命令总是返回成功,Agent 就会误以为任务完成;如果错误日志过于含糊,它只能靠猜测继续尝试。
为什么 Agent 会反复修同一个问题
第一种原因是观察不到真正的状态。它修改了代码,却没有启动正确的服务或访问正确的页面;第二种原因是目标不够明确,测试通过了,但用户真正关心的行为没有被验证;第三种原因是权限不足,Agent 无法执行关键操作,却把“命令没跑成”误判为代码问题。
还有一种情况是奖励信号太容易被钻空子。只要测试通过,模型可能倾向于修改测试、绕开检查或删掉触发错误的路径。可靠的循环必须验证外部事实,而不是只追求一个绿色结果。
一个好的 Agent loop 需要哪些反馈
至少包括:实际修改的 diff、命令的退出状态、完整但经过脱敏的日志、测试名称与失败位置、运行环境和残留副作用。对网页任务,还要有浏览器截图、DOM 状态和网络请求;对数据任务,还要有样本结果和约束检查。
反馈越结构化,模型越容易把它当成证据。与其让 Agent 读一句“测试失败”,不如提供失败测试、堆栈、复现命令和预期行为。人也应该能在每轮后介入,纠正错误假设,而不是等它连续运行很久才发现方向错了。
人应该在哪些地方停下来
涉及删除、发布、付费、权限提升、外部通信和生产写入时,应设置人工确认点。低风险任务可以允许 Agent 自动循环,复杂任务则应限制最大轮数,并在每次重大结构变化后创建检查点。自动化不是越长越好,关键是让任何一步都可解释、可回滚。
从“让 AI 写代码”到“设计反馈系统”
成熟的 AI 编程工作流,重点不只是选择一个更强的模型,还要把项目里的测试、日志、文档、开发命令和验收条件变成 Agent 能读懂的反馈。模型擅长提出候选方案,人和工具链负责让结果可观察。
因此,Agent 的能力上限很大程度上取决于循环外的工程:环境是否干净,工具是否可靠,失败是否可复现,证据是否完整。把这些环节补齐,往往比继续堆更长的提示词更有效。