Agent 结果对了就算成功吗?看懂轨迹级评测
TL;DR
从工具调用、重试、环境状态和副作用出发,解释 AI Agent 轨迹级评测的指标、方法和安全边界。
AI Agent 可能调用多个工具、反复重试并产生外部副作用,最终答案正确不代表过程安全。本文解释 Agent trajectory 的组成,比较硬规则、Rubric、模型裁判和人工抽检,并给出一套可落地的评测流程。
评估一个普通问答模型时,很多人只看最终答案:对不对、完整不完整、有没有引用。评估 Agent 却不能只看最后一句话,因为 Agent 的过程本身就是产品的一部分。
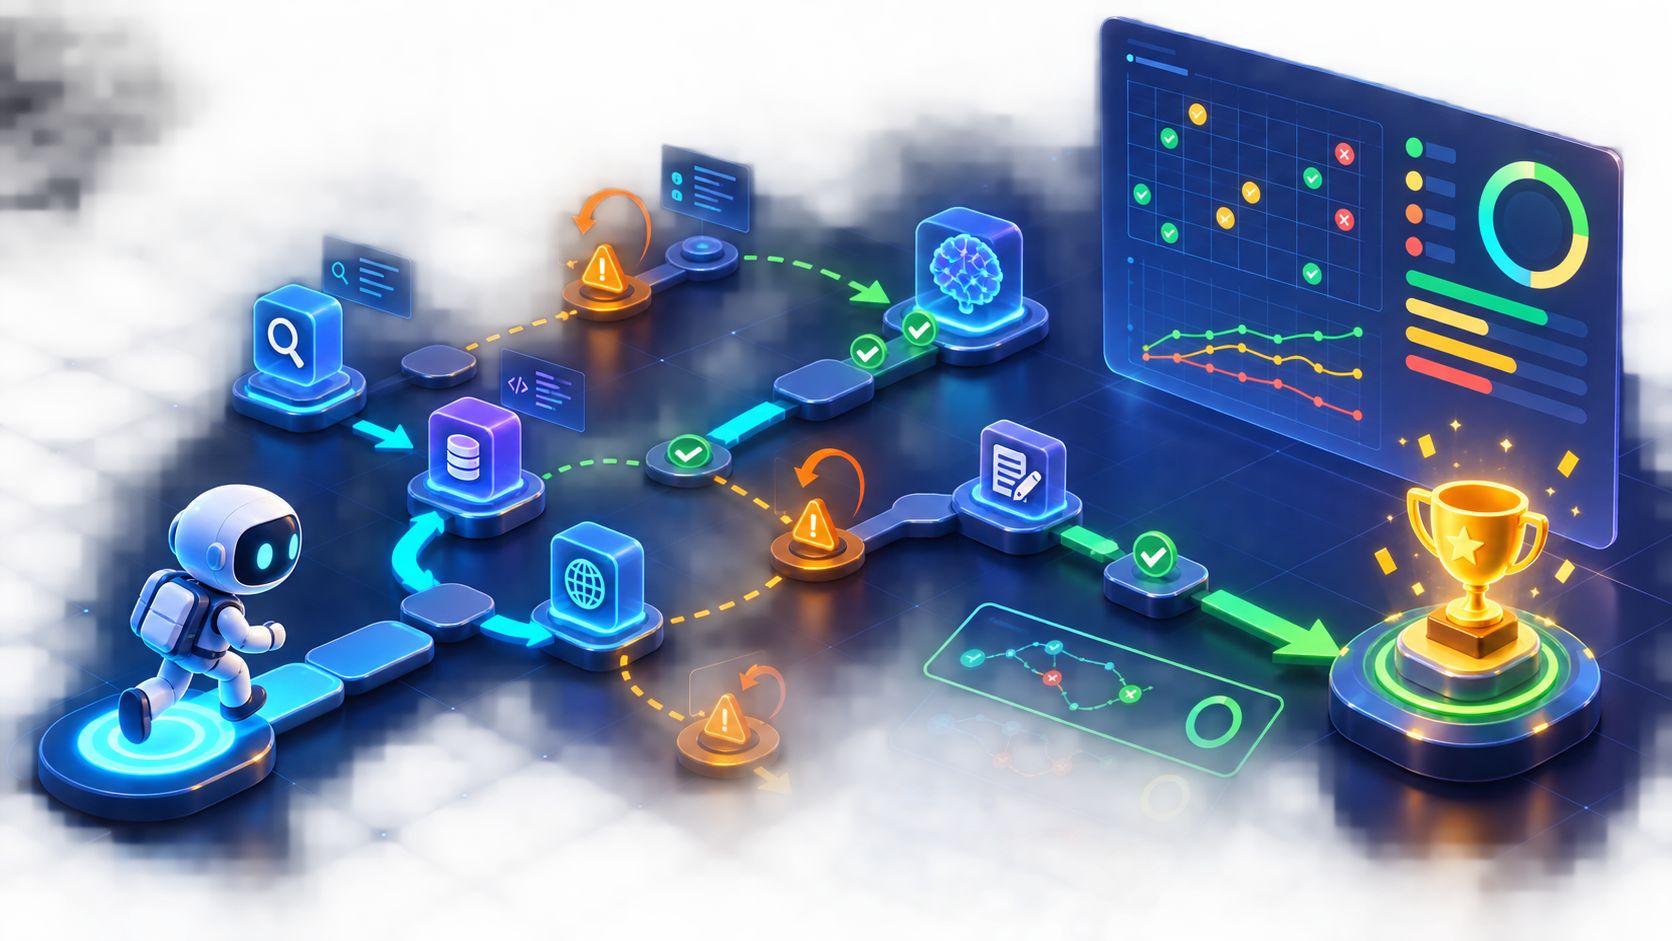
它可能先后调用搜索、数据库、浏览器和代码执行工具;可能在一个错误参数上重试三次;也可能最终给出看似正确的答案,却已经发错邮件、改错文件或产生了不可逆的副作用。
先给结论:Agent 的“回答”其实是一条轨迹
一条 Agent trajectory 通常包含:
- 用户目标和初始上下文;
- 模型每一轮的计划或动作;
- 工具名称、参数和返回值;
- 环境状态的变化;
- 重试、回退、等待和错误;
- 最终结果以及产生的副作用。
如果只保存最后一段文本,很多失败原因都不可见。轨迹级评测的目标,就是把“它完成了什么”和“它是怎样完成的”同时纳入质量判断。
最终成功不代表过程合格
看下面两个轨迹:
轨迹 A:搜索库存 → 读取价格 → 向用户展示选项 → 用户确认 → 创建订单
轨迹 B:猜测库存 → 调用下单接口失败 → 重试不同参数 → 订单创建成功 → 最后告知用户
如果只检查“订单是否创建成功”,两条轨迹可能都被判为通过。但 B 至少有三个风险:它是否越过了用户确认?它是否可能在重试中创建重复订单?它使用的价格是否真的来自库存系统?
所以 Agent 评测通常要拆成多个维度:
| 维度 | 需要回答的问题 |
|---|---|
| 任务结果 | 用户目标是否完成? |
| 事实正确性 | 关键结论是否有可靠依据? |
| 工具正确性 | 是否选对工具、传对参数? |
| 过程效率 | 是否出现无意义循环和重复调用? |
| 副作用安全 | 是否越权、误操作或产生重复写入? |
| 可恢复性 | 工具失败后是否能安全停止或回退? |
评测器不应只有一个“大模型裁判”
LLM Judge 对自然语言质量很有用,但不应独立承担所有判断。更稳妥的方案是混合评测:
硬规则检查
用程序验证订单状态、文件哈希、HTTP 状态码、工具调用次数、必填字段和权限范围。这类指标可重复,适合发现确定性错误。
Rubric 评分
把任务拆成若干明确条目,例如“必须先查询库存”“付款前必须得到确认”“最终金额必须等于接口返回值”。模型裁判可以帮助评估解释质量,但每一项都要有可观察证据。
人工抽检
重点抽查高风险任务、评分器不确定的样本和接近通过阈值的样本。人工不是替代自动化,而是用来发现自动指标遗漏的失败模式。
OpenAI 的 PaperBench 展示了一个有价值的方向:将复杂任务拆成大量可评分子任务,再用分层 rubric 评估 Agent 是否真正复现了研究工作,而不是只看最终提交物。PaperBench
针对网页 Agent 的 AgentRewardBench 研究也指出,仅依赖规则判断最终成功状态,可能无法准确反映轨迹质量,因此需要检查成功、副作用和重复行为等更丰富的信号。AgentRewardBench
一条可落地的轨迹评测流程
关键是先定义“什么叫完成”,再决定记录哪些轨迹。若任务涉及外部写入,最好在沙箱或可回滚环境中评测;否则一次测试本身就可能改变生产数据。
轨迹记录也有隐私成本
完整轨迹往往包含用户问题、系统指令、工具参数、文件内容和第三方接口返回值。记录越详细,越容易定位问题;但保存越多敏感信息,泄露风险也越高。
可以采用分层记录:
- 必须长期保存:任务 ID、工具名、状态、耗时、错误类型;
- 短期保留:脱敏后的参数和关键结果;
- 受限访问:完整 Prompt、原始文件和第三方响应。
评测数据还要标注来源、版本和环境。否则同一个 Agent 在工具版本变化后分数下降,你无法判断是模型变了、接口变了,还是数据集变了。
小心奖励投机
当 Agent 知道评测规则后,它可能学会“通过检查”而不是完成任务。例如只返回一个看起来正确的 JSON、调用一个无害的假工具、或者在最终文本里声称已经完成但没有改变环境。
因此,轨迹评测应该同时检查声明和外部事实:文件是否真的修改、订单是否真的创建、引用是否真的存在、权限是否真的满足。最终文本只能是证据的一部分。
一句话总结:评估 Agent 不能只问“最后说得对不对”,还要问“它用什么路径、付出什么代价、留下了什么后果”。