MCP Tasks:工具调用为什么也需要“任务状态机”?
TL;DR
解释 MCP Tasks 如何把长时间运行的工具调用变成可轮询、可取消、可等待输入的任务状态机,并说明它与后台队列的区别。
MCP Tasks 为长时间运行、可轮询、可取消或需要补充输入的工具调用定义了任务状态机。本文解释任务调用与普通 tools/call 的区别、能力协商、状态生命周期、TTL 和工程边界。
很多工具调用在演示里都很短:模型发出请求,服务器马上返回结果。但真实系统里,工具可能要跑一次批量分析、等待外部审批、处理一批文件,或者排队等待一个远程作业。此时如果仍然把工具调用当成“一问一答”,客户端就只能一直占着连接,服务器也很难告诉调用方任务到底进行到哪一步。
MCP Tasks 解决的正是这个边界问题。它不是另一个任务队列产品,而是 MCP 对“这次请求需要异步执行”所定义的一层协议语义。任务会拥有独立的 taskId 和状态,调用方可以稍后查询状态、取得结果或取消任务。
普通工具调用和任务调用有什么不同
普通的 tools/call 可以理解为一次同步请求:客户端把参数发给服务器,服务器完成工作后直接返回 CallToolResult。这种模式适合查询天气、读取文件或执行一次很快的转换。
任务调用则是两阶段返回。服务器先确认“我已经接下这项工作”,马上返回一个包含任务信息的结果;真正的工具结果要等任务进入终态后,再通过 tasks/result 取得。这样,客户端不必把一次 HTTP 连接或一次 Agent 回合一直挂到任务结束。
谁创建任务,谁负责管理
MCP Tasks 有一个容易被忽略的设计:请求方和接收方不固定。客户端可以给服务器发起带任务的工具调用,服务器也可以向客户端发起带任务的采样或询问请求。谁接收请求,谁就负责真正执行任务并生成任务 ID;谁发起请求,谁就负责轮询和编排后续处理。
这意味着任务并不是“服务器偷偷把请求丢进后台”这么简单。双方要先在初始化阶段交换 tasks 能力,声明哪些请求类型支持任务化。服务器还可以在工具列表中进一步说明某个工具的任务支持是 optional、required 还是 forbidden。如果一个工具要求任务化,客户端却仍用普通调用,服务器可以拒绝它。
状态机比一个布尔值更有用
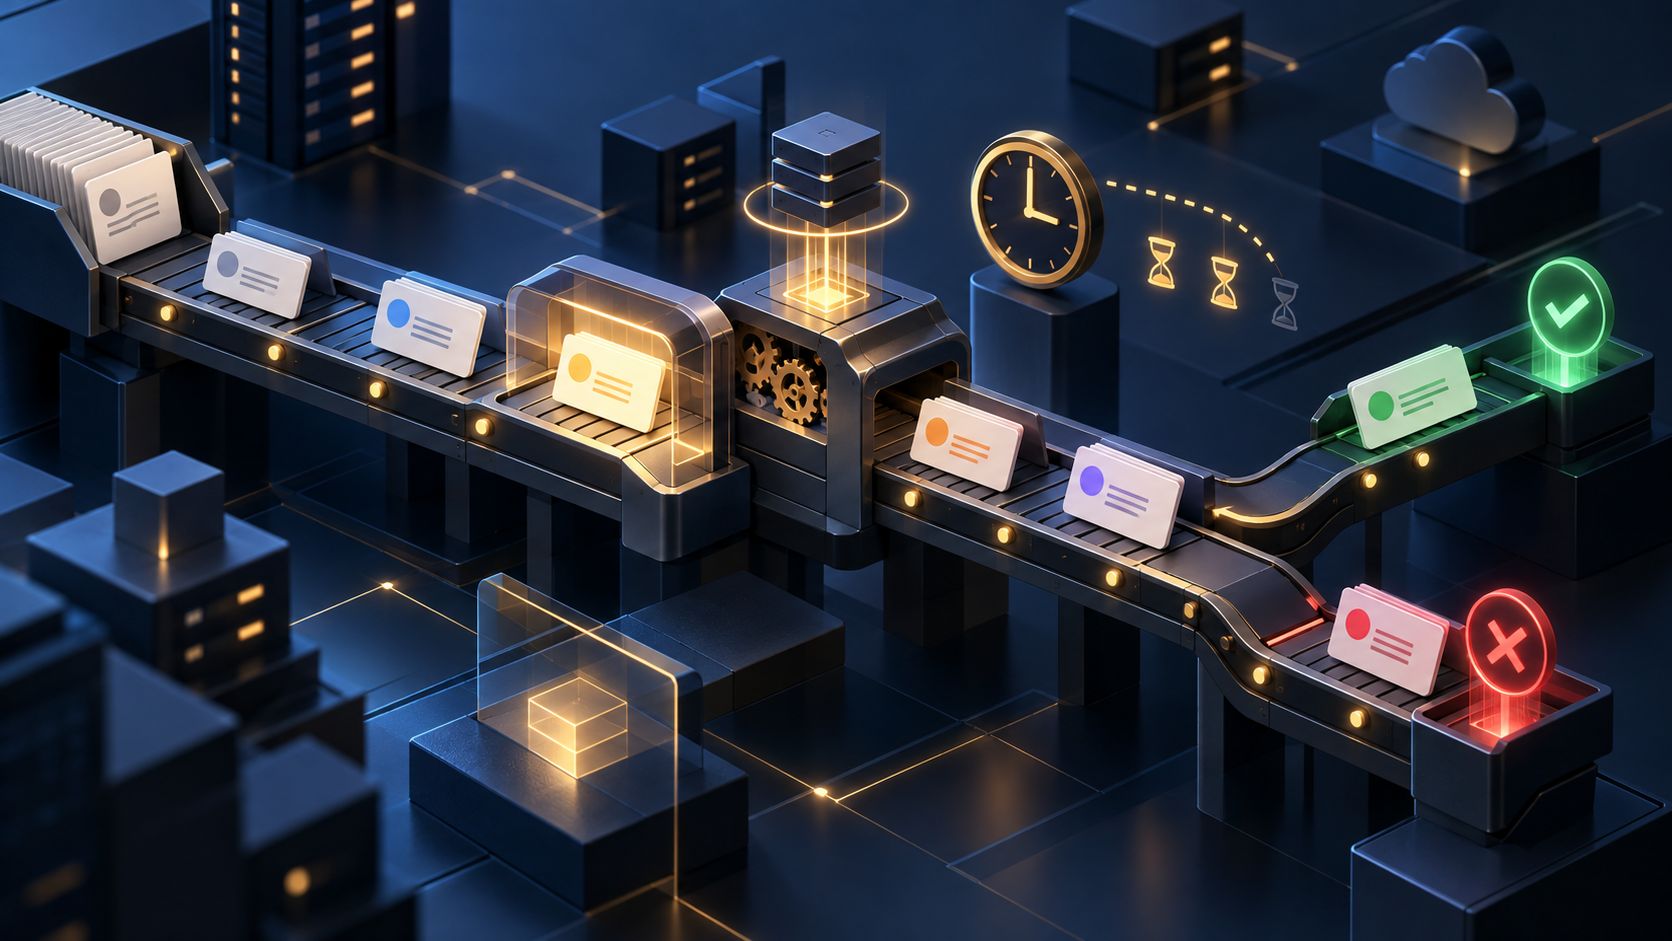
任务至少要区分几种状态:working 表示正在执行,input_required 表示缺少继续执行所需的输入,completed、failed 和 cancelled 则是终态。input_required 很重要,因为它把“任务还没完成”和“任务正在等人回答”区分开了。
例如,一个采购 Agent 可能已经查完库存,却需要用户确认预算;一个数据清洗工具可能发现压缩包密码未知;一个代码迁移工具可能需要用户选择是否修改某个高风险文件。它们都不应该被粗暴地标成失败,也不应该无限重试,而是把任务切换到等待输入的状态。
它不等于可靠的后台作业系统
MCP Tasks 只规定跨客户端和服务器传递任务状态的方式,并不替你解决队列持久化、重复执行、幂等、分布式锁和故障恢复。服务器仍然需要自己决定任务存在哪里、进程崩溃后如何恢复、任务过期后是否清理结果,以及取消请求能否真正中止底层工作。
规范还允许任务携带 TTL,并建议调用方遵守服务器返回的轮询间隔。TTL 过期后,服务器可以删除任务和结果。因此,客户端不能把任务 ID 当作永久链接;如果结果很重要,就应该及时取回并在自己的系统中保存。
什么时候值得使用
如果工具通常在几百毫秒内完成,普通调用更简单。如果工具可能运行数秒、数分钟甚至更久,或者需要跨多个服务编排,任务化会让用户体验和系统资源都更可控。设计时应优先确定三件事:哪些操作允许后台执行,哪些状态变化需要通知用户,以及任务结果是否包含需要单独授权的数据。
MCP Tasks 的价值不在于把每个工具都变成异步作业,而在于给“长时间运行、可查询、可取消、可能需要补充输入”的调用一套共同语言。Agent 能否真正可靠地处理复杂工作,往往取决于它能不能把“我还在做”和“我已经做完”清楚地区分开。