Abstract Interpretation:静态分析为什么不用真正运行程序?
TL;DR
Abstract Interpretation 用可计算的抽象状态近似程序行为,让工具在没有真实输入的情况下发现潜在问题。本文解释抽象、保守估计、循环收敛和误报,帮助读者理解静态分析为什么既强大又不总能给出确定答案。
Abstract Interpretation 用可计算的抽象状态近似程序行为,让工具在没有真实输入的情况下发现潜在问题。本文解释抽象、保守估计、循环收敛和误报,帮助读者理解静态分析为什么既强大又不总能给出确定答案。
静态分析工具经常在程序真正运行之前指出问题:变量可能为空、数组索引可能越界、某个资源可能没有释放。它们通常没有看见一次具体的用户操作,却能对程序行为做出判断。背后的经典思想之一,就是 Abstract Interpretation,中文常译为“抽象解释”。
为什么要“抽象”
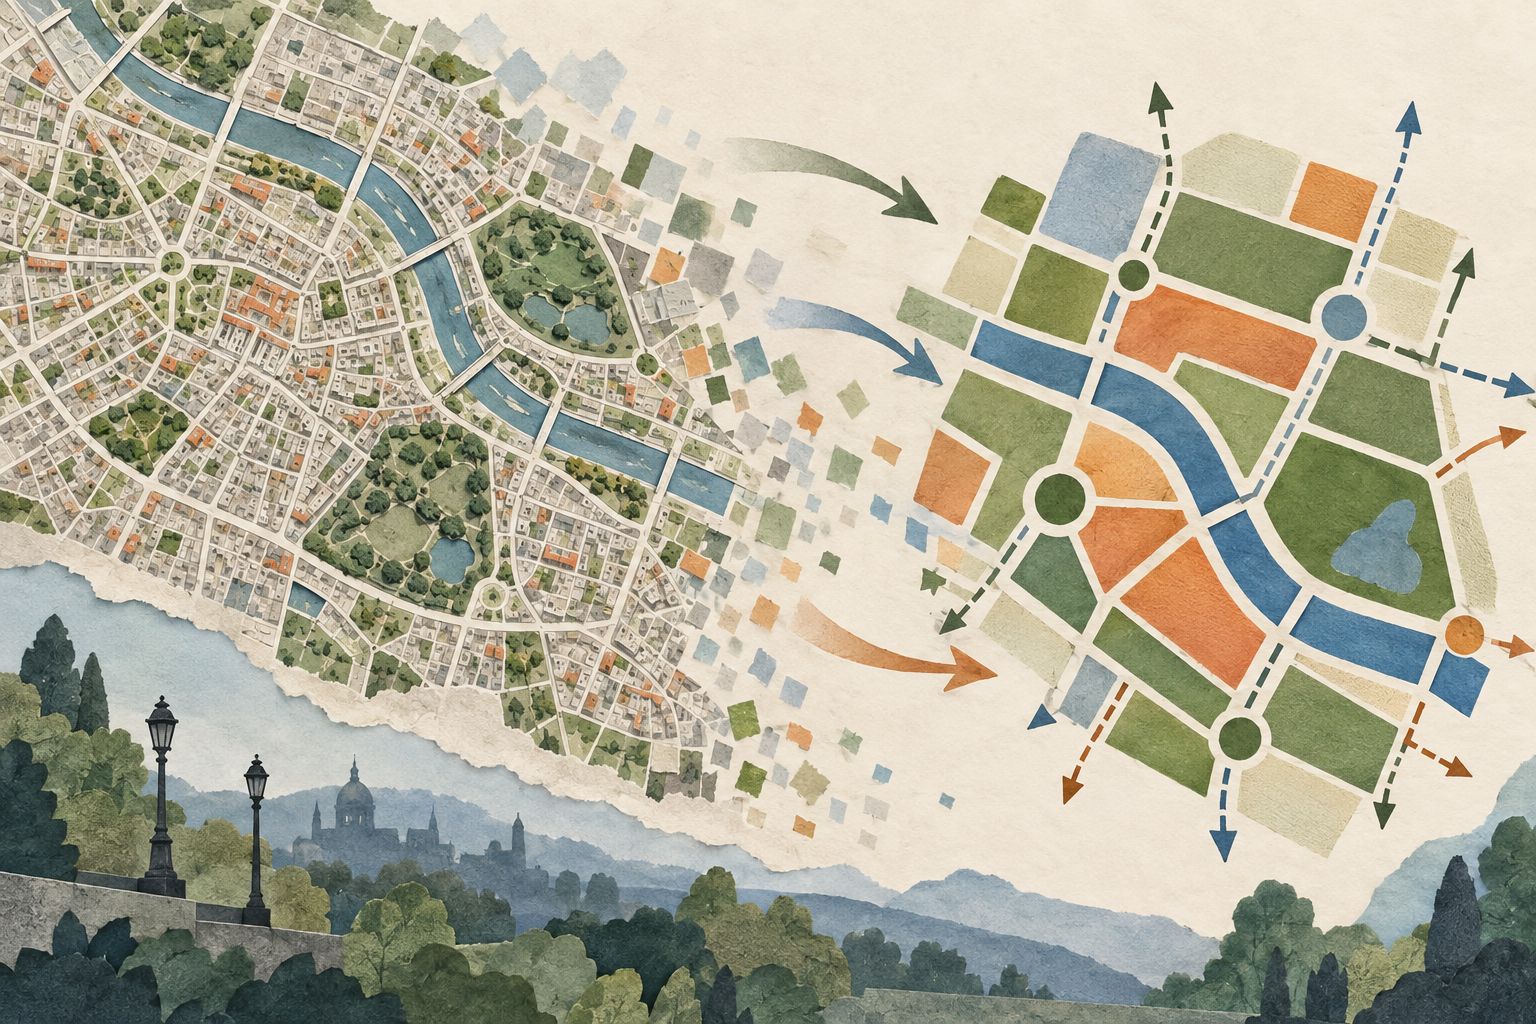
真实程序的状态太大了。一个整数变量可能有无数个值,一个字符串可能有无数种内容,多个变量组合起来更难穷举。抽象解释不保存每个具体状态,而是保存一个更粗但可计算的描述,例如“这个变量可能在 0 到 100 之间”“这个指针可能为空”。
抽象会丢失细节,所以分析结果可能保守。工具也许无法证明某次访问一定安全,只能说“存在潜在风险”。这种保守并不等于错误,而是用可扩展性换取精确度的一种设计选择。
分析是怎样推进的
程序的控制流可以看成一张图。分析从入口开始,把每条语句对抽象状态的影响向后传播。遇到循环时,状态可能不断扩大,于是需要使用 widening 等技术让它在有限时间内收敛;收敛后还可能通过 narrowing 收紧结果,减少过度保守。
举例说,程序先把 x 设为 0,再在循环中不断加 1。抽象解释可能经过几轮传播后发现 x 会增长,但不会试图枚举循环运行的每一步,而是寻找一个稳定的范围描述。
它和普通代码扫描的区别
关键差异不在于界面上显示多少警告,而在于是否建立了程序语义的近似模型。基于规则的扫描可以快速寻找危险字符串;抽象解释则更关注变量、路径、状态和不变量之间的关系。
AI 生成代码时,静态分析可以帮助发现模型忽略的边界。与此同时,分析器也可能因为抽象过粗而产生误报,因此开发者仍然需要理解警告上下文,并在必要时补充更精确的注解。
读者应该记住
Abstract Interpretation 不是“把程序偷偷运行一遍”,而是用更小的抽象世界模拟程序可能的行为。它的强项是覆盖广、无需真实输入;它的代价是可能失去细节,产生误报或无法给出确定结论。