语音搜索一定先变成文字吗?AI 开始绕过转写这一步
TL;DR
传统语音搜索先把声音转成文字,再拿文字查资料,一次听错就可能让搜索方向完全跑偏。Speech-to-Retrieval 尝试直接把语音与相关文档映射到同一个语义空间。本文用蒙克名画的例子讲清新旧架构及其边界。
传统语音搜索先把声音转成文字,再拿文字查资料,一次听错就可能让搜索方向完全跑偏。Speech-to-Retrieval 尝试直接把语音与相关文档映射到同一个语义空间。本文用蒙克名画的例子讲清新旧架构及其边界。
你对手机说“搜索蒙克的《呐喊》”,传统语音搜索通常先把声音转成文字,再用文字检索。假如语音识别把英文里的 Scream 听成 screen,搜索系统便可能认真返回一堆屏幕绘画结果。第二步做得再好,也救不回第一步改变的意思。
这是一种典型的流水线错误:声音先经过语音识别,文字再进入搜索,一个环节的小偏差会传给后面所有环节。新的 Speech-to-Retrieval(语音到检索,简称 S2R)尝试绕过完整转写,直接从声音抵达检索意图。
旧流程在寻找“你说了哪些字”
自动语音识别擅长把声波变成文字。对于写字幕、会议记录和语音输入法,这个中间文本本身就是产品需要的结果。但搜索真正想知道的不是每个字如何拼写,而是用户要找什么信息。
人名、地名、外语词和口音最容易暴露矛盾。一段声音可能存在多个相近转写,只有结合网页内容才能知道哪一个更合理。流水线却往往先确定文字,后面的搜索只能接受这个决定。
Google Research 在 2025 年介绍的 S2R 系统改变了目标:不要求先得到完美文字,而是学习语音与相关文档之间的对应关系。
把声音和文档放到同一张地图
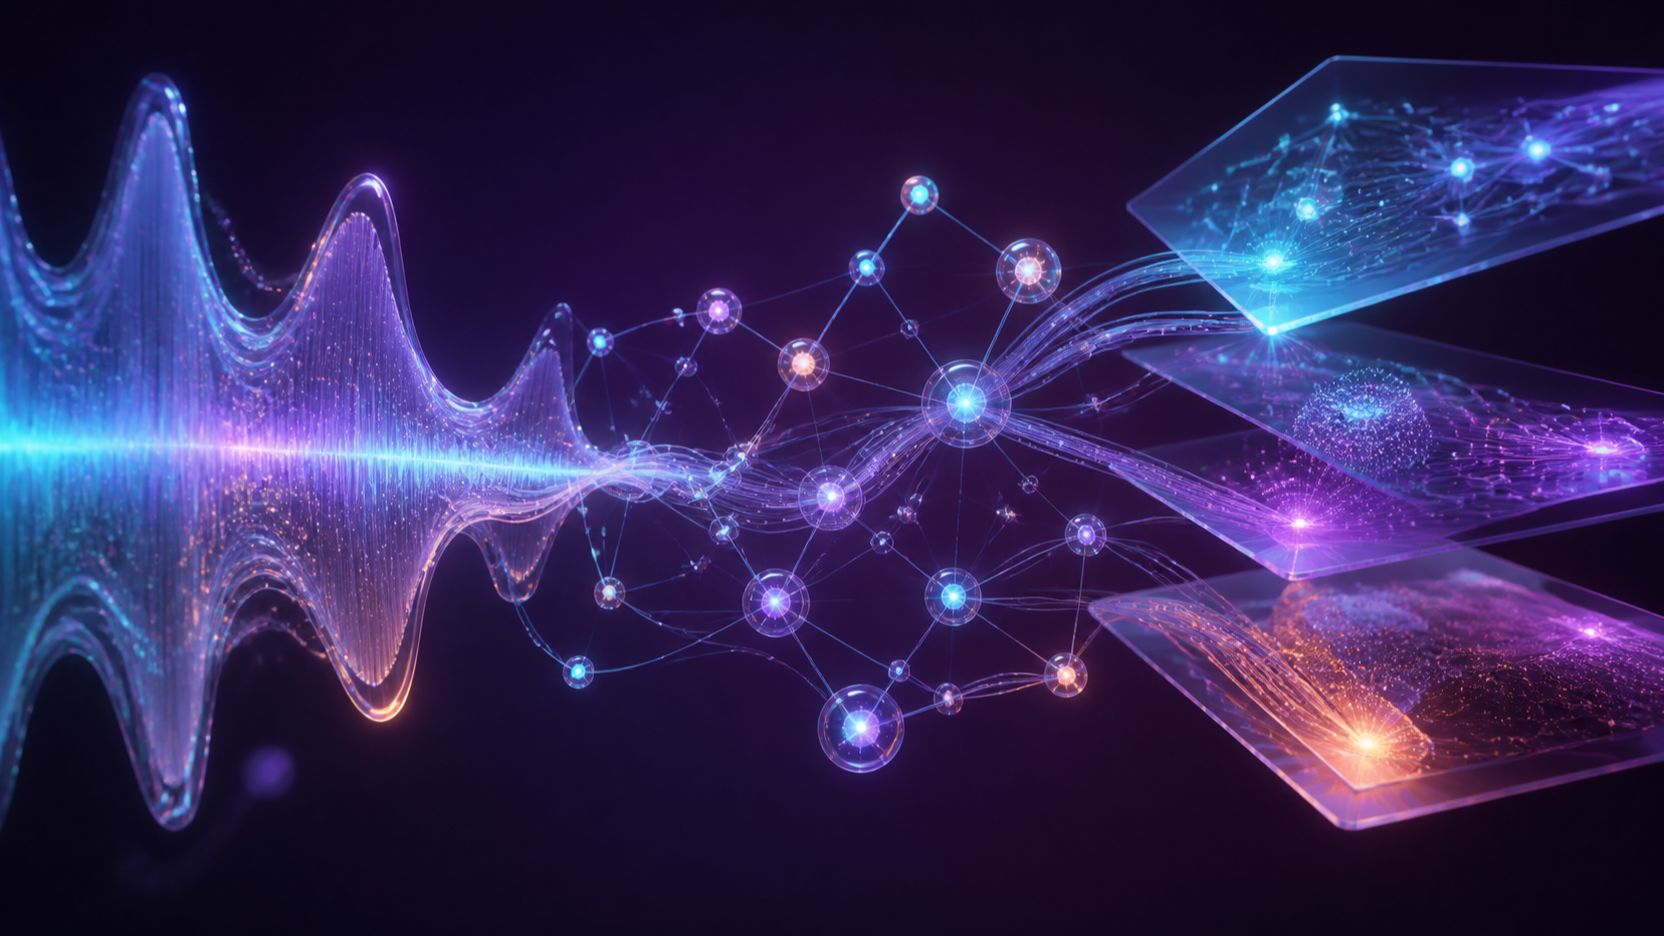
S2R 使用两个编码器。音频编码器把语音转换成一串代表含义的数字,文档编码器也把网页转换成同类表示。训练时,系统拿到语音查询与相关文档的配对,让相关内容在这张数学地图上靠近,不相关内容远离。
当用户发起查询,音频编码器生成查询向量,检索系统先找附近的文档候选,再结合更多质量与相关性信号排序。声音不必先变成一条可展示的完整文字,便能参与搜索。
这不表示系统完全抛弃语言。训练资料、文档内容和最终结果仍与语言密切相关,只是在线检索时不再把“完美转写”设为必经关卡。
它能保留声音中的一切吗
直接语音检索有机会利用文字转写容易丢失的信息,例如发音差异、停顿或上下文线索。但模型是否真正使用这些信号,取决于训练目标和数据。情绪、身份和背景噪声也可能成为不应使用的敏感特征,因此隐私与公平评测同样重要。
Google 公布的系统在多语言语音问题数据集上优于级联语音识别基线,并接近使用正确转写的上限,但研究方也明确承认仍有差距。长问题、环境嘈杂、全新专有名词和资料库没有覆盖的查询,依旧可能失败。
绕过转写不等于转写没有价值
如果用户需要看到并编辑查询文字,或者系统必须留下可审计记录,转写仍然重要。实际产品也可以采用混合方案:直接语音表示提供检索信号,文字转写帮助展示、纠错和过滤。
S2R 带来的变化更像重新定义问题。过去系统先问:“你究竟说了哪些字?”现在它可以同时追问:“你究竟想找什么?”当中间文本容易成为瓶颈时,直接学习输入与目标之间的关系,可能比把每个环节都做成独立完美的模块更有效。