只看无声视频,AI 能自己学会重力和物体运动吗?
TL;DR
世界模型不只识别画面里有什么,还试图预测接下来会发生什么,以及采取动作会带来什么结果。本文以 V-JEPA 2 为例,解释 AI 如何从大量无标注视频中学习可预测的变化,并厘清这种能力与真正理解物理世界之间的距离。
世界模型不只识别画面里有什么,还试图预测接下来会发生什么,以及采取动作会带来什么结果。本文以 V-JEPA 2 为例,解释 AI 如何从大量无标注视频中学习可预测的变化,并厘清这种能力与真正理解物理世界之间的距离。
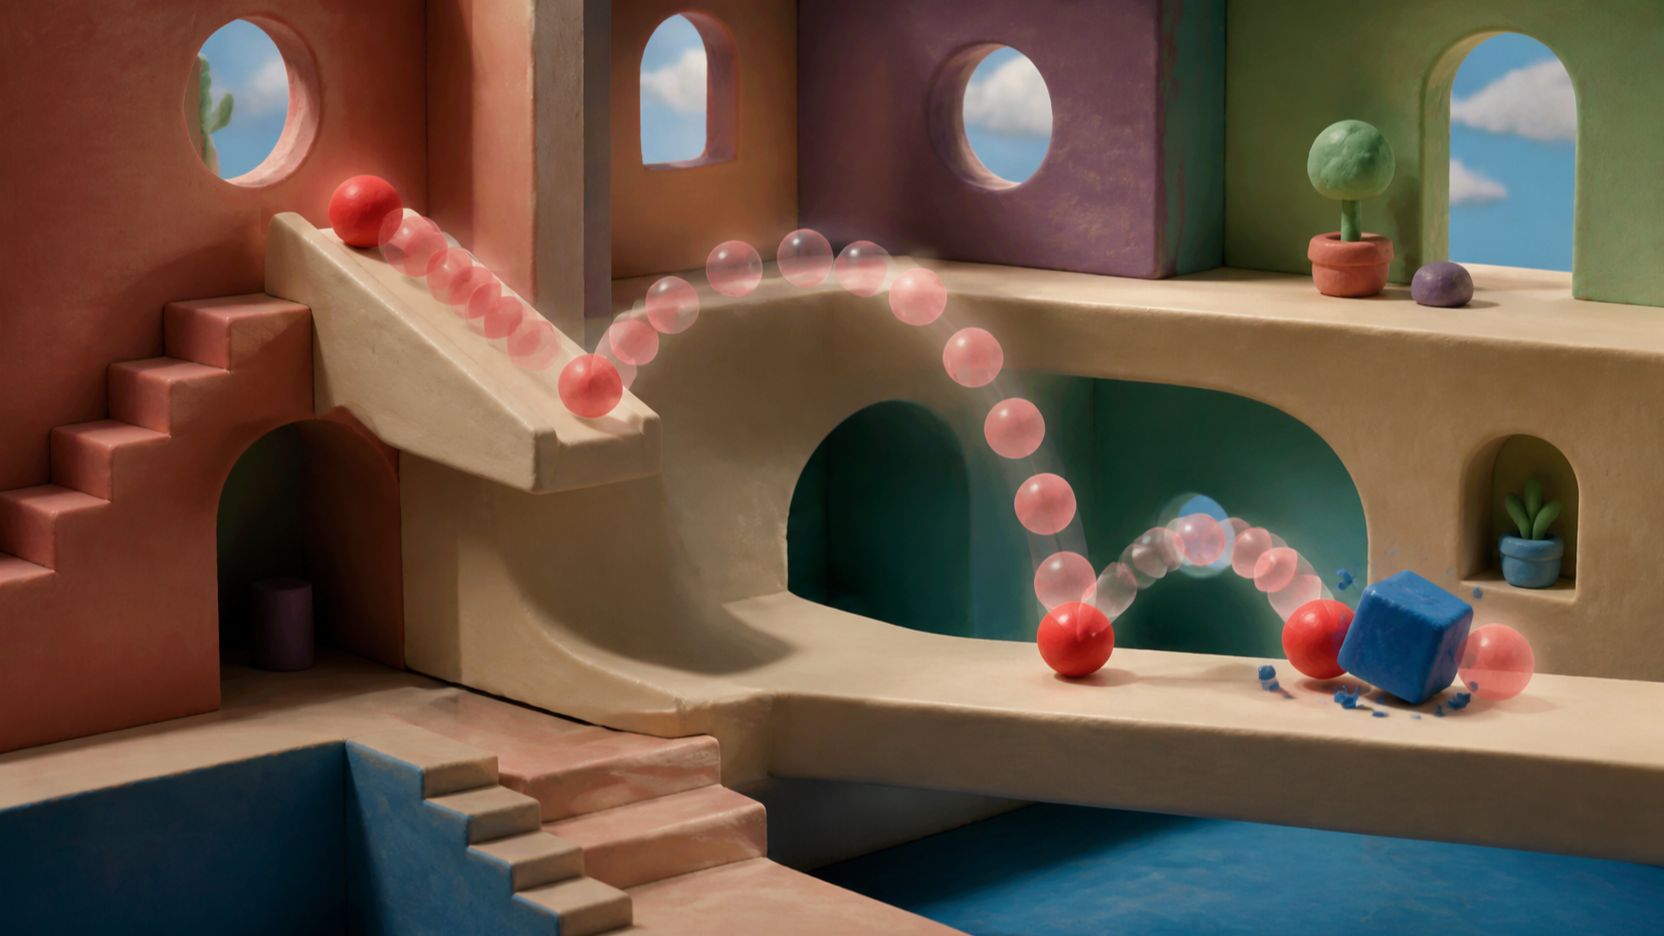
婴儿看球从桌边滚落,不需要有人逐帧标注“球在移动”“接下来会掉下去”,也能慢慢形成对物体运动的直觉。研究者希望 AI 获得类似能力:不只认出画面里的杯子和手,还能预测下一刻会发生什么,以及伸手推动杯子会带来什么结果。
这类内部预测系统常被称为世界模型。它不是完整复制宇宙,而是学习与行动有关的规律,帮助机器理解、预测和规划。
从“这是什么”走向“接下来怎样”
普通图像分类任务关注静态标签:画面里是猫、汽车还是椅子。世界模型还要处理时间和因果线索:球沿哪个方向滚,手拿起杯子后桌面会怎样,如果机器人向左移动会不会撞到障碍。
训练时可以遮住视频的一段,让模型根据前后画面预测缺失部分。直接预测每个像素非常昂贵,而且模型会把精力浪费在难以预测的细节上,例如树叶的轻微抖动。另一条路线是在压缩后的表示空间中预测,只保留对物体、动作和变化有用的信息。
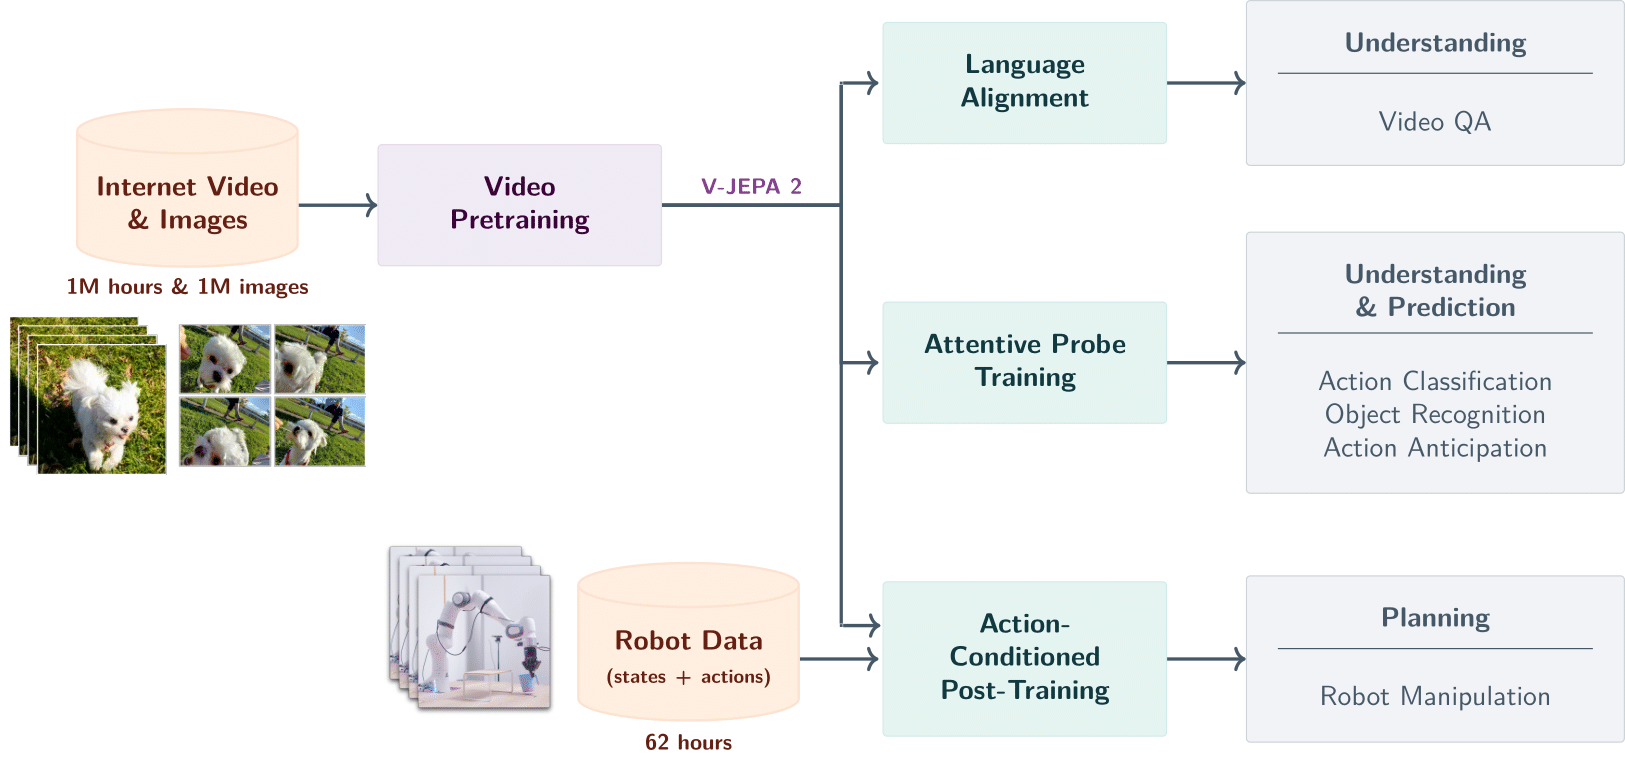
Meta 在 2025 年公布的V-JEPA 2采用联合嵌入预测架构。编码器把视频转换成语义表示,预测器则推测目标片段的表示。模型先从超过一百万小时视频和大量图片中进行无动作标注的预训练,再加入带动作条件的数据,使预测能够回答“采取这个动作之后会怎样”。
为什么无声视频也能成为教材
现实视频天然包含连续反馈。杯子被推后移动,抽屉被拉后打开,人绕过障碍继续前进。即使没有文字说明,相邻画面之间的关系也提供了监督信号。模型可以不断猜下一段表示,再根据实际视频修正自己。
这种自监督学习省去了为每一帧手工贴标签的工作,也可能覆盖远比实验室数据丰富的场景。不过,视频里经常同时发生许多事情。模型看到灯亮与人走进房间总是一起出现,不代表它已经理解开关导致灯亮;统计共现仍可能冒充因果。
会预测视频不等于懂物理定律
世界模型可能学会常见运动模式,却在罕见材质、隐藏结构或全新尺度上失败。它也未必知道质量、摩擦力等概念,只是形成了足够有用的内部规律。一个系统能预测球会落下,并不表示它能写出重力方程。
评测因此不能只问“视频分类准确率多高”,还要检查三层能力:能否理解当前状态,能否预测状态变化,能否用预测规划动作。V-JEPA 2 的研究展示了零样本机器人规划等结果,但这仍不意味着机器人已具备人类式常识,更不代表它能在任意家庭环境中安全工作。
世界模型真正可能改变什么
机器人可以先在内部尝试多条动作路线,再执行风险较低的一条;自动驾驶系统可以预测其他车辆的可能运动;游戏 Agent 能判断动作对虚拟世界的影响。与只会把“看到什么”翻译成文字的系统相比,这更接近行动前的想象。
但内部模拟必须接受现实反馈校正。模型预测与传感器观测不一致时,系统要能够停止、重新规划或请求人工帮助。越是涉及真实机械动作,错误的“想象”越可能造成真实损失。
无声视频确实能教给 AI 大量关于世界的规律,但它教的是从观察中压缩出的可预测模式。世界模型的价值,不在于宣布机器已经理解宇宙,而在于让它行动之前,终于有机会先问一句:“如果我这样做,接下来可能发生什么?”