Vibe Coding 是什么?从一句话到可运行应用
TL;DR
解释 Vibe Coding 的工作方式、适用场景和风险边界,帮助普通读者用清晰需求、分步验证和版本记录做出可靠原型。
Vibe Coding 让人用自然语言描述意图,再和 AI 一起把想法变成可运行的软件。本文从一次完整协作流程出发,解释它改变了什么、没有改变什么,以及普通人如何用清晰约束和持续验证做出可靠原型。
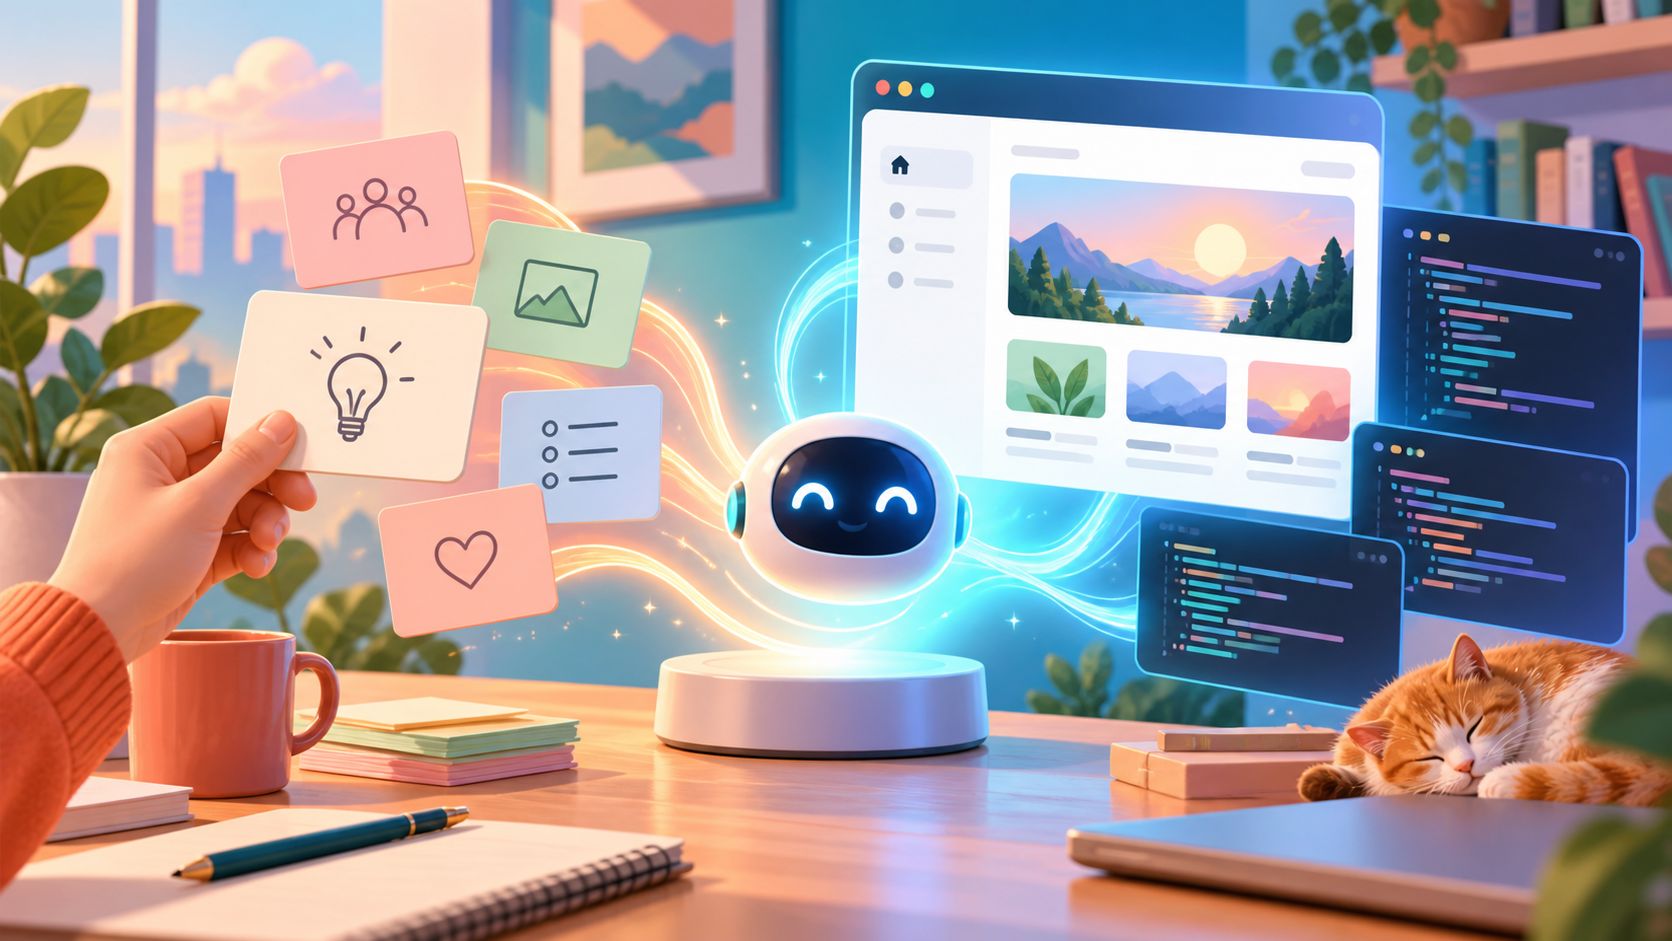
“我想做一个能记录读书笔记的小网页,卡片按标签筛选,手机上也能用。”把这句话交给 AI,它可能在几分钟内生成页面、样式和一套可以运行的代码。这个过程常被称为 Vibe Coding,中文可以理解为“用自然语言描述意图,再和 AI 一起把软件做出来”。
它改变的是输入方式,不是软件规律
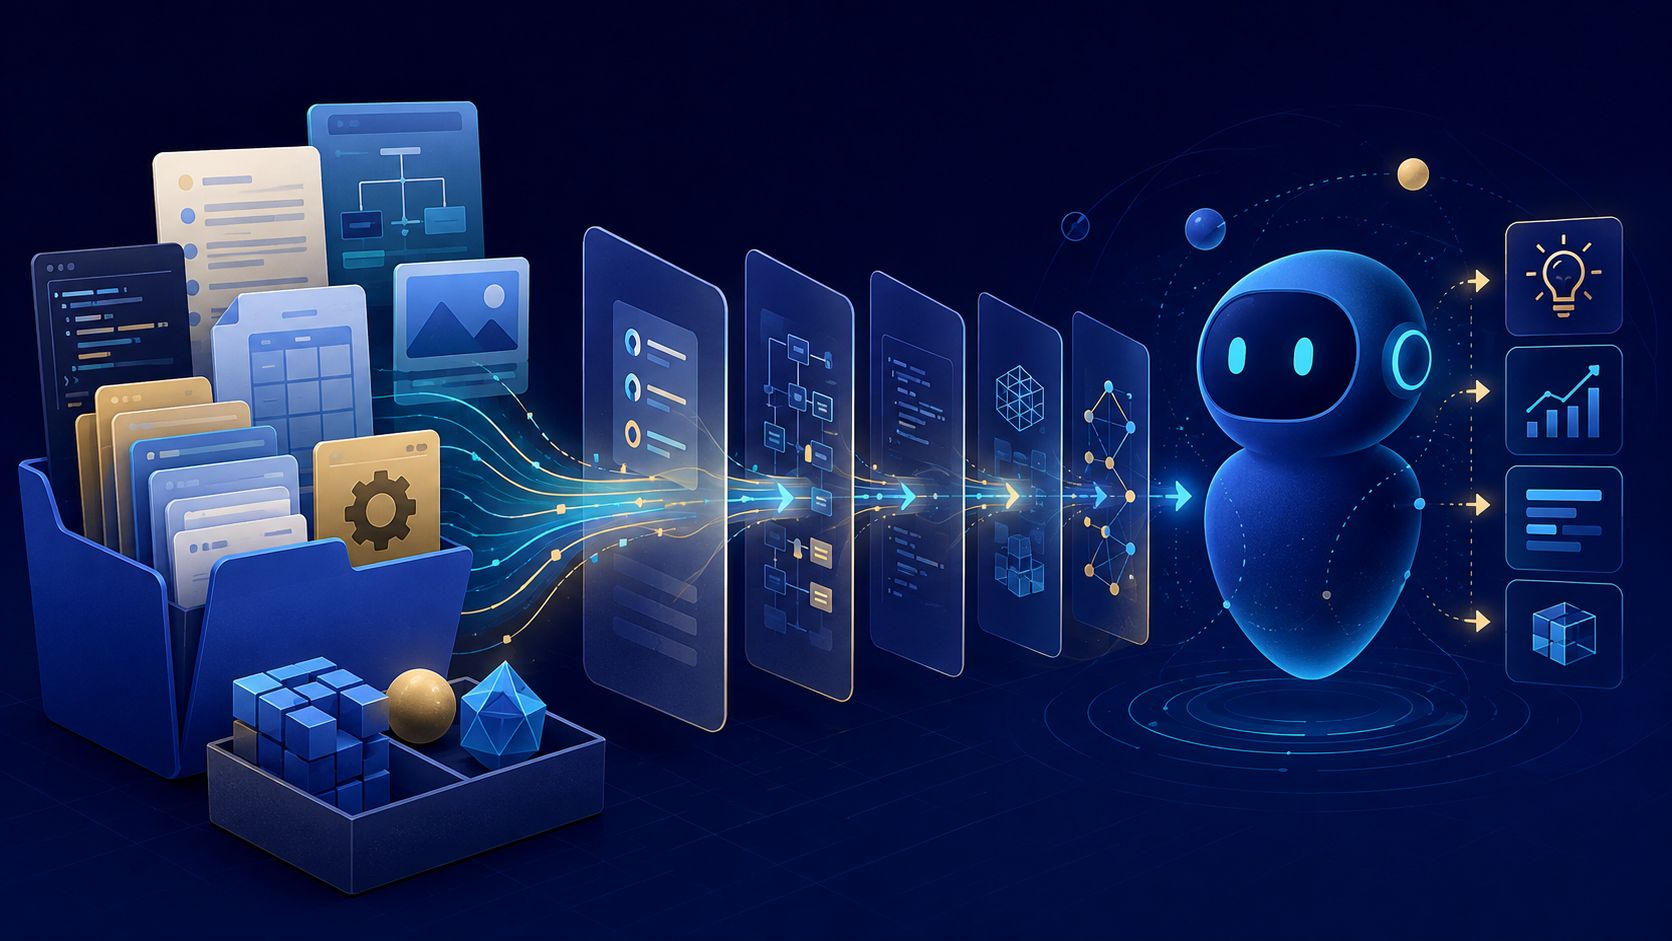
传统编程要求人先把需求翻译成变量、函数、组件、数据库表和接口;Vibe Coding 把这一步部分交给了模型。人负责说明目标、约束和取舍,AI 负责把描述翻译成代码,再根据错误信息继续修改。
但“会说话”不等于“没有工程”。浏览器仍然需要有效的 HTML、CSS 和 JavaScript,服务器仍然要处理权限、并发和异常,数据库仍然需要一致性。AI 只是降低了写出第一版的门槛,并没有取消这些规律。
一次完整的 Vibe Coding 对话是什么样的
一个相对稳妥的过程通常分成五步:
- 先说清楚用户、场景和成功标准,而不是直接说“帮我做一个很酷的 App”。
- 让 AI 先复述理解、列出实现计划和可能的风险。
- 只实现一个可验证的小切片,例如先完成“新增笔记”和“按标签筛选”。
- 在本地运行、点击、测试,再把具体错误和预期行为反馈给 AI。
- 每次改动都保留版本记录,确认没有破坏已有功能后再进入下一步。
这和找一位速度很快的结对程序员相似:你不必亲手敲下每个字符,但必须能判断结果是否符合要求。
为什么“描述得具体”比“提示词很长”重要
好的任务描述不需要堆很多魔法句式,关键是提供可检查的边界。例如:
请在现有页面中增加标签筛选。保留现有路由和数据结构;空状态要显示提示;筛选结果要在刷新后仍可恢复;先说明要修改哪些文件,完成后列出验证步骤。
这里包含了范围、限制、状态和验收方式。AI 得到的自由度越适合任务,返工就越少。反过来,“把界面做得高级一点”缺乏可观察标准,往往会换一套颜色,却没有解决真正的问题。
最容易被忽略的三类工作
第一是边界条件:空列表、重复提交、网络失败、权限不足和手机窄屏。演示路径常常只有“填入正常数据并点击成功”,真实用户不会只走这一条路。
第二是项目上下文:目录约定、构建命令、现有组件和数据模型。如果 AI 不知道这些信息,它可能创建重复工具、绕过已有接口,或者把代码放在错误目录。
第三是责任边界:涉及支付、个人信息、删除数据或生产部署的操作,不应因为模型看起来很自信就直接放行。高风险动作需要人工确认和可回滚机制。
适合怎样开始
第一次尝试可以选一个低风险、可独立验收的小工具,例如个人清单、文本格式转换器或静态作品集。先让 AI 生成一个最小版本,再逐项增加功能。每次只改变一个变量,你才知道出现问题时是需求、代码还是环境导致的。
一句话总结:Vibe Coding 让“想法到原型”的距离变短了,但真正可靠的结果仍来自清晰的约束、持续的验证和愿意承担责任的人。