机器人怎么把“把杯子放到桌上”变成连续动作
TL;DR
Vision-Language-Action 模型把视觉、语言和机器人动作接成闭环。本文从杯子抓取场景讲清感知、规划、动作片段、仿真到现实、安全急停与失败恢复。
Vision-Language-Action 模型把视觉、语言和机器人动作接成闭环。本文从杯子抓取场景讲清感知、规划、动作片段、仿真到现实、安全急停与失败恢复。
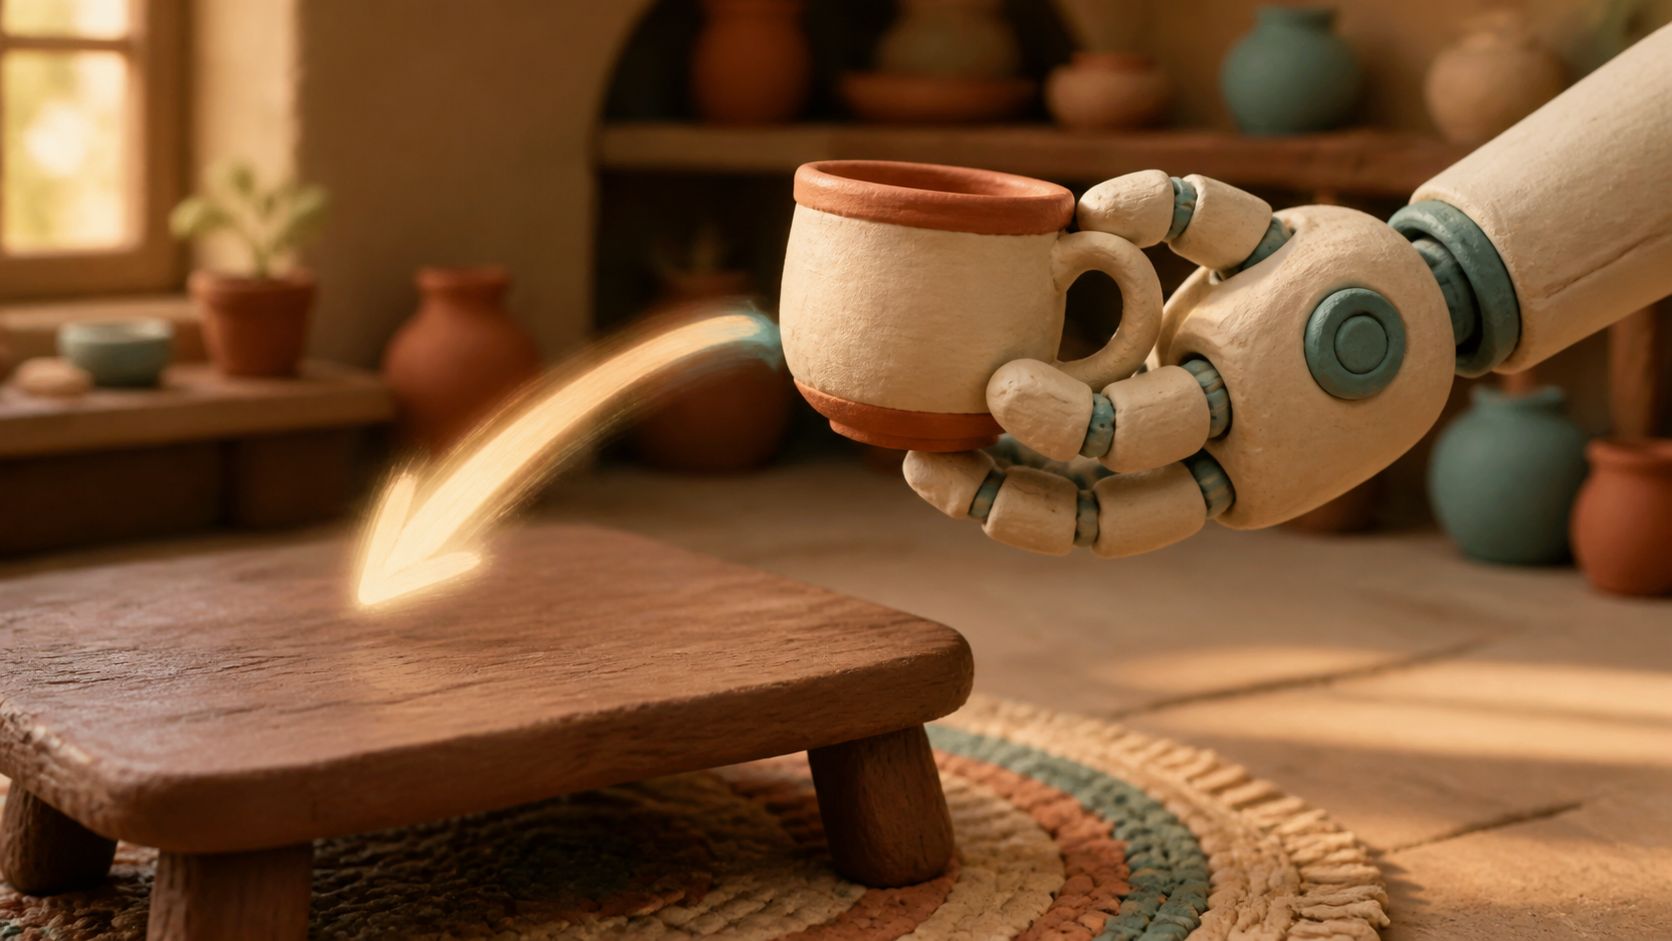
让机器人听懂“把杯子放到桌上”,并不等于给语言模型接一个机械臂 API。机器人必须从摄像头中找到杯子和桌子,判断它们的三维位置,规划一条不会撞到障碍物的轨迹,再把连续动作发送给关节控制器;动作执行后,还要重新观察世界有没有变化。
VLA 模型把三种信息接在了一起
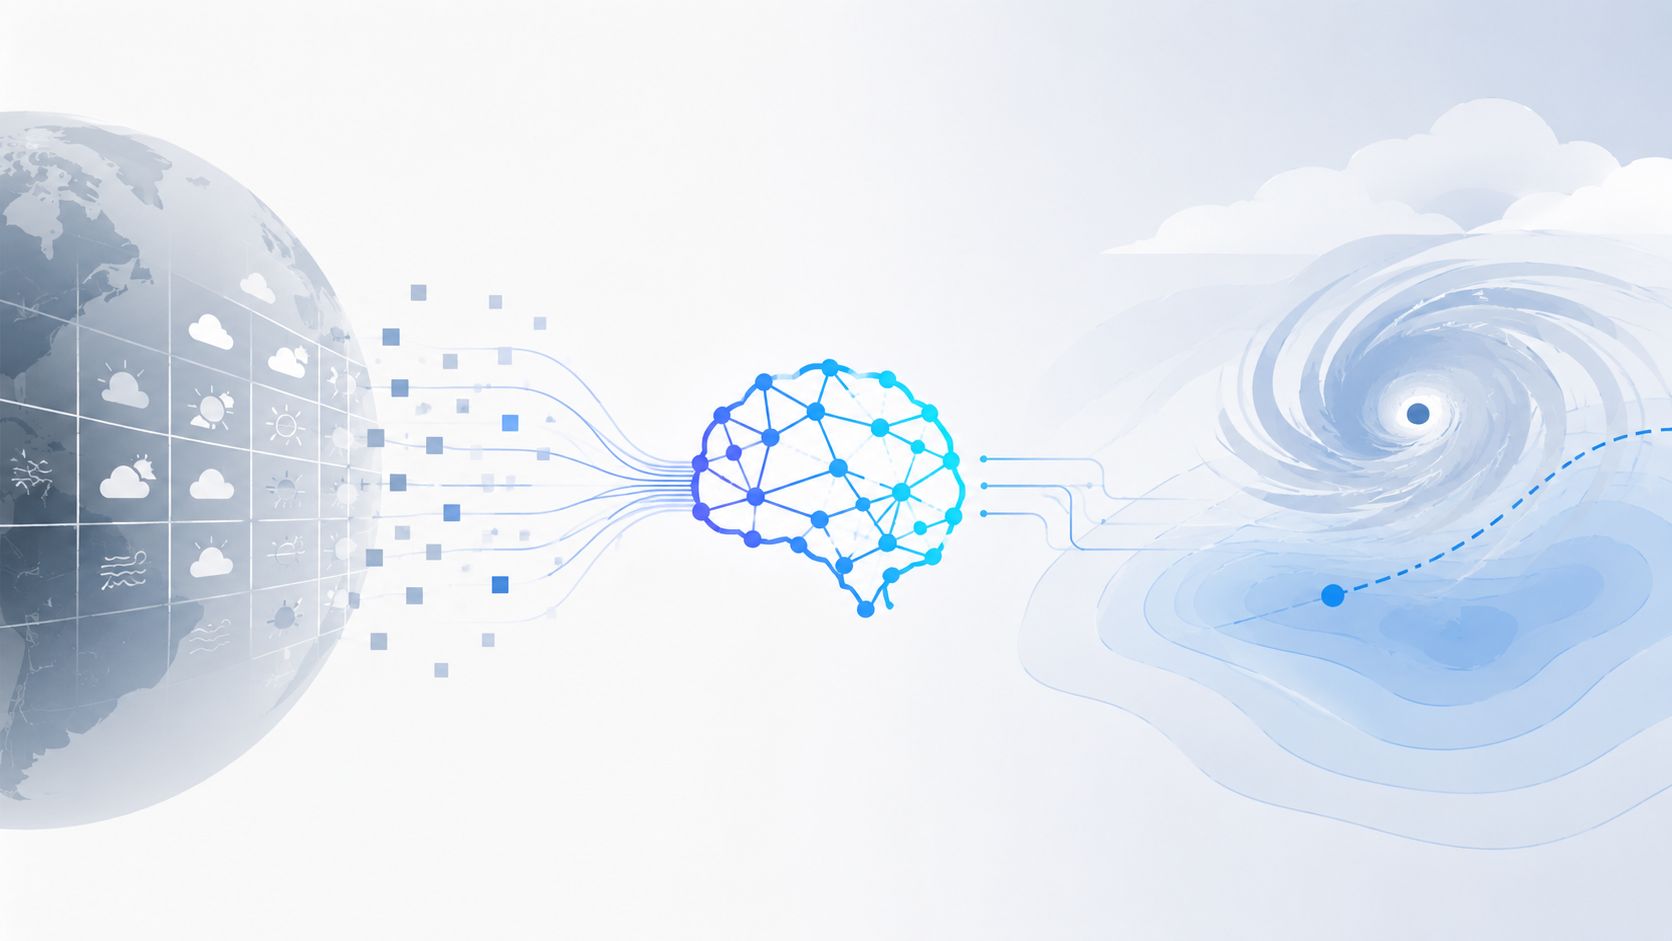
Vision-Language-Action(视觉—语言—动作)模型的目标,是让同一个系统同时处理视觉观察、自然语言任务和机器人动作。语言提供目标,视觉提供当前状态,动作则是模型真正影响物理世界的输出。
这和聊天模型最大的不同,是动作会改变下一次输入。机器人伸手后,杯子可能被挡住;人也可能突然走进工作区。系统不能只生成一条漂亮的动作序列,而要在每个关键时刻根据反馈修正计划。
为什么“看见杯子”还不够
二维图像中的杯子只有像素位置,抓取需要估计深度、姿态、边缘和可接触区域。透明杯、反光金属、被物体遮挡的杯子,都会让视觉模型不确定。
机器人还要理解任务中的隐含约束:拿杯子时不能碰倒旁边的水壶,抓取位置不能压住杯口,放置时要让杯底稳定接触桌面。语言模型可以给出常识性的解释,却不应该直接替代几何规划和低层控制器。更可靠的分工是:高层模型确定目标与粗粒度步骤,专门的运动规划和控制系统负责速度、碰撞、力矩与安全限制。
动作不是一句“点击按钮”
GUI Agent 的动作可以是点击、输入和滚动,机器人动作则带有时间、空间和动力学约束。一个动作通常需要描述关节角、末端位姿、速度、加速度或一段轨迹。输出太细,模型难以稳定预测;输出太粗,控制器又不知道如何执行。
因此实践中常用动作片段(action chunk):模型一次提出接下来一小段连续动作,控制器先执行其中一部分,再用新的观察重新规划。这种方式在反应速度和规划稳定性之间折中,也允许系统在抓取失败、目标移动或环境变化时及时停止。
真正难的是数据和失败恢复
互联网上的图文数据能教模型“杯子是什么”,却不能直接教它手臂在不同摩擦、重量和摄像头角度下怎么抓杯子。机器人数据需要动作轨迹、传感器记录、失败结果和环境变化,采集成本高,覆盖场景却仍然有限。
仿真可以扩大数据量,但仿真里的摩擦、材质、光照和机械误差与现实不同,这就是 sim-to-real gap。解决它不只是把模拟画面做得更逼真,还要让策略对小误差保持鲁棒,并在现实中持续收集失败样本。
安全设计要先于“自主程度”:限制工作空间和速度,为夹爪设置力矩上限,让人能随时急停,给不确定动作设置低风险替代方案。对机器人来说,“我不确定”必须能转化为停下、请求帮助或退回安全姿态,而不是继续猜。
物理世界里的 Agent 应该怎样评估
不能只问模型能不能说出正确答案,还要看任务成功率、碰撞率、恢复时间、对新物体的泛化能力,以及失败是否可解释。一次成功的演示不代表系统可靠,连续数百次操作中偶发的一次危险动作,可能比平均成功率更重要。
Google DeepMind 将 Gemini Robotics 描述为面向物理世界的模型方向,重点正是把多模态理解和动作执行连接起来。它提醒我们:机器人 AI 的核心不是让语言模型“变得更像人”,而是让感知、规划、控制和安全反馈组成闭环。