TLB Shootdown:页表改了,为什么还要通知其他 CPU?
TL;DR
CPU 会缓存虚拟地址到物理地址的转换,页表更新后旧缓存可能仍需失效。本文解释多核同步的原因、成本和现代内核如何减少不必要的刷新。
CPU 会缓存虚拟地址到物理地址的转换,页表更新后旧缓存可能仍需失效。本文解释多核同步的原因、成本和现代内核如何减少不必要的刷新。
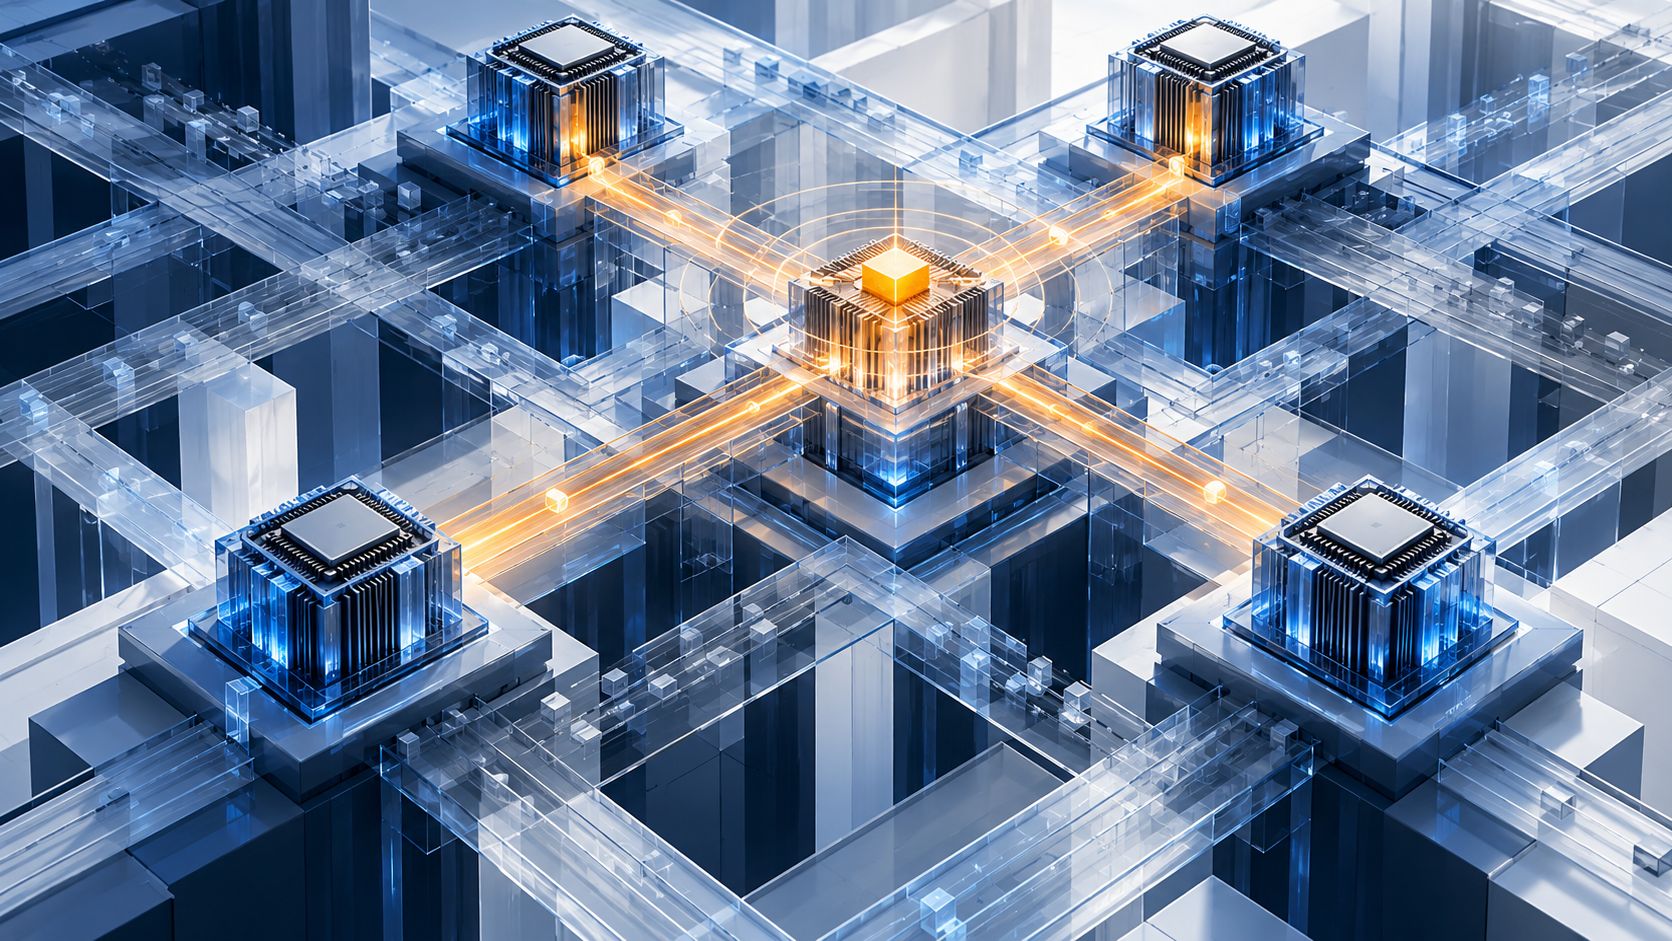
程序访问一个虚拟地址时,处理器需要通过页表找到它对应的物理内存。若每次都层层查页表,开销会很大,于是 CPU 把近期转换结果放进 TLB(地址转换后备缓冲器)。问题在于:操作系统改了页表,TLB 里可能还留着旧映射。所谓 TLB Shootdown,就是在多核系统中协调处理器,让仍可能缓存旧转换的核心及时失效这些条目。
用办公室地图打比方:墙上的总地图刚改了房间编号,但几个同事手里还有旧复印件。只更新总地图并不足够;若同事继续照着旧地图走,就可能读到不该读的数据,或者把写入送到错误位置。TLB 中的旧条目同样可能使进程继续使用过期映射。操作系统因此必须在页表变化和后续访问之间建立正确的同步关系。
为什么叫“shootdown”?历史上常用的做法,是一个 CPU 发起请求,通知其他可能使用该地址空间的 CPU 刷新相应 TLB 项;收到通知的核心执行失效操作并确认完成。全量刷新当然简单,但会清掉许多仍有效的转换,增加之后重新遍历页表的成本。现代内核会尽量精确地判断受影响的地址空间、范围和处理器,减少不必要的广播;不同体系结构提供的失效机制也不完全相同。
这类协调不是抽象的性能小事。频繁创建和销毁映射、进程共享地址空间、内存回收或虚拟机相关操作,都可能引发地址转换同步。核心数量越多,一次失效可能涉及的协作越复杂;跨插槽通信、处理器中断和等待确认都可能增加延迟。不过不能简单说“每次改页表都要暂停所有 CPU”:内核会根据地址空间使用情况和平台能力采取更精细的策略。
调优时要同时看正确性和成本。减少不必要的映射变更、批量处理地址区间,可能降低失效频率;但过度缓存或延迟更新又会影响内存占用和资源回收。只有在性能剖析显示地址转换同步确实是热点时,优化才有依据。普通应用开发者通常不会直接发 shootdown 指令,却会在容器、虚拟机、数据库和高并发运行时的性能问题中间接遇到它。
TLB Shootdown 揭示了多核系统的一条重要规律:内存映射虽然由操作系统维护,却可能同时被多个处理器缓存,所以“改一张页表”有时需要一场小型的跨核协作。