文字转语音为什么越来越像真人
TL;DR
解释文字转语音如何处理发音、停顿、重音和语气,以及为什么专有名词和缺少上下文的短句仍可能被读错。
现代文字转语音系统不仅把文字转换成发音,还要处理停顿、重音、语速、音高和上下文。本文解释文本分析、韵律建模与神经网络合成如何共同让机器声音更自然。
“像真人”不只是把文字换成声音
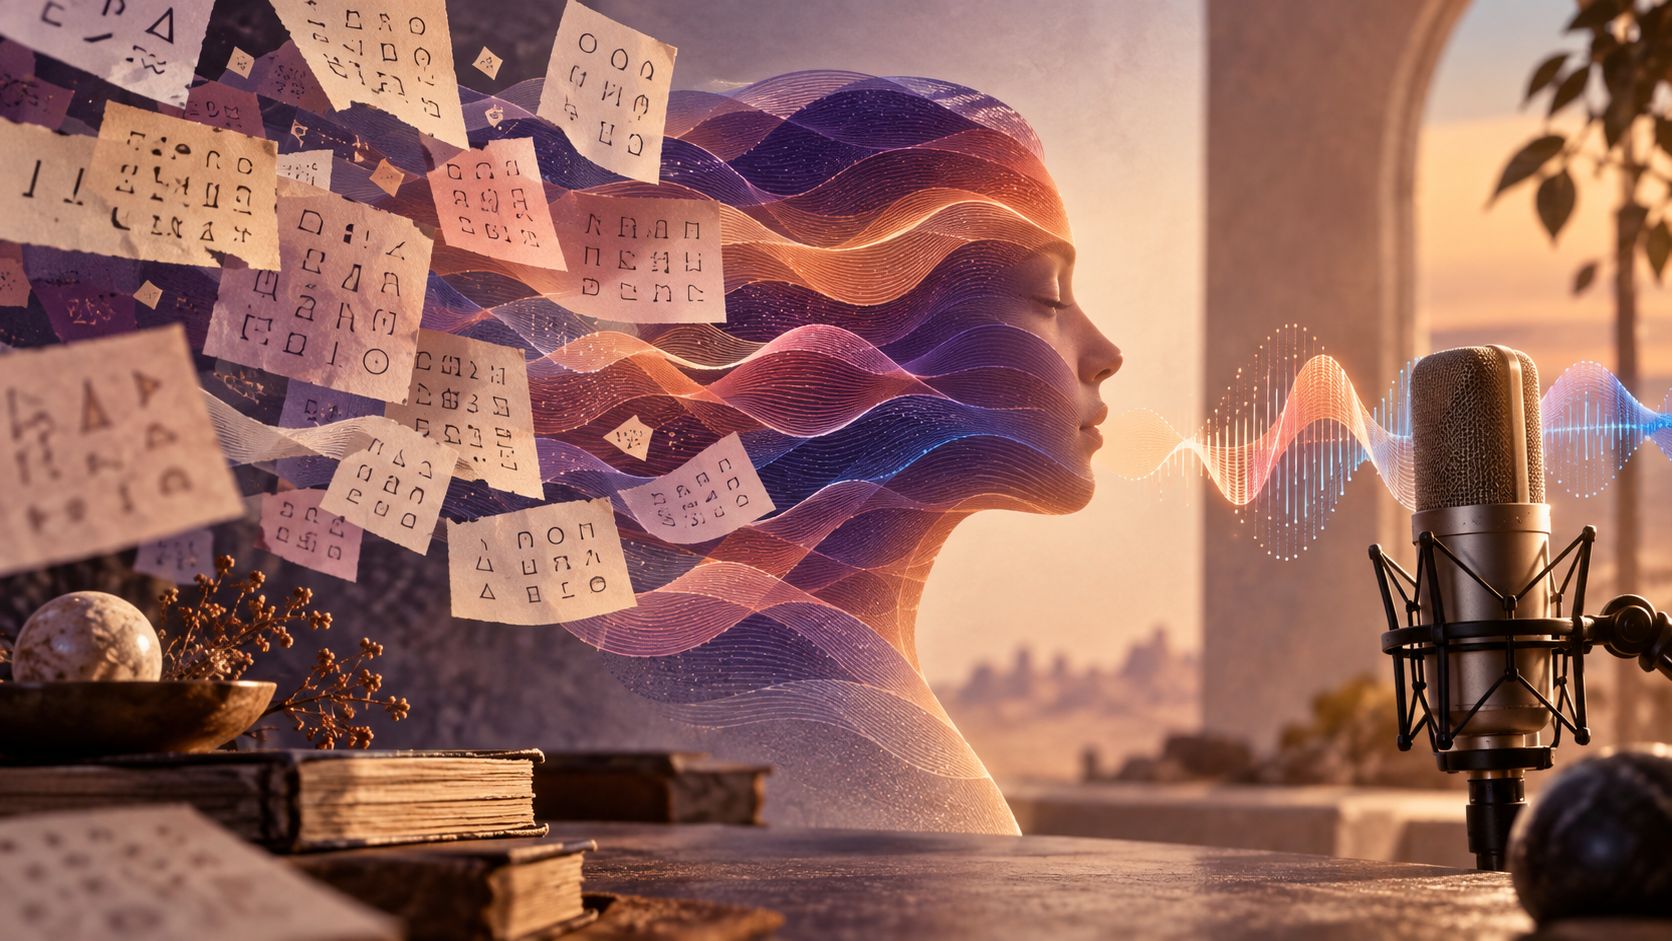
早期的机器语音常常有明显的机械感:每个字发音清楚,却不像人在说话。问题不只是音色。真人说话会根据句子结构停顿,会对重点词加重,会在疑问、陈述和提醒之间改变语调,还会根据上下文决定同一个字应该怎么读。现代文字转语音系统要做的,是把文字转换成一条包含语言信息和声音节奏的生成过程。
从文字到声音要经过几层处理
第一层通常是文本分析。系统要识别数字、日期、缩写、标点和专有名词,把“2026/09/13”这样的字符转换成适合朗读的表达。第二层是语言与发音处理:系统需要判断词语边界、读音和重音,中文还要处理多音字与语境。
接下来是韵律,也就是语速、停顿、音高和强调位置。最后,声学模型根据这些信息生成声音特征,再由声码器合成为可以播放的音频。Google Cloud 的文字转语音文档说明,服务既可以接收普通文本,也可以接收 SSML;SSML 允许调用者更明确地控制停顿、发音、音高和语速。相关 API 使用神经网络模型生成自然语音,这也是现代系统比传统拼接式语音更灵活的原因之一。
为什么同一个声音能读出不同情绪
声音身份和表达方式是两个层次。一个系统可以保持相对稳定的音色,同时根据句子结构调整节奏和音高。新闻播报需要清晰、稳定,导航提示需要短促、明确,有声内容则可能需要更丰富的停顿和情绪。模型从大量语音样本中学习这些对应关系,再根据输入文字和控制参数生成新的声音。
但“自然”不等于“永远正确”。人名、地名、品牌缩写、网络用语和上下文不足的短句,仍可能被读错;文本本身没有标出情绪时,系统也只能根据语言线索猜测。越是短、越是脱离上下文的文字,越容易出现“发音没错但语气不对”的情况。
使用时如何得到更好的结果
如果你只是让手机朗读文章,清晰度比戏剧化更重要;如果你在制作教程、播客或视频,应该先整理标点和段落,再为专有名词、数字和缩写提供读法。需要控制停顿时可以使用服务支持的标记语言,但不要把一整段文字塞成没有结构的长句。对重要内容,最好人工听一遍,尤其检查姓名、金额、日期和安全提示。
一句话总结:高质量文字转语音是在同时生成“说什么”和“怎么说”,音色只是其中最容易被听见的一部分。