SWIM:集群如何知道谁还活着,又不让心跳消息爆炸?
TL;DR
SWIM 用随机直接探测、间接探测和 gossip 传播维护集群成员关系,把故障检测与信息扩散分离,降低心跳通信的规模增长。
SWIM 用随机直接探测、间接探测和 gossip 传播维护集群成员关系,把故障检测与信息扩散分离,降低心跳通信的规模增长。
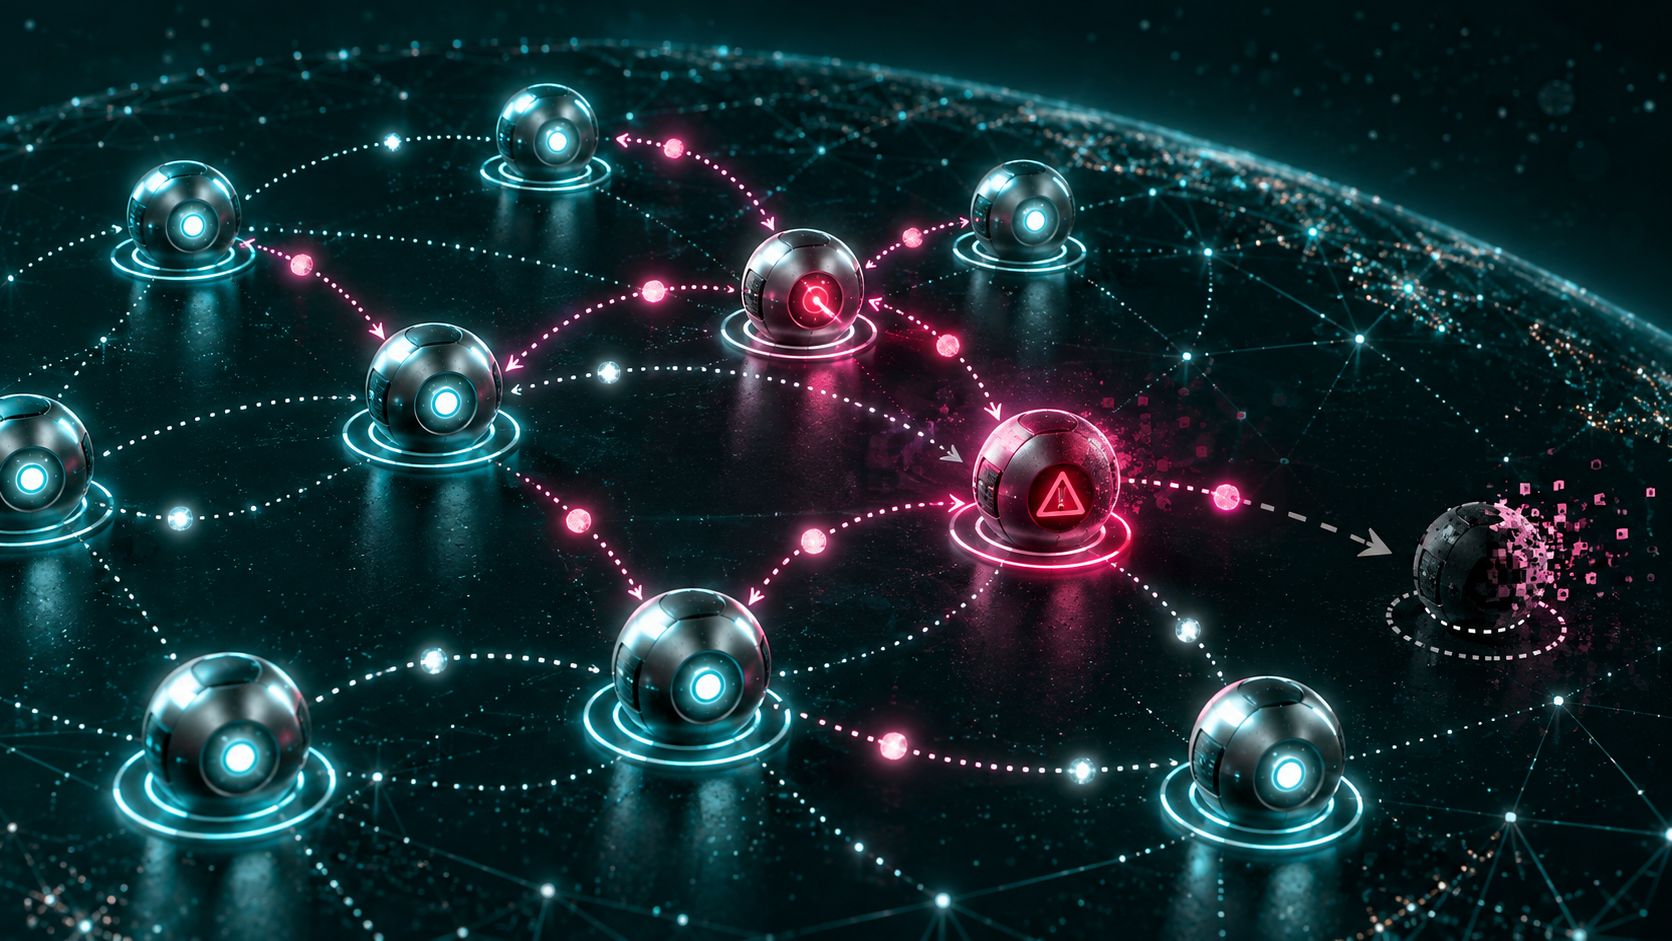
集群里的每个节点都需要知道谁还活着,但如果每个节点都定期给所有其他节点发心跳,消息数量会随着节点数平方增长。SWIM 是一种成员关系与故障检测协议,它用随机探测和流行式传播,把“谁在线”的维护成本控制在更可扩展的范围。
可以把它想成一群人维护一张通讯录。每轮里,一个节点随机挑选另一个节点直接 ping;如果没有回应,就请其他节点代为间接探测。只有多次探测仍失败,节点才会被标记为可疑,而不是立刻宣布死亡。这样能降低短暂丢包、调度抖动带来的误判。
成员变化通过 gossip 传播:收到更新的节点会把它带给其他随机伙伴,信息像传染一样逐步覆盖集群。协议把故障检测和信息传播拆开,让探测逻辑不必承担全网广播的成本;在理想条件下,每个成员每轮只处理常数级的消息,整体通信量随成员数近似线性增长。
“可疑”状态是 SWIM 很重要的缓冲层。网络可能短暂拥塞,节点可能只是忙于垃圾回收或暂停调度。如果直接删除,集群会反复加入、移除同一节点;先传播怀疑,让被怀疑者有机会通过其他路径证明自己,更能控制误报。真实实现还要考虑重启后的 incarnation 编号,避免旧消息把新状态覆盖。
SWIM 的价值不在于保证每次都立刻判断正确,而在于以可控消息成本获得最终收敛的成员视图。它适合服务发现、分片集群和节点编排,但上层仍要为网络分区、误判、重入和状态重建设计应对方案。
SWIM 传播的成员视图通常是最终一致的,不保证所有节点在同一瞬间做出同一判断。需要强一致选主或提交事务的系统,不能把 gossip 成员列表直接当成共识结果;它更适合提供“可能可达、可能失效”的基础事实,再由上层做隔离和恢复。
资料来源:SWIM:Scalable Weakly-consistent Infection-style Process Group Membership Protocol