可复现构建:同一份源代码应该得到同一份软件
TL;DR
了解时间戳、路径和工具版本如何影响构建结果,以及如何让软件产物可重新验证。
可复现构建要求相同源码和构建条件产生逐字节一致的产物,帮助 AI 生成的软件实现验证、审计与问题追踪。
可复现构建:同一份源代码应该得到同一份软件
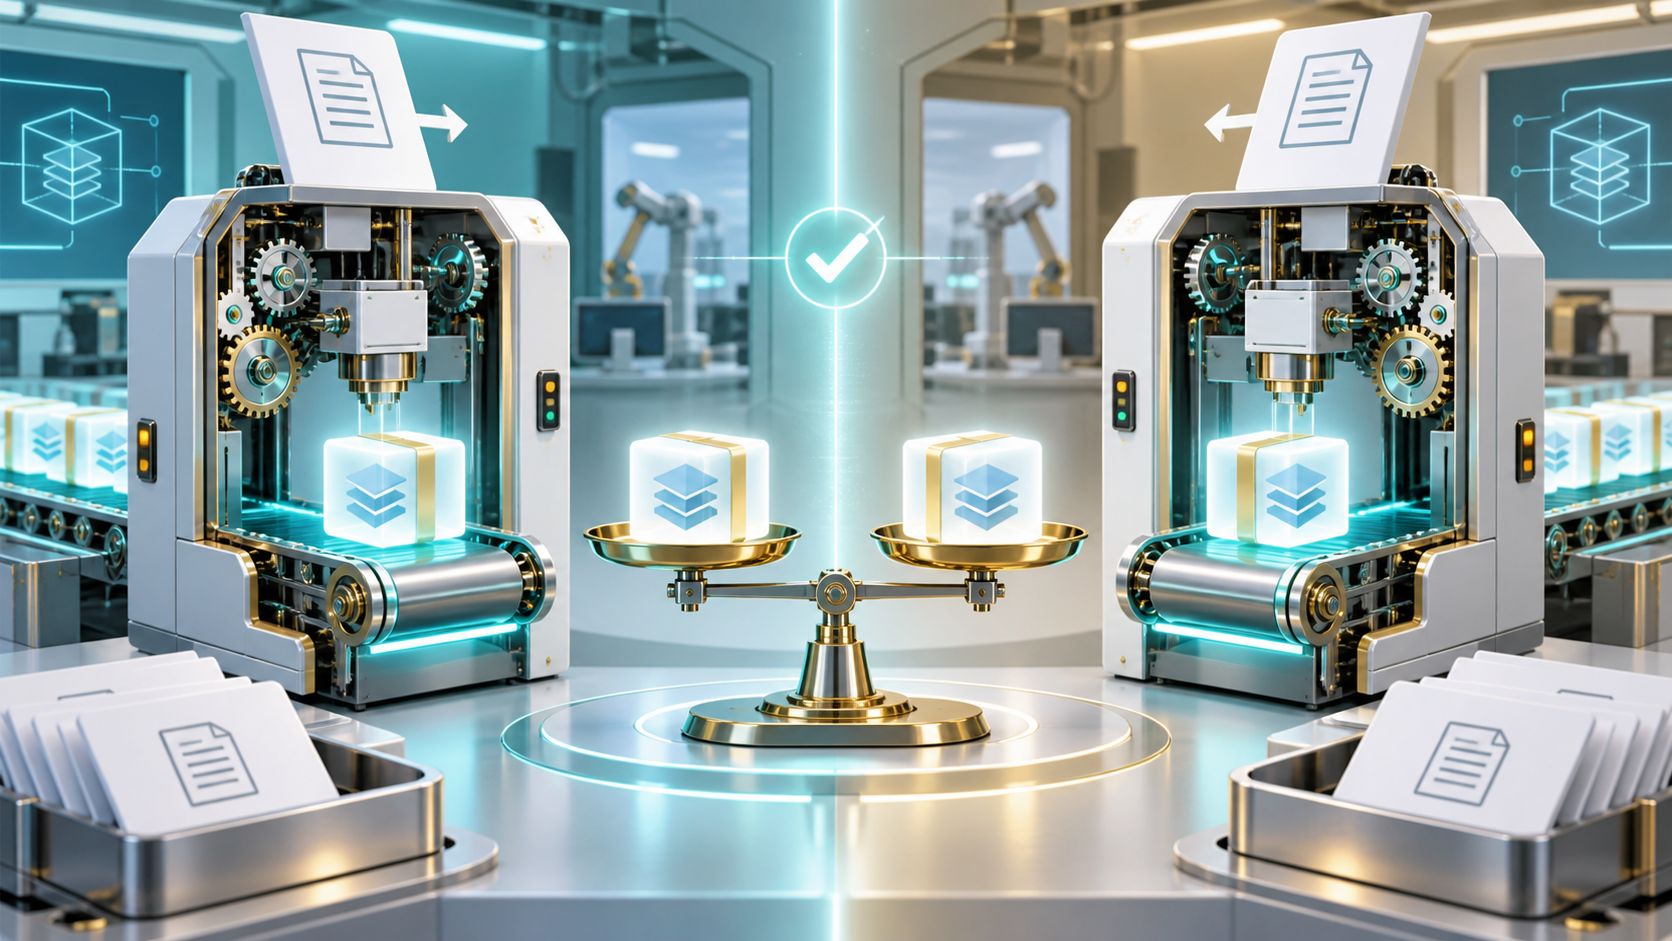
软件交付时,人们通常关心“源码是什么”,却容易忽略“二进制是怎样产生的”。可复现构建要求:在相同源码、构建环境和构建指令下,不同的人或不同机器能够得到逐字节一致的产物。它让源码和最终安装包之间多了一条可以验证的连接。
为什么同一份代码会产生不同文件
构建过程可能把当前时间、机器路径、用户名、随机数、文件遍历顺序或本机工具版本写进产物。即使这些差异不影响程序运行,最终哈希也会不同。某些压缩格式还会记录文件时间和权限,导致“内容看起来一样”但字节不一样。
因此,可复现构建不是简单地把代码再编译一次,而是逐步清理不稳定输入:固定依赖,稳定排序,统一时区,去掉无意义的时间戳,记录编译器版本,并确保构建步骤不偷偷访问系统外部资源。
AI 生成代码为什么需要这个概念
Vibe Coding 的速度很快,产物也可能由不同 Agent、不同云环境和不同 CI 工作流生成。如果每次构建都留下不同的二进制,出了问题就很难判断差异来自代码、工具还是环境。可复现构建让团队可以重新生成产物并与原产物比较。
它还有审计价值。如果源码没有变化,构建结果却发生了无法解释的变化,就值得检查工具链、依赖和构建脚本。对于使用 AI 生成或修改的项目,这种“结果可重新验证”尤其重要。
可复现不等于功能正确
错误的代码也可以被稳定地构建十次。可复现性解决的是“同样输入是否得到同样输出”,不是“输出是否符合需求”。它需要和测试、静态分析、安全扫描及人工审查一起使用。
普通开发者怎样开始
先记录 Node、Python、JDK、编译器和包管理器版本,再在干净环境中构建两次并比较产物。若结果不同,就让 AI 帮忙找出时间、路径、顺序或随机性来源,而不是立即重新生成所有代码。
可复现构建的定义和实践建议见 Reproducible Builds 官方文档。