NUMA:同一台机器上的内存,为什么有的更近更快?
TL;DR
NUMA 把多路服务器的 CPU 与内存看成多个距离不同的节点,本地访问通常更快,线程与数据的放置会直接影响吞吐和尾延迟。
NUMA 把多路服务器的 CPU 与内存看成多个距离不同的节点,本地访问通常更快,线程与数据的放置会直接影响吞吐和尾延迟。
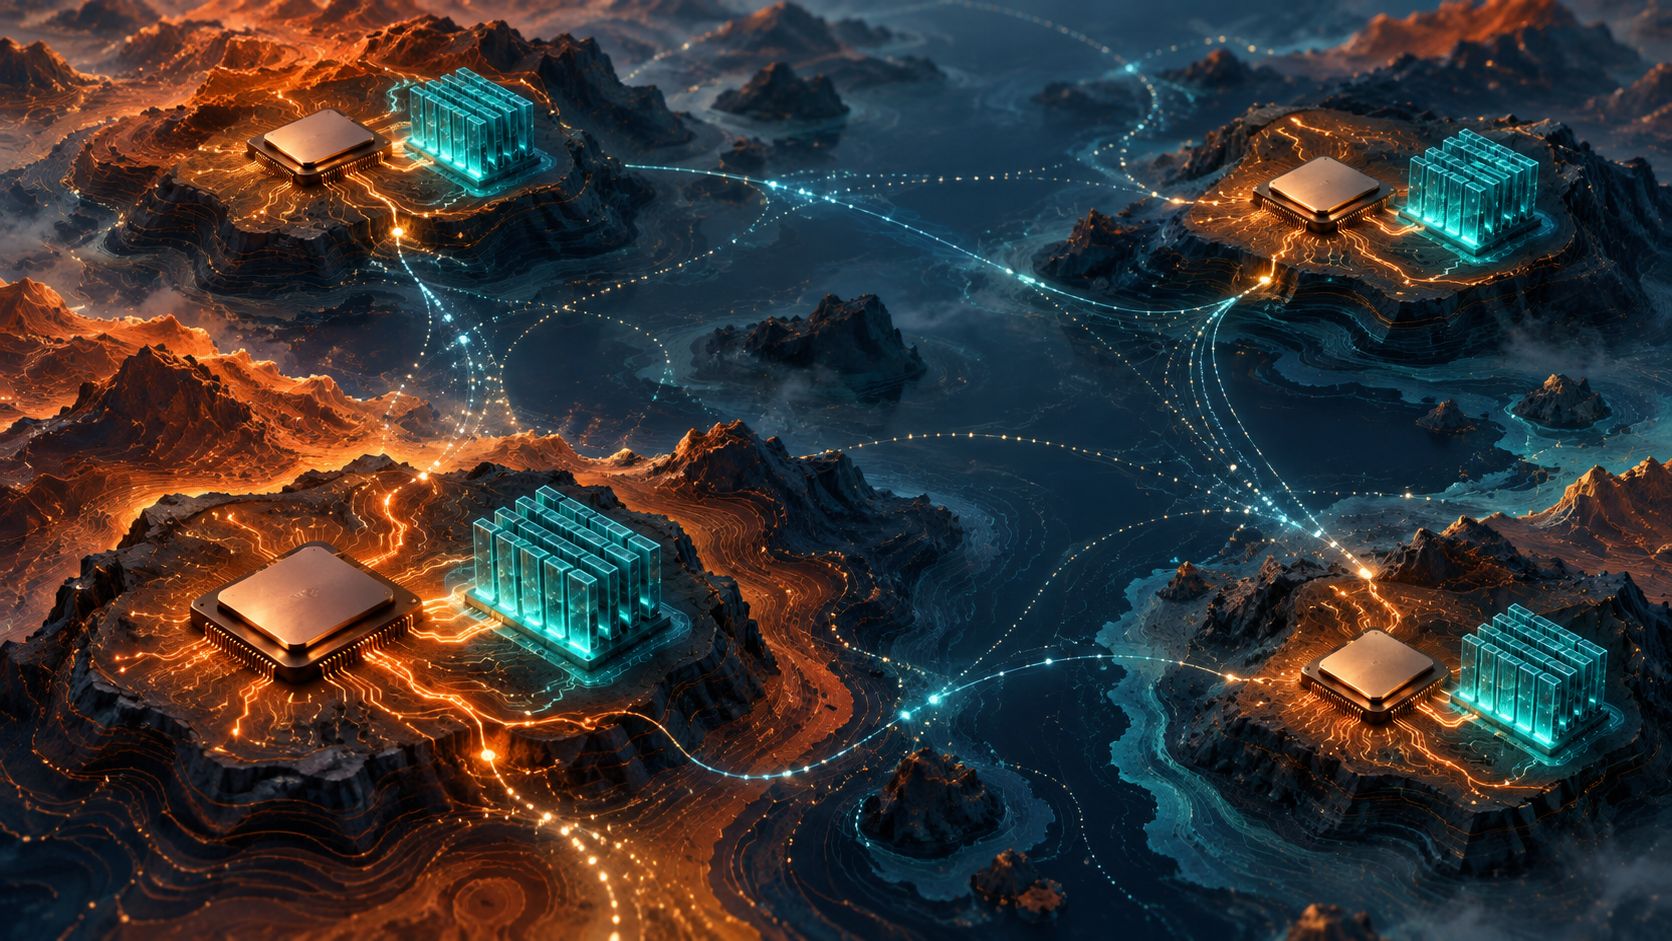
在多路 CPU 服务器里,“内存”并不是一整块距离相同的池子。NUMA(Non-Uniform Memory Access,非一致内存访问)把机器看成多个节点:每个节点拥有处理器和本地内存,访问本地内存通常更快,访问另一个节点的内存则要经过互连链路。
可以把它想成一座由多个园区组成的大学。每个园区都有自己的图书馆,学生在本园区取书最快;如果要去远处园区借书,需要走更长的路,还会占用园区之间的通道。所有图书馆仍然属于同一所大学,但距离决定了访问延迟和可用带宽。
NUMA 的性能问题往往不是单次访问慢,而是数据和线程长期“住错地方”。如果一个线程在节点 A 上运行,却反复读取节点 B 的大数组,就会产生跨节点流量;多个线程还可能争用同一条互连。操作系统和运行时会尝试使用本地分配、线程绑核、页面迁移和内存策略,把计算和数据放在相近的节点上。
对开发者来说,数组、对象池、缓存和数据库页的布局都可能暴露 NUMA 影响。线程池如果随意在所有 CPU 间迁移,线程本地缓存会失效;任务如果被调度到远端节点,理论上的并行度可能换来实际的内存瓶颈。反过来,把线程和数据过度绑定,也可能导致一个节点内存耗尽、其他节点闲置。
NUMA 不是“内存分成了几块就完事”,而是一种需要把拓扑纳入性能模型的架构事实。观察节点间延迟、带宽、线程亲和性和页面归属,往往比单纯增加 CPU 核心更能解释大型服务的尾延迟。
排查 NUMA 问题时,平均 CPU 利用率往往不够。更有用的线索包括远端内存访问比例、每个节点的内存压力、线程迁移和跨节点互连带宽。只有把这些指标与请求延迟、缓存命中和任务分布放在一起看,才能判断瓶颈究竟来自计算、内存容量,还是节点之间的交通。