PSI:CPU 没跑满,系统为什么还是会卡?
TL;DR
PSI 从任务停顿而非单纯硬件利用率衡量 CPU、内存和 I/O 压力。本文介绍 some/full 信号、阈值监控及解读时的常见误区。
PSI 从任务停顿而非单纯硬件利用率衡量 CPU、内存和 I/O 压力。本文介绍 some/full 信号、阈值监控及解读时的常见误区。
一台机器的 CPU 利用率没有达到 100%,用户却觉得系统卡顿,这并不矛盾。CPU 数字描述处理器忙不忙,却不一定说明有多少任务正在等待资源。PSI(Pressure Stall Information,压力停顿信息)试图回答另一个问题:任务因为 CPU、内存或 I/O 资源不足,实际停下来等了多久?
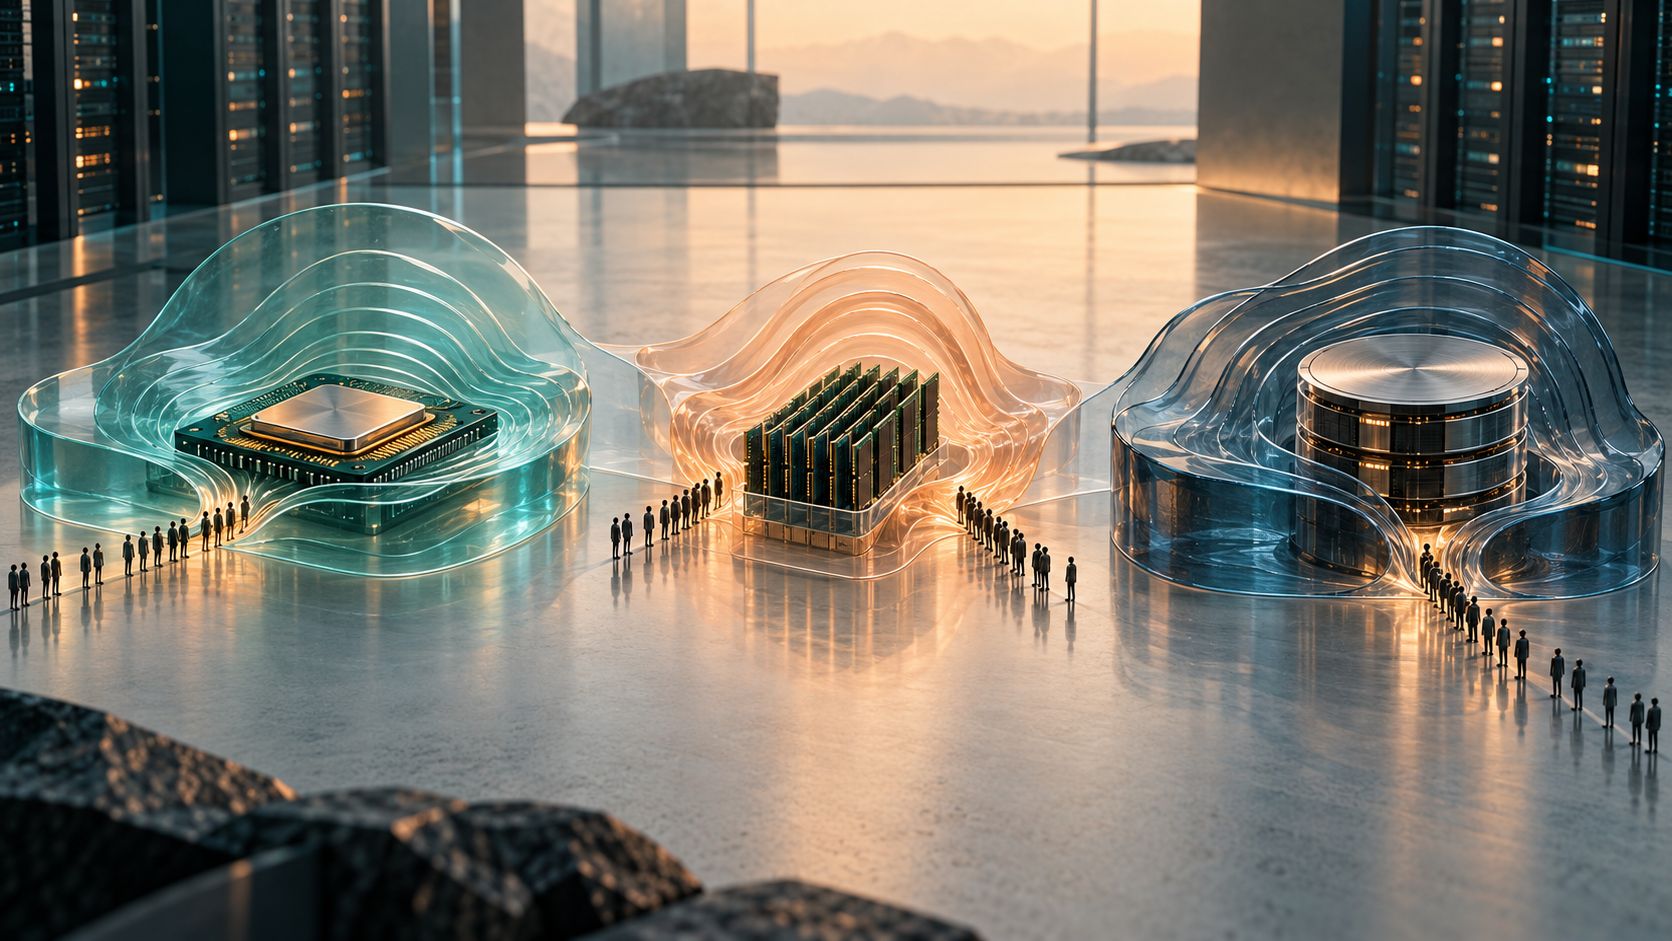
可以把系统想成一个服务大厅。看窗口工作人员是否忙碌,不等于知道顾客排队等了多久;反过来,窗口没满负荷,也可能有一群顾客被某个关键步骤堵住。PSI 从任务停顿角度衡量压力,为系统管理员提供“资源瓶颈是否正在拖住工作”的信号。Linux 的 PSI 接口区分 some 与 full 等情况:前者关注一部分任务受影响,后者关注某些时间区间内全部非空闲任务都受影响。它按资源类型提供相应统计和监控能力。
内存压力尤其容易被误读。即使机器尚未完全耗尽物理内存,回收页面、等待交换或争抢内存也可能让任务停顿。I/O 路径上,设备队列变长或请求等待也可能拖慢工作;CPU 压力则可能体现为可运行任务排队。PSI 把不同资源造成的停顿分别呈现,帮助你把“感觉慢”转化为更具体的观察对象。
PSI 的监控接口还允许应用或管理组件设置阈值并接收压力事件,可用于在机器恶化前采取动作,例如限流、调整工作负载或释放缓存。它不是自动优化器,也不会替你决定哪个任务应该让路。阈值怎么定,需要结合业务延迟目标、正常基线和负载波动;不同工作负载的合理值并不相同。
读 PSI 时,最好与 CPU 利用率、内存回收、磁盘延迟、队列长度以及服务端到端延迟一起看。单一读数不能直接证明根因:高压力可能是上游流量突然增加的结果,也可能是资源配置不足,或由某个异常任务造成。还要注意采样窗口和统计范围,避免把短暂尖峰误判成长期故障。
PSI 的价值是把“资源紧张”从一个模糊标签变成可量化的任务停顿。它特别适合容器、服务器和资源管理系统观察系统何时真正拖住了工作,而不是只看某个硬件仪表盘上的百分比。