io_uring:Linux 如何用两个环形队列批量处理异步 I/O?
TL;DR
io_uring 通过提交队列和完成队列连接应用与内核,让大量 I/O 请求可以批量提交与收取结果,减少固定交互成本。
io_uring 通过提交队列和完成队列连接应用与内核,让大量 I/O 请求可以批量提交与收取结果,减少固定交互成本。
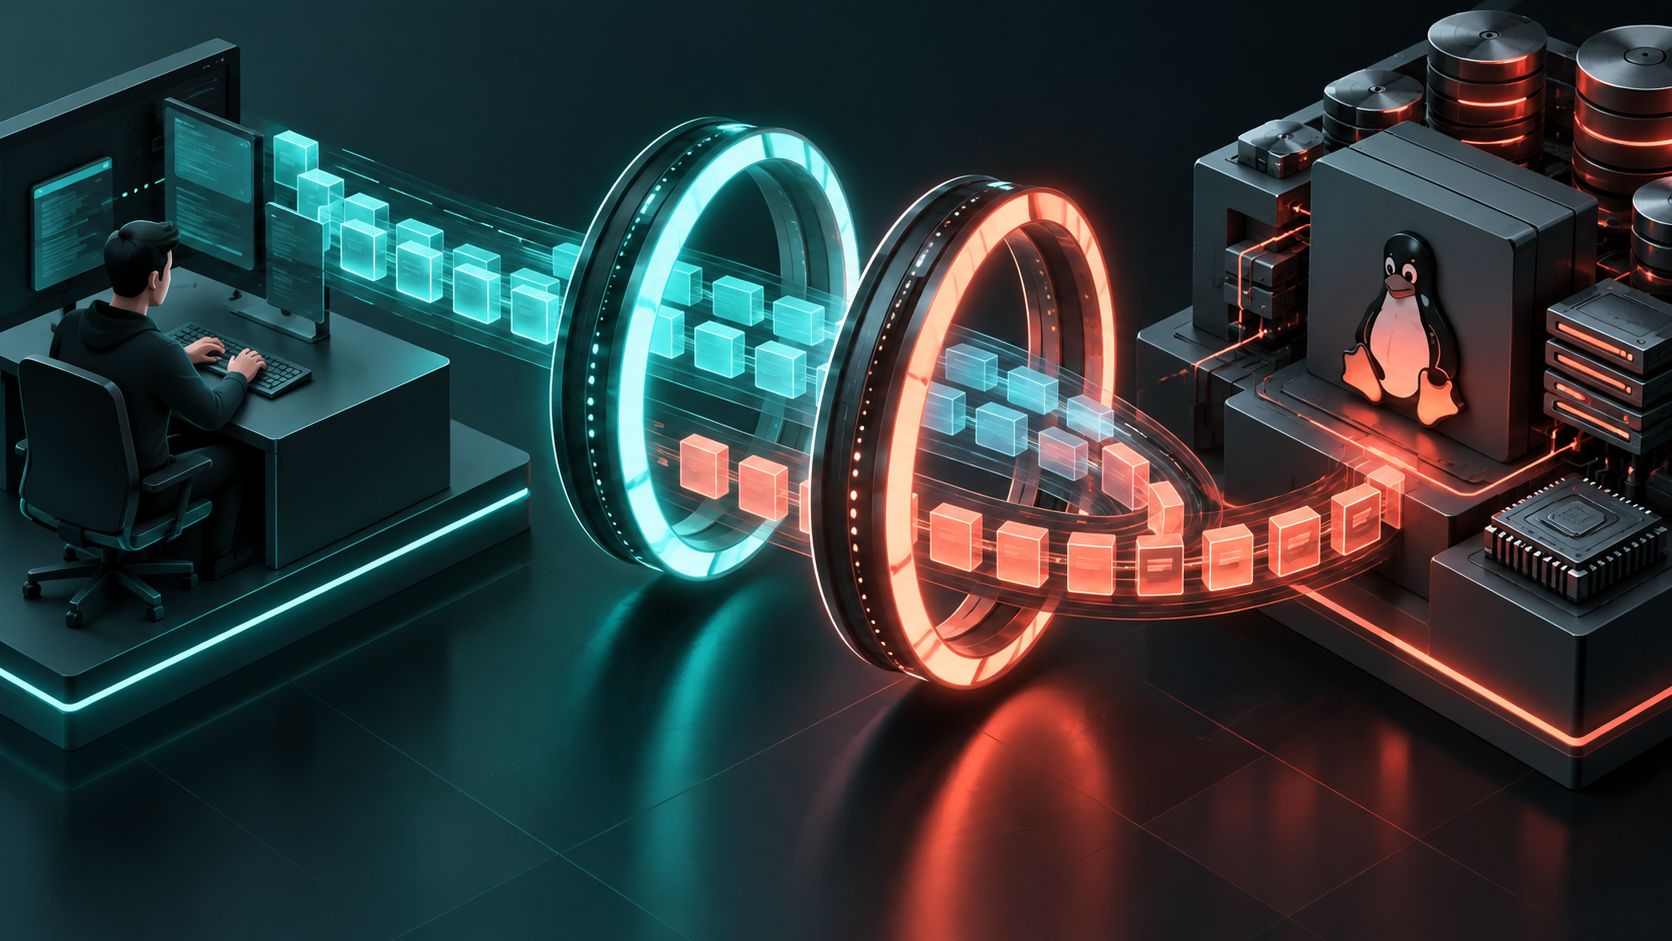
传统异步 I/O 常把一次操作拆成系统调用、等待和回调,程序与内核之间来回切换。io_uring 是 Linux 提供的一套共享环形队列接口:应用把待做的请求放进提交队列,内核完成后把结果放进完成队列,双方都能批量处理。
可以把它想成厨房和传菜窗口之间的两条传送带。应用把“读这个文件、写那块缓冲区”的任务卡放到提交带上,内核厨师持续取卡执行;完成后,结果卡会被放到另一条完成带上。应用不必为每张卡都敲一次门,而是一次放入一批,再一次性收取多个结果。
提交队列里的元素通常描述操作类型、文件描述符、缓冲区、偏移量和用户数据;完成队列里的元素则告诉应用结果码和实际处理了多少字节。共享内存环让生产者和消费者能低成本交换这些条目,批处理还能减少系统调用次数。对网络服务器、存储服务和高吞吐代理来说,这种减少边界切换的能力很有吸引力。
但 io_uring 不等于“所有 I/O 自动变快”。任务是否真正异步、内核版本和文件系统是否支持某种操作、缓冲区生命周期是否稳定,都会影响收益。程序还要正确处理部分完成、错误码、取消、超时和队列回压;如果应用不断塞入请求却不及时消费完成队列,环形队列本身也会成为瓶颈。
它的价值更像是一种批量化的内核协作模型:把请求描述、执行和完成通知标准化,减少每次操作的固定交互成本。理解提交队列与完成队列后,异步 I/O 就不再只是“开一个线程等待”,而是应用和内核围绕共享队列共同推进工作。
队列深度也是性能模型的一部分。队列太浅,内核无法形成批量并行;队列太深,请求会在内存中排队,尾延迟和取消成本反而上升。一个成熟的 io_uring 使用方式通常会根据磁盘、网卡和业务吞吐动态调节在途请求,并让完成事件及时回收对应的缓冲区和用户数据。
资料来源:Linux io_uring(7) 手册