Hedged Requests:为什么同一个请求有时会被同时发两次?
TL;DR
Hedged Requests 在主请求短暂变慢时向另一个副本发起备用请求,用少量额外流量降低长尾延迟。本文区分对冲请求与普通重试,解释它的适用边界、幂等要求和 AI 服务中的使用场景。
Hedged Requests 在主请求短暂变慢时向另一个副本发起备用请求,用少量额外流量降低长尾延迟。本文区分对冲请求与普通重试,解释它的适用边界、幂等要求和 AI 服务中的使用场景。
分布式系统里,平均延迟往往看起来不错,但总有少量请求特别慢。一个请求可能恰好落到繁忙的机器、遭遇网络抖动,或者等待一项偶发的后台任务。如果用户必须等最慢的那一小批请求,整体体验就会被长尾延迟拖住。Hedged Requests,中文可称为“对冲请求”,是一种处理长尾延迟的方法。
它不是普通重试
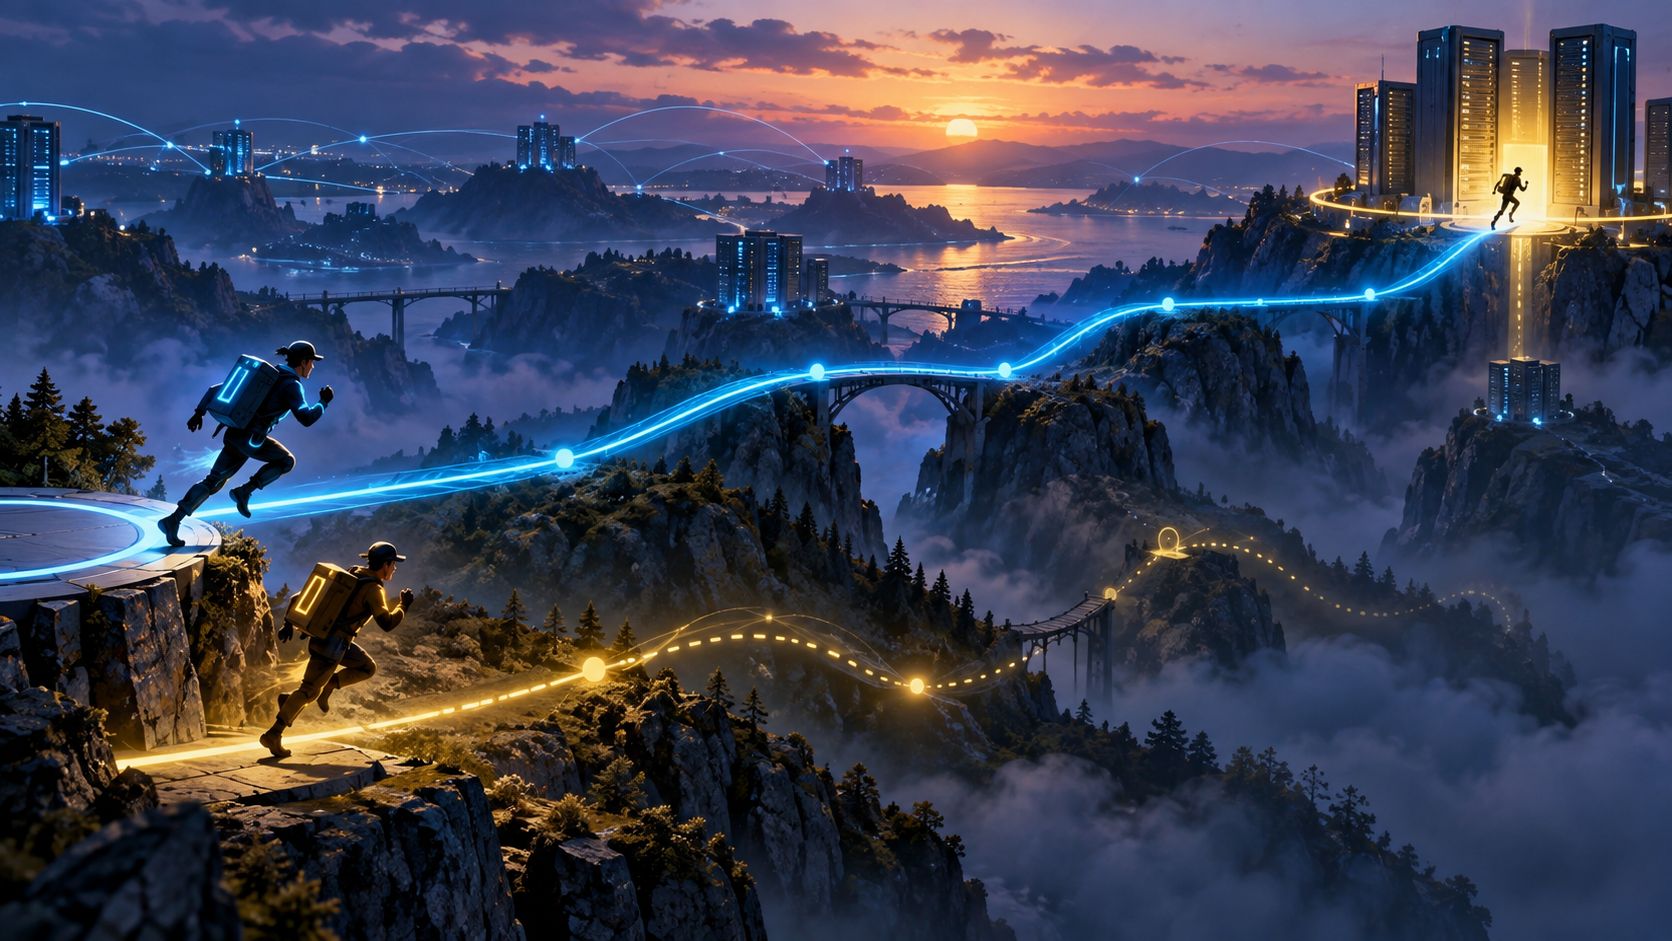
普通重试通常发生在请求失败、超时或明确返回错误之后。对冲请求则会先发送一个主请求,等待很短时间;如果它还没有完成,就向另一个副本或不同路径发起备用请求,最终采用先返回的结果,并取消或忽略较慢的那一个。
这样做相当于用少量额外流量换取更低的极端延迟。Google 的 The Tail at Scale 讨论过这种思路:不要只盯着平均值,而要针对少数慢请求设计容错机制。
为什么不能到处使用
对冲会增加请求量。如果操作有副作用,例如扣款、发货或写入订单,重复执行可能造成严重问题。它更适合读请求、幂等查询或有明确去重键的操作。即使是读请求,也要考虑两个副本同时返回不同版本数据的问题。
延迟阈值也不能拍脑袋设置。太短会制造大量备用请求,太长又无法改善长尾。通常需要观察分位数延迟、取消比例、额外流量和后端负载,再选择合适的等待时间。
对 AI 服务有什么启发
一次 AI 请求可能经过模型、检索、工具和多个网络服务。长尾不一定来自模型本身,也可能来自流水线中的某个慢环节。对冲可以用于可替换的检索副本或只读服务,但必须配合预算、取消传播和幂等设计。
读者应该记住
Hedged Requests 的思路是“不要把用户交给最慢的那条路径”。它适合在可控的额外成本下压低尾延迟,但不适合无脑复制所有有副作用的请求。