FlashAttention:注意力计算没变,为什么显卡能少搬很多数据?
TL;DR
FlashAttention 通过分块计算与在线 softmax 减少 GPU 显存往返,并避免物化完整注意力矩阵。本文解释它为何加速长序列训练,同时指出密集注意力的二次计算量并未消失。
FlashAttention 通过分块计算与在线 softmax 减少 GPU 显存往返,并避免物化完整注意力矩阵。本文解释它为何加速长序列训练,同时指出密集注意力的二次计算量并未消失。
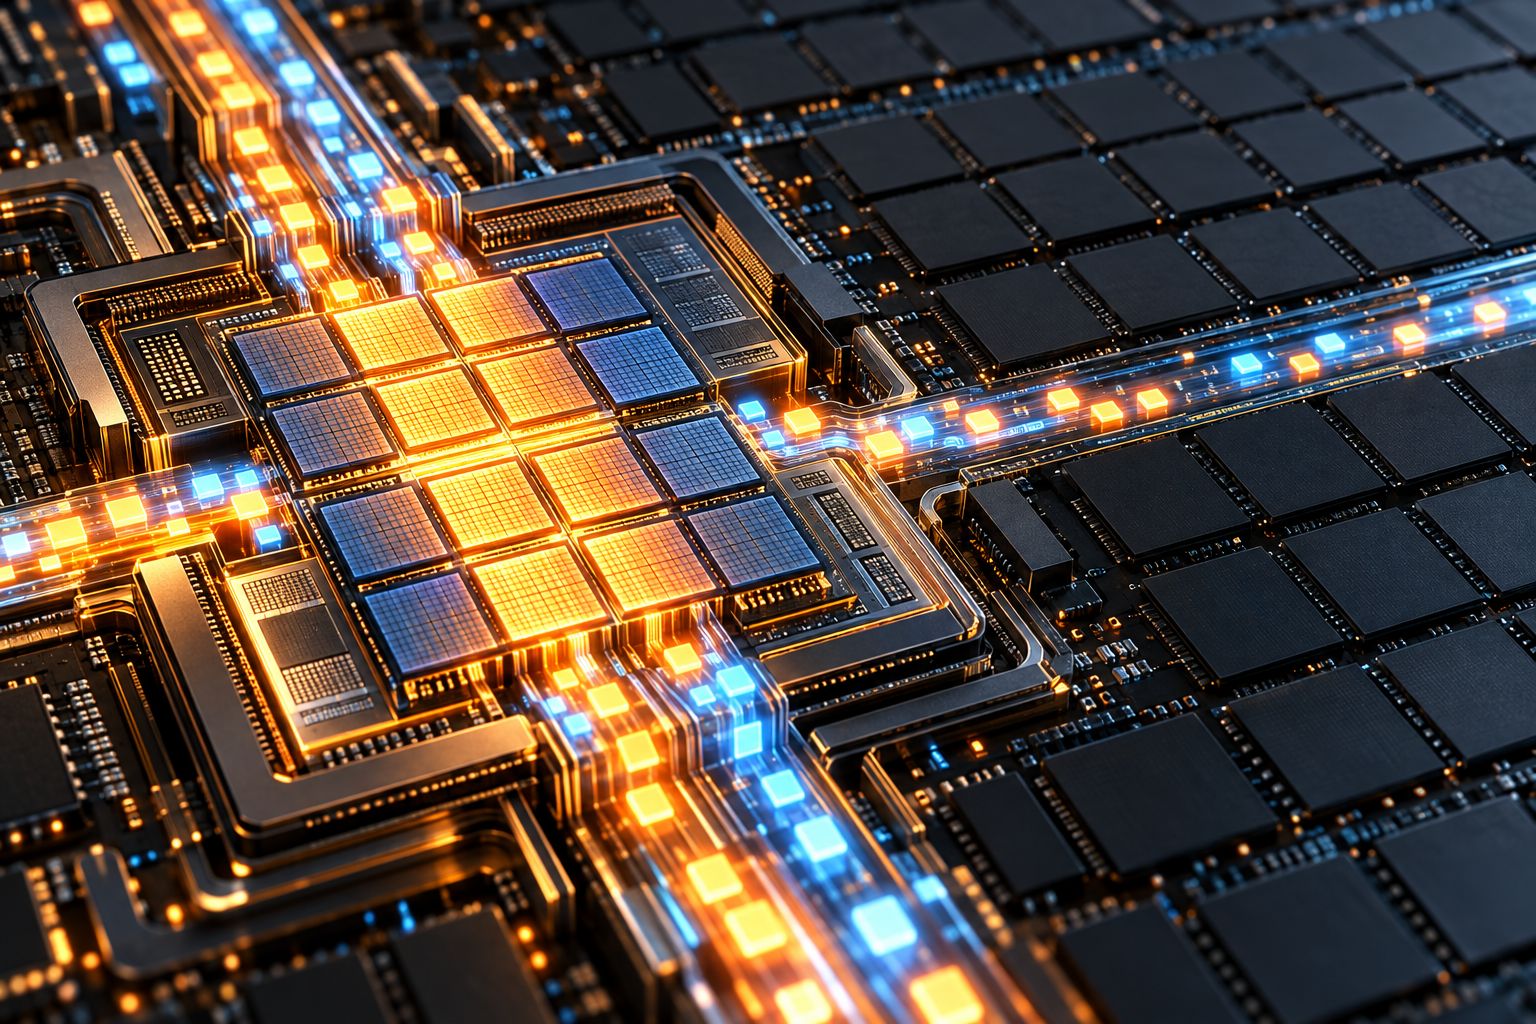
Transformer 的自注意力会比较序列中各个位置之间的关系。序列长度为 N 时,朴素实现往往要形成一个 N×N 的注意力矩阵,再计算 softmax 与加权求和。序列越长,矩阵越大;更隐蔽的瓶颈是,大量中间结果需要在 GPU 的高速片上存储与容量更大的显存之间来回搬运。
FlashAttention 的关键不是改变注意力的数学答案,而是重新安排计算顺序。GPU 上的片上 SRAM 很快,但容量有限;高带宽显存(HBM)容量大一些,访问成本也更高。FlashAttention 把查询、键和值切分成小块,逐块计算注意力,并在线更新 softmax 所需的统计量。这样可以避免把完整的 N×N 注意力矩阵写入显存再读回来。
为什么这种分块还能算出正确结果?softmax 的分母是所有键对应分数的指数和,表面上必须等看完全部位置才知道。算法利用分块累积的最大值、归一化因子与加权输出,在处理下一块时调整已有统计量,最终得到与标准注意力等价的结果(数值计算中允许浮点舍入差异)。反向传播也会重新计算部分中间值,以减少保存大量激活所需的显存。
这是一种典型的“少搬数据、必要时多算一点”的硬件算法设计。GPU 上访存往往比算术操作更昂贵,因此多做一些局部计算,反而可以缩短总体耗时并减少显存占用。尤其在长序列和训练场景中,避免存储完整注意力矩阵,能让更大的批量或更长上下文成为可能。
不过 FlashAttention 并没有消除密集注意力的二次计算量。每个查询位置仍要与很多键位置计算关联,序列长度翻倍时,主要计算量仍大约按平方增长。它主要优化的是 I/O 复杂度和内存占用,不是把所有长上下文问题变成线性复杂度;实际加速也依赖 GPU 架构、数据类型、序列长度及实现版本。
可以把它想成不用把整本书复印到桌面再算,而是每次取几页,在桌面上更新总账,然后把过期的草稿丢掉。桌面空间小但快,仓库(显存)大却不适合频繁往返。FlashAttention 的贡献,是让注意力算法顺着 GPU 的内存层次来安排工作,而不是把硬件当作无限大的平面黑板。