CRUSH:Ceph 怎样决定数据放在哪些磁盘和机架上?
TL;DR
Ceph CRUSH 根据对象标识、集群拓扑和 placement rule 计算副本位置,避免依赖逐对象中心目录。本文解释故障域建模与规则配置的重要性。
Ceph CRUSH 根据对象标识、集群拓扑和 placement rule 计算副本位置,避免依赖逐对象中心目录。本文解释故障域建模与规则配置的重要性。
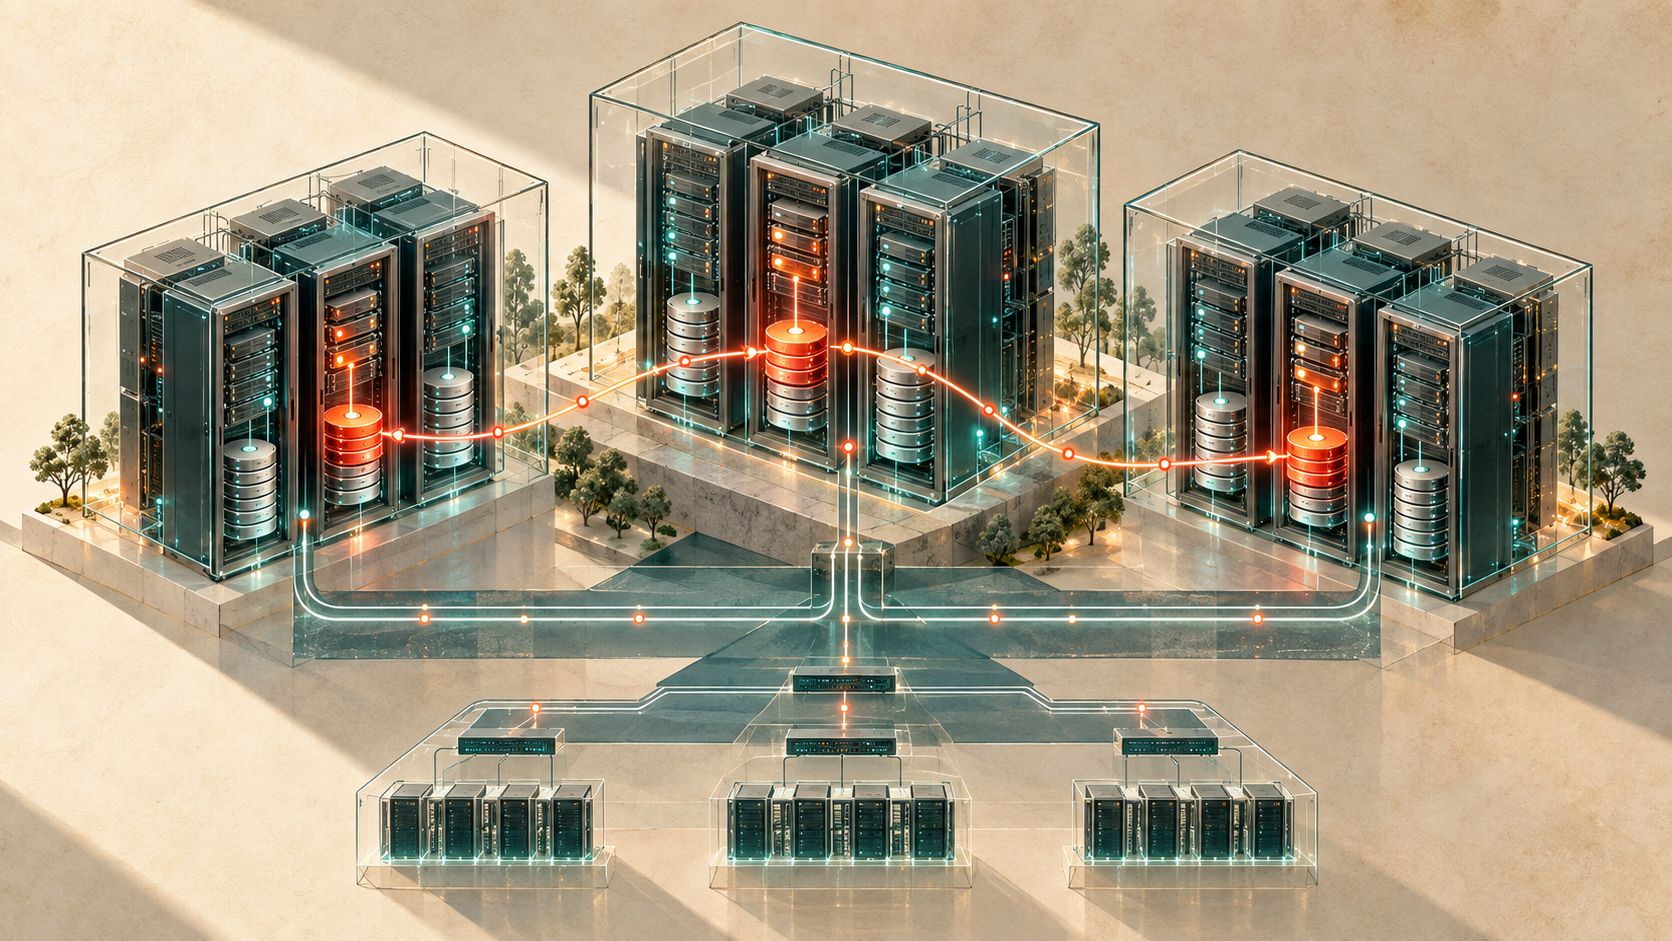
分布式存储集群有成百上千块盘,保存一个对象时,系统怎么决定它的副本或分片放到哪些设备上?如果每次都询问一个中央目录,目录可能成为瓶颈或故障点;如果把每个对象的落点都单独记录,集群扩缩容时又要维护大量映射。Ceph 的 CRUSH 算法,正是用规则、集群拓扑和输入标识计算数据放置位置的一种方法。
CRUSH 会结合对象或放置组(PG)标识、集群映射以及 placement rule,沿着描述设备层级的结构选择目标。拓扑可以表达设备属于哪个主机、机架、机房等故障域,规则则能指定应当从哪类设备中选择、需要把副本分散到哪里。客户端和 OSD 可依据相同映射计算目标位置,减少对每个对象中心化目录查询的依赖。
为什么这很重要?如果所有副本都被放在同一台机器,硬件故障就会同时带走它们。合理的 CRUSH rule 可以要求副本跨主机或机架分布,从而把逻辑冗余对应到真实故障域。集群设备加入、移除或权重变化时,CRUSH 会重新计算放置;设计目标之一是只移动必要的一部分数据,而不是把整个集群彻底洗牌。
但“算法自动放置”不代表拓扑可以随便填。若管理员把主机、机架层级描述错误,或者 rule 指向了不合适的 bucket 类型,算法就可能按错误的现实模型做出确定性选择。新增容量的 CRUSH 权重、可用设备数量、规则约束与数据副本数也必须匹配,否则可能出现无法满足放置要求的 PG 或意料之外的数据迁移。
CRUSH 还不是数据恢复或一致性协议的全部。它负责按照集群状态计算“应该放在哪里”;副本同步、故障检测、数据修复和客户端读写语义由 Ceph 的其他组件共同承担。理解它时,最好区分放置计算、实际副本状态与恢复流程,避免把所有“集群自动搬数据”的现象都归因于 CRUSH。
对于运维者,最实用的检查问题是:当前拓扑是否准确反映设备与故障域?规则是否真的要求跨越预期边界?改动权重后会迁移多少数据?CRUSH 让分布式放置变得可计算、可复现,但最终可靠性仍取决于人提供的拓扑和规则是否贴近现实。