浏览器自带 AI API:网页如何本地完成翻译、摘要和改写?
TL;DR
介绍 Chrome 浏览器内置的翻译、摘要、改写和 Prompt API,分析本地 AI 的隐私、延迟、兼容性和云端回退策略。
Chrome Built-in AI 把部分模型能力放进浏览器,由网页调用翻译、语言检测、摘要、写作和改写 API。本文解释本地推理的优势与限制、模型下载和兼容性问题,以及更现实的本地与云端混合架构。
过去,网页里的 AI 功能通常意味着:把用户输入上传到服务器,服务器调用模型,再把结果返回浏览器。浏览器只是一个界面。
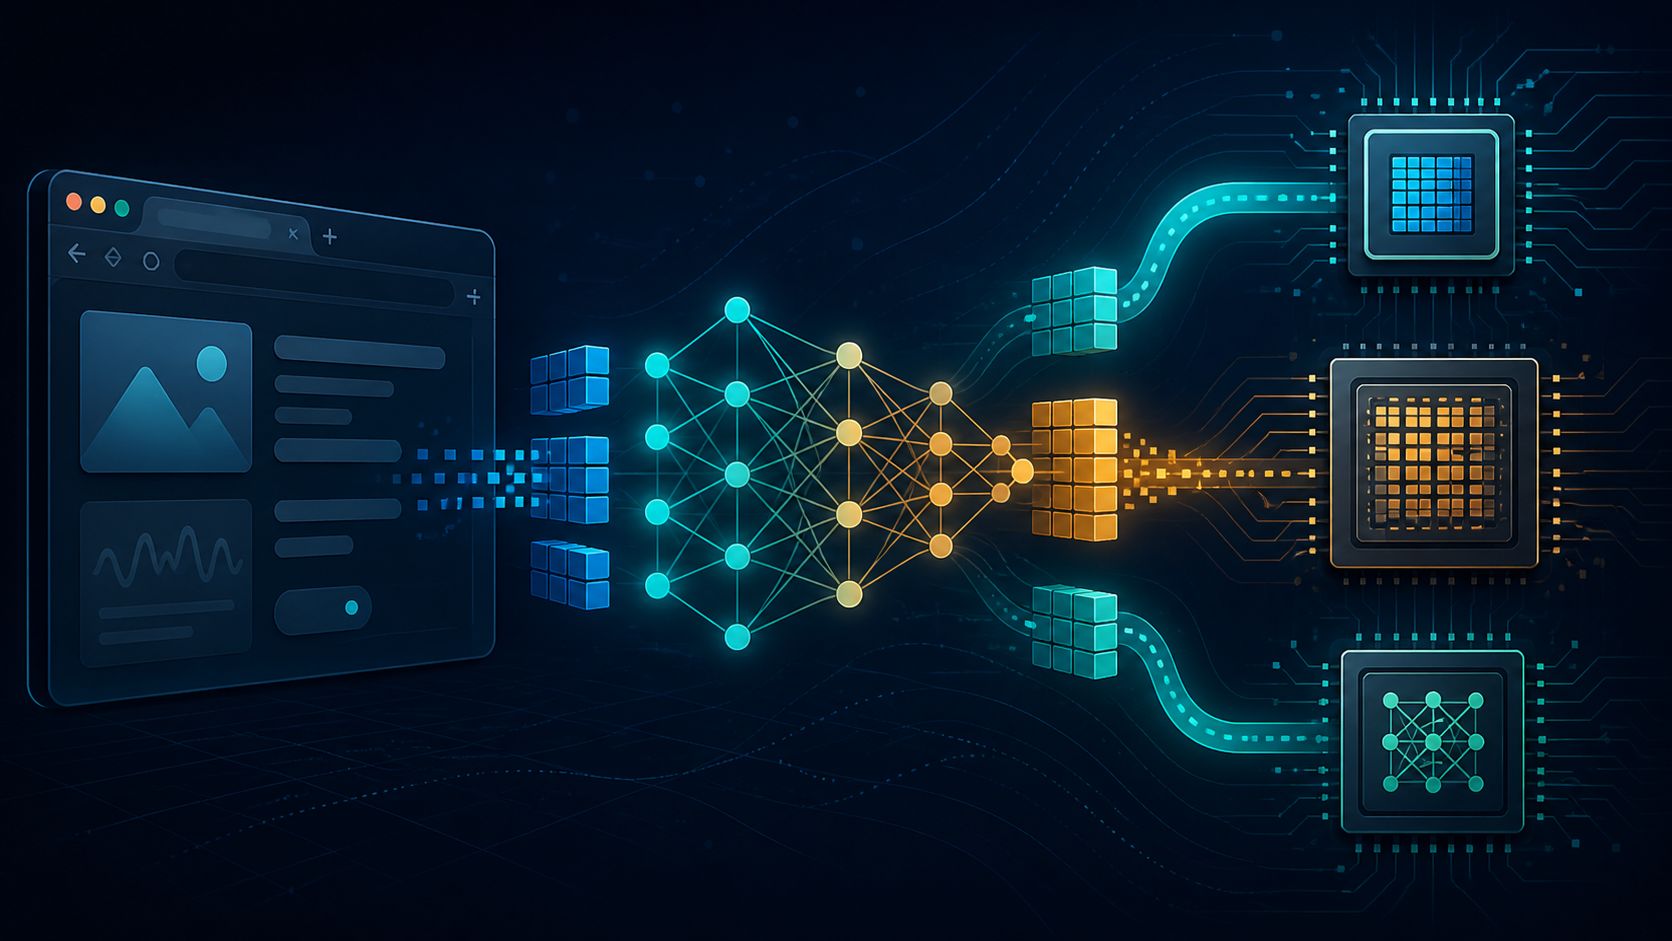
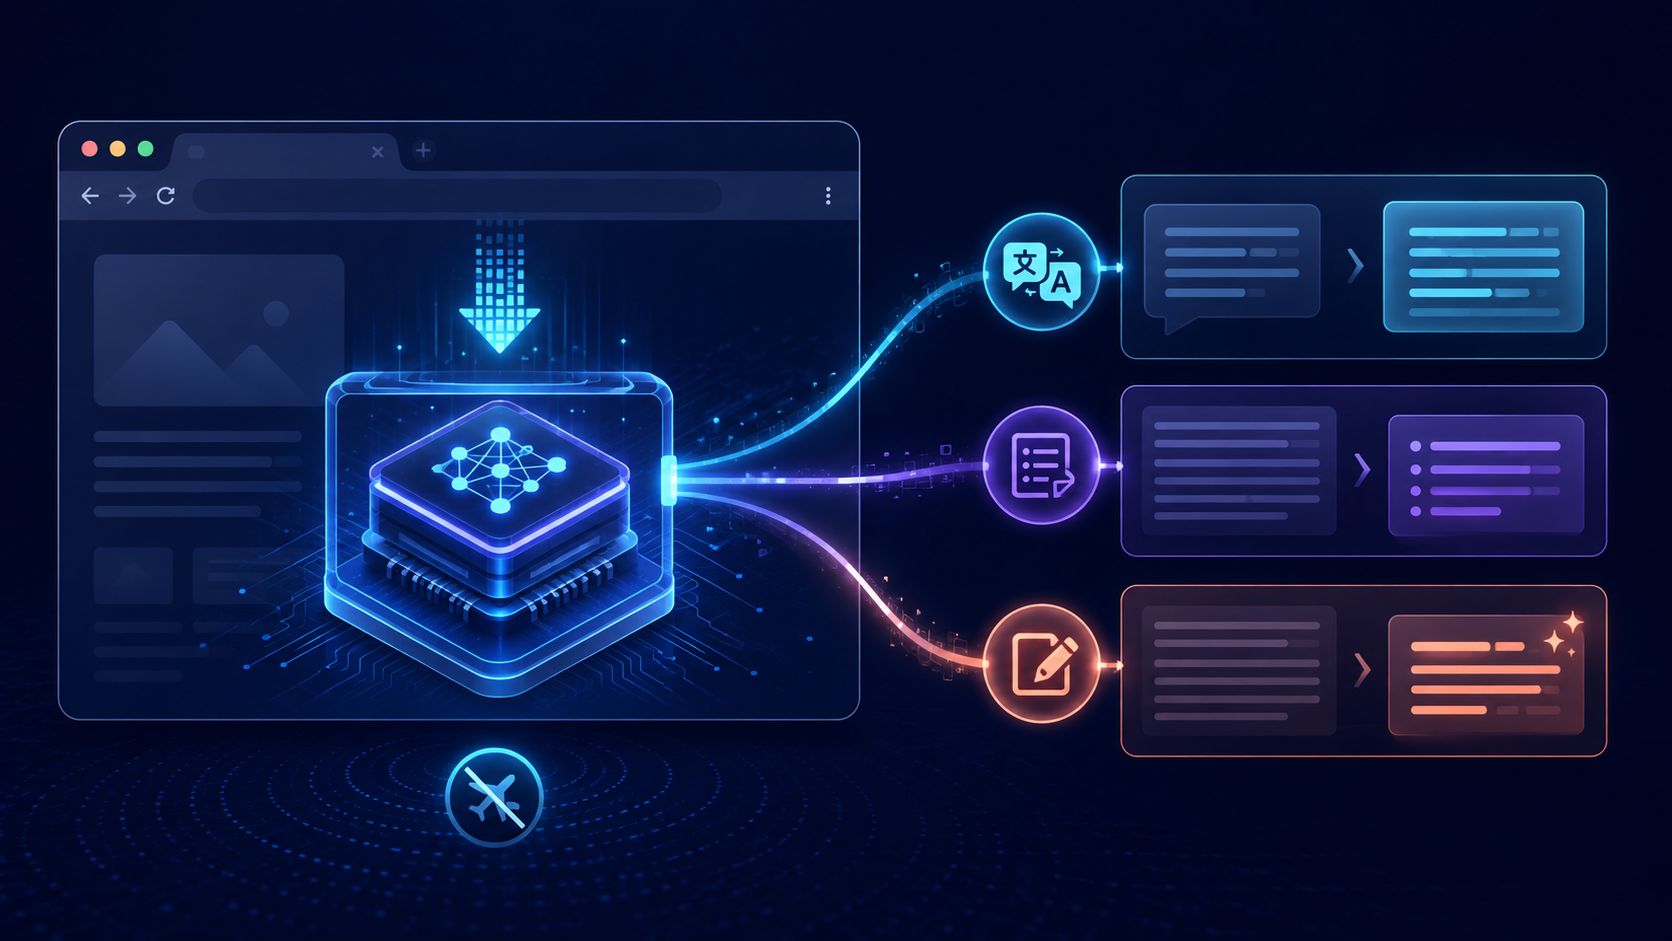
Chrome 的 Built-in AI 走的是另一条路:浏览器自己管理一部分模型和推理能力,网页通过标准化 JavaScript API 请求翻译、摘要、改写或提示任务。这样一来,网页不必为每一次简单文本处理都建立云端模型调用。
先给结论:Built-in AI 是浏览器托管的能力层
Chrome 官方文档把 Built-in AI 定义为由浏览器提供和管理的基础模型与专家模型能力。当前文档列出了 Translator、Language Detector、Summarizer、Writer、Rewriter、Proofreader 和 Prompt 等不同方向的 API,但它们的可用状态并不相同,有的已经进入稳定版本,有的仍处于 origin trial 或早期预览。Chrome Built-in AI 文档
这意味着开发者面对的不是“有没有一个 AI API”这么简单,而是三个问题:
- 当前浏览器是否支持这个 API?
- 当前设备是否满足模型运行要求?
- 这次任务适合本地模型,还是应该交给云端模型?
一组 API,解决的是不同的小问题
把这些 API 统称为“浏览器里的 ChatGPT”容易误解。它们更像一组可以嵌入网页体验的能力组件:
| API | 更适合做什么 | 不应默认它做什么 |
|---|---|---|
| Language Detector | 判断用户输入的语言 | 不等于高质量翻译 |
| Translator | 将一段文本翻译成目标语言 | 不等于专业领域审校 |
| Summarizer | 将长文本压缩成摘要、要点或段落 | 不等于事实核验 |
| Writer | 根据任务生成一段新文本 | 不等于自主完成业务流程 |
| Rewriter | 调整长度、语气或表达方式 | 不等于理解全部业务上下文 |
| Prompt | 处理更开放的文本和多模态任务 | 不等于稳定的结构化后端接口 |
例如,客服网站可以先用 Language Detector 判断用户语言,再用 Translator 把问题转成内部工作语言;文章网站可以用 Summarizer 生成“先读摘要”,而不是把整篇文章发送到服务器。
本地推理为什么有吸引力
当任务主要是文本改写、短摘要或语言检测时,本地推理有三个明显优势:
- 响应更短:输入不必先穿过网络到达远端服务。
- 边际成本更低:简单操作不必按请求数持续产生云端模型费用。
- 数据更少出网:草稿、评论或内部文本可以优先在设备上处理。
但“本地”不等于“永远可用”。浏览器可能需要先下载模型,设备可能没有足够内存或计算能力,模型也可能因为版本、地区或浏览器状态而不可用。Chrome 文档特别强调了模型下载、缓存、更新、清理和用户提示等产品问题。模型管理与使用建议
因此,网页不能把本地 AI 当成一个无条件存在的后端。更稳妥的做法是把它当成一种能力探测结果:能本地完成,就本地完成;不能完成,就降级到普通功能或经过授权的云端服务。
一个更现实的混合架构
适合生产环境的架构通常不是“本地取代云端”,而是按照任务风险和复杂度分层:
举例来说,商品评价的语法润色可以放在本地;退款资格判断则不应该只交给浏览器里的小模型,因为它可能涉及订单状态、规则版本和审计记录。
API 设计要关注会话和上下文
开放式 Prompt API 最容易遇到的问题是上下文会不断增长。网页如果把整个历史对话每次都重复发送,本地模型也会变慢、占用更多内存。Chrome 的实践文档给出了会话管理和“摘要压缩上下文”的思路:当历史过长时,先用 Summarizer 把旧内容压缩,再开启一个新会话。Session compacting 指南
这说明 Built-in AI 不是一行 API 调用就结束。开发者仍然需要设计:
- 模型第一次下载时显示什么状态;
- 用户切换设备或清理缓存后如何降级;
- 结果如何标记为机器生成;
- 失败、超时和模型不可用时怎么恢复;
- 哪些结果必须让用户确认后才能写回业务数据。
不要把“本地”误写成“绝对隐私”
文本不上传服务器,确实减少了一个数据暴露面,但网页仍然可以记录输入、结果和交互日志。模型生成的内容也可能出错、偏见或泄露用户主动输入的秘密。
因此,隐私设计至少要分三层:
- 浏览器是否把原文发送到远端;
- 网页自己的 JavaScript 是否保存或上传原文;
- 生成结果是否会被写入账户、数据库或分析系统。
只有三层都说清楚,用户才能真正知道“本地 AI”保护了什么。
一句话总结:Built-in AI 把模型能力放进了浏览器,但产品责任仍然留在网页开发者手里。