AI 搜索真正难的不是生成答案,而是维护引用链
TL;DR
AI 搜索把检索、证据筛选和答案合成放进同一条链路。本文解释引用错位、新鲜度、冲突来源、多跳问题和评估指标,说明为什么有引用的答案仍然可能不可靠。
AI 搜索把检索、证据筛选和答案合成放进同一条链路。本文解释引用错位、新鲜度、冲突来源、多跳问题和评估指标,说明为什么有引用的答案仍然可能不可靠。
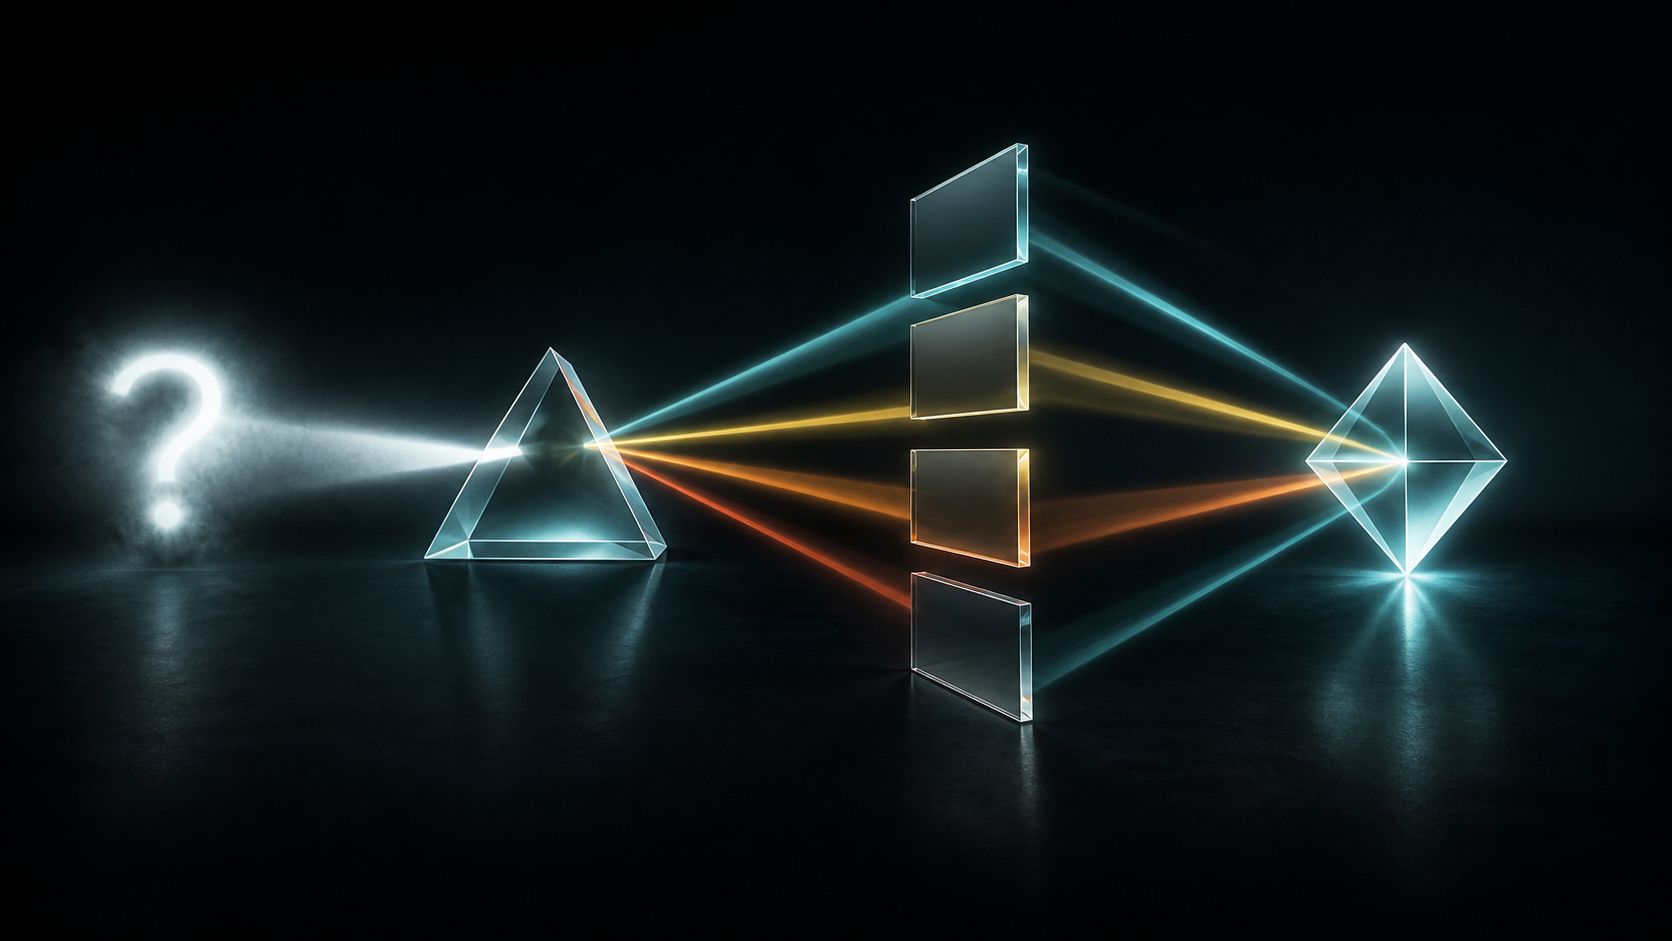
传统搜索把用户带到网页,AI 搜索则试图直接给出结论。表面上看,这只是把“十条链接”压缩成一段话;实际上,系统必须在生成前完成检索、筛选、交叉核对和证据绑定,否则回答会显得流畅,却没有办法说明每句话究竟来自哪里。
AI 搜索不是一个更大的搜索框
一个可用的 AI 搜索系统至少包含四个环节:理解问题、找候选资料、选择证据、组织答案。检索阶段追求召回,尽量不漏掉相关资料;答案阶段追求精确,不能把十个来源中的细节拼成一个没有出处的新事实。
传统搜索的排序结果可以把判断权交给用户。AI 搜索把判断提前做了,所以“引用是否真的支持这句话”变成了核心质量指标。
有引用,为什么仍然可能错
最常见的错误不是完全没有来源,而是引用错位。回答说“产品在某日期上线”,链接却只证明了产品存在;回答说“研究发现有效”,引用页面只描述了实验方法;回答合并了两篇文章的结论,却把引用放在段落末尾,让读者误以为一个来源支持全部内容。
还有三种时效问题。第一,网页已经更新,但搜索索引还保留旧版本。第二,页面中的价格、库存、政策和活动时间本来就会变化。第三,来源之间存在冲突,模型为了让答案连贯,可能悄悄选择其中一个,却不告诉用户冲突存在。
因此引用不是装饰,而应该绑定到最小的可验证主张。一个好的答案会把“事实”“推断”和“建议”分开:事实链接原文,推断说明推理过程,建议则交代适用条件。
新鲜度不是简单看发布日期
发布日期只说明页面何时发布,不一定说明页面里的事实何时生效。比如 API 文档可能多年不变,体育赛程和汇率却需要接近实时的数据。系统应给不同类型的事实设置不同的新鲜度策略:规范和基础概念可以长时间缓存,价格、政策、库存、比赛结果则需要重新验证。
多跳问题尤其容易出错。用户问“某地区现在还能否申请某服务”,答案可能需要把资格条件、地区范围、开放时间和最新公告拼起来。每一跳都要保留证据,否则最后一句看似自然的结论,可能没有任何单一页面真正支持。
怎样评估 AI 搜索,而不是只看回答像不像人
- 检索召回率:相关资料是否被找进候选集合。
- 引用精确度:每个引用是否真的支持相邻主张。
- 引用覆盖率:答案中有多少重要主张具备证据。
- 新鲜度:对易变化事实,系统是否在有效时间内重新验证。
- 冲突表达:来源不一致时,是否明确告知用户而不是强行统一。
- 可追溯性:用户能否从结论回到原文片段,而不是只看到一个站点名称。
这也改变了内容生产方式。对 AI 搜索友好的页面不只是堆关键词,而是清楚表达定义、条件、时间范围和证据边界,让机器能够把一个完整主张与它的来源绑定起来。
Google 在 2026 年 I/O 中继续把多模态输入、AI Search 和引用式答案放在一起讨论,说明搜索正在从“返回文档”转向“组织证据”。但越接近答案引擎,系统越需要像研究助理一样保留证据链,而不是像聊天机器人一样只追求语气自然。
进一步阅读:Google I/O 2026:AI Search 与多模态模型、OpenAI 内部数据 Agent 的上下文设计。