互联网被 AI 内容淹没后,下一代 AI 会变笨吗?
TL;DR
当生成模型不断学习前代模型制造的文字和图片,罕见细节可能先消失,错误则可能逐代累积,这种现象被称为模型坍缩。本文用反复复印照片的比喻解释其机制、适用边界,以及为什么真实人类数据会变得更加重要。
当生成模型不断学习前代模型制造的文字和图片,罕见细节可能先消失,错误则可能逐代累积,这种现象被称为模型坍缩。本文用反复复印照片的比喻解释其机制、适用边界,以及为什么真实人类数据会变得更加重要。
想象一张清晰照片被复印一次,再拿复印件继续复印。最初只是阴影里少了一点层次,几代之后,浅色纹理消失,轮廓变硬,灰尘却被一遍遍放大。如果生成式 AI 主要学习其他 AI 生成的内容,也可能出现类似退化。
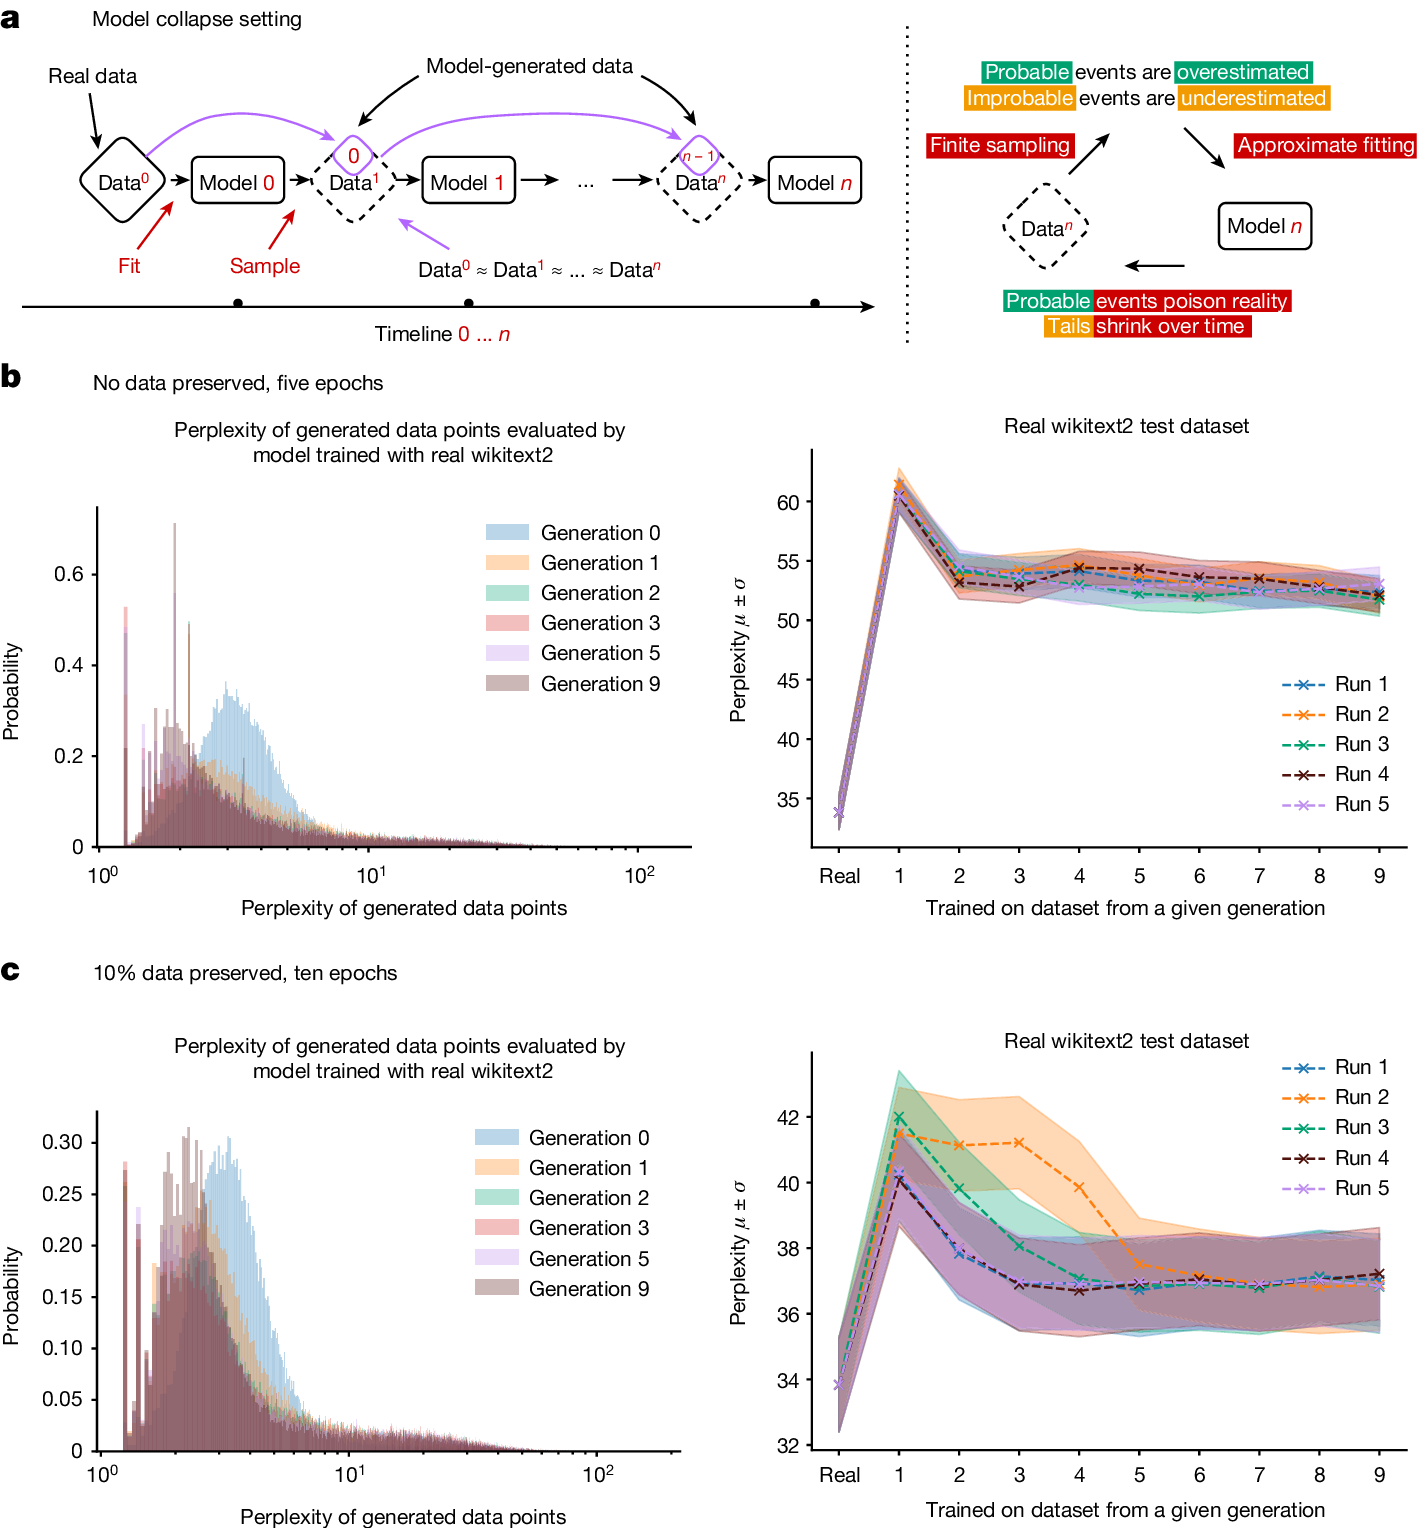
研究者把这种现象称为模型坍缩:模型的输出进入下一代训练集后,误差和偏好沿着反馈回路积累,最终让模型学到的分布逐渐偏离真实世界。
最先消失的往往不是常识
假设真实世界有一百种花,常见的十种占据大多数照片,稀有花只出现几次。第一代生成模型会更擅长重现常见花,对稀有花的描述则不够准确。如果下一代主要学习第一代生成的图片,稀有花所占比例可能进一步下降。循环几次后,训练数据看起来越来越整洁,却只剩下少数典型模样。
2024 年发表在 Nature 的模型坍缩研究指出,在递归使用模型生成数据的过程中,原始分布的“尾部”信息会先消失。所谓尾部,就是罕见表达、少数案例和不常见组合。最后受损的不只是多样性,模型对现实的整体理解也可能变形。
这解释了为什么“生成内容语法正确”不足以证明它适合训练。大量平均化、模板化的内容,会让下一代模型更擅长生产平均答案,却更难覆盖真实世界的复杂边角。
这不等于合成数据都有毒
模型坍缩讨论的是不加区分地递归使用生成数据,并不意味着所有合成数据都会伤害模型。经过验证的合成数据可以补齐稀缺案例、模拟危险场景,或为有明确正确答案的任务提供大量练习。
关键区别在于有没有锚点。真实数据、人工审核、规则验证或可执行环境,都能帮助系统判断生成样本是否保持了目标分布。例如,用程序生成算术题并自动核对答案,比让模型自由编题再相信它可靠得多。
Nature 论文的实验也显示,保留一部分原始数据能够减缓退化。这不是一个简单的“AI 数据比例超过多少就必然崩溃”的开关;结果取决于数据质量、采样方法、任务、模型和真实数据是否持续进入。
模型坍缩与另外两个概念不同
灾难性遗忘发生在模型继续学习新任务时,旧能力因参数更新而受损;数据投毒是攻击者故意加入恶意样本;模型坍缩则可以在没人攻击、任务也没改变的情况下发生,原因是模型不断学习自己或前代模型对世界的近似。
三者都可能表现为能力下降,但诊断方式不同。把它们混在一起,会导致错误的治理措施。
人类内容为什么反而更值钱了
如果网络上越来越多文章、评论和图片由 AI 批量生成,未来收集训练数据时就更难判断哪些是直接来自人类经验,哪些是模型对旧数据的再加工。真实访谈、实验记录、原始照片、经过核验的专业资料和明确记录来源的数据,会成为重要锚点。
内容平台也需要保存来源与生成过程,而不是只看表面质量。数据集建设者可以进行去重、生成内容识别、来源分层和人工抽样;模型训练者则要测量少数案例是否正在消失,而不只关注平均分。
对普通创作者来说,这并不表示人与 AI 必须二选一。AI 可以帮助整理和表达,但亲身观察、独立观点、真实案例与可验证资料才是内容最难被复制的部分。
互联网不会因为出现大量 AI 内容就在某一天突然“坏掉”。更可能的风险是一种缓慢同质化:大家说得越来越顺,却越来越像。防止模型坍缩的核心,也因此不是排斥所有合成内容,而是持续让真实世界进入数据循环,并保住那些不常见但重要的声音。